Eric 老師的實務分享筆記
除了正式課程,Eric 老師在群組裡也隨手分享他手上正在做的專題、看到別人程式碼時的技術判斷、還有他自己的 AI 開發方法論。這裡把 2026-09-14 到 09-20 之間的七則分享,以及 2026-10-03 晚間的兩則實作分享、10-06 的架構流程簡報,以及 10-10 的 Hermes × Hindsight 記憶架構升級,整理成短筆記形式的小課。
第 1 堂
OpenSpec:BDD 到 SDD 的敏捷工程
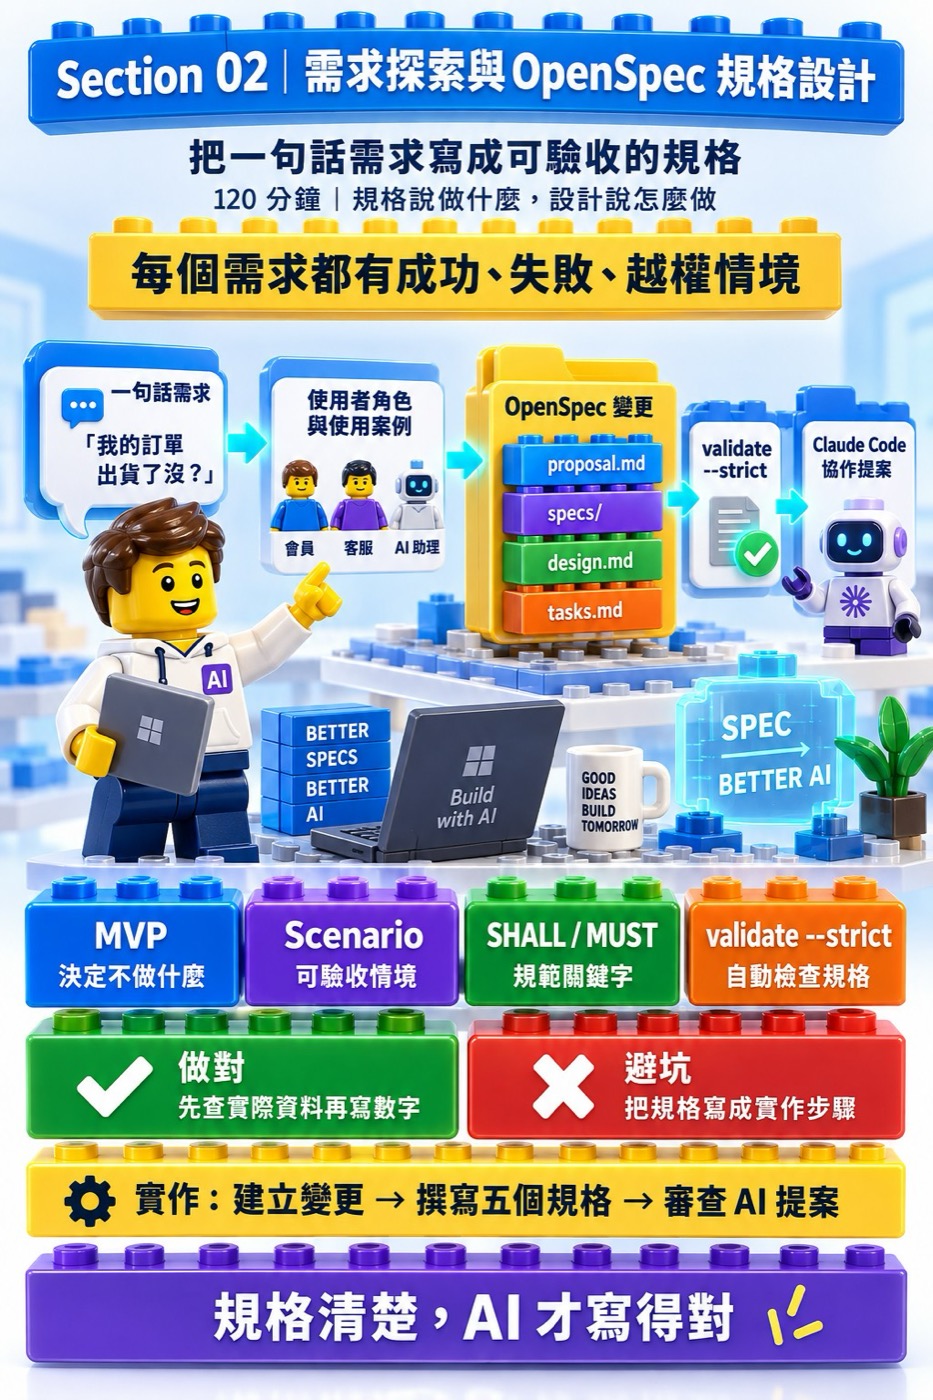
Eric 老師錄了一支 YouTube 影片,示範怎麼用 AI 做 BDD(行為驅動設計)到 SDD(規格驅動設計)的敏捷工程,這裡摘要他當天在群組裡補充的說明。
採敏捷方式持續建立開發規格,再依 task 交給 AI Agent 產生與修訂程式碼——「如此才能進行系統長時間的開發與維運」。
Eric 老師坦言:「其實 Spec 建立的確會變成詳細與繁瑣。」他的解法是自訂軟體工程的 agent skills(透過 Intent 匹配),採用分層分離架構,讓 AI 在 Spec 規範中生成的程式碼有明確邊界,藉此節省維運時的時間與 Token。
他認為過去程式設計師被強調的能力多半只是「工具定義」層次的技術(Skill),軟體工程架構才是通用概念——AI 取代掉大部分技術門檻之後,跨領域的人反而有機會把自己的領域知識轉換成軟體工程知識。
OpenSpec 進行 BDD 到 SDD 的 agile 工程說明(R5GtmfisZJI)。
第 2 堂
TDX 高雄 EV 充電樁:NLP × Function Calling
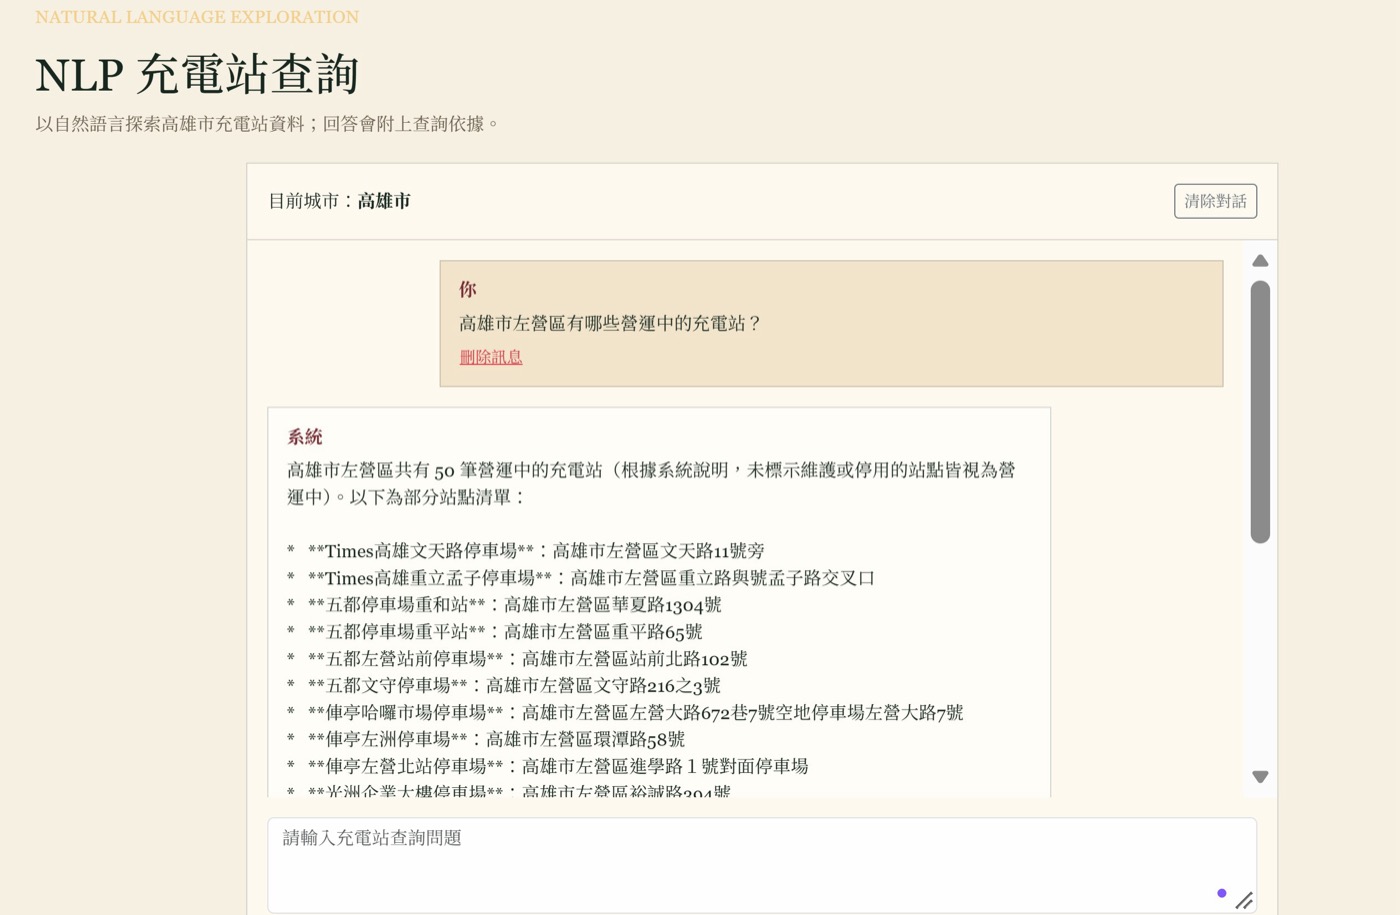
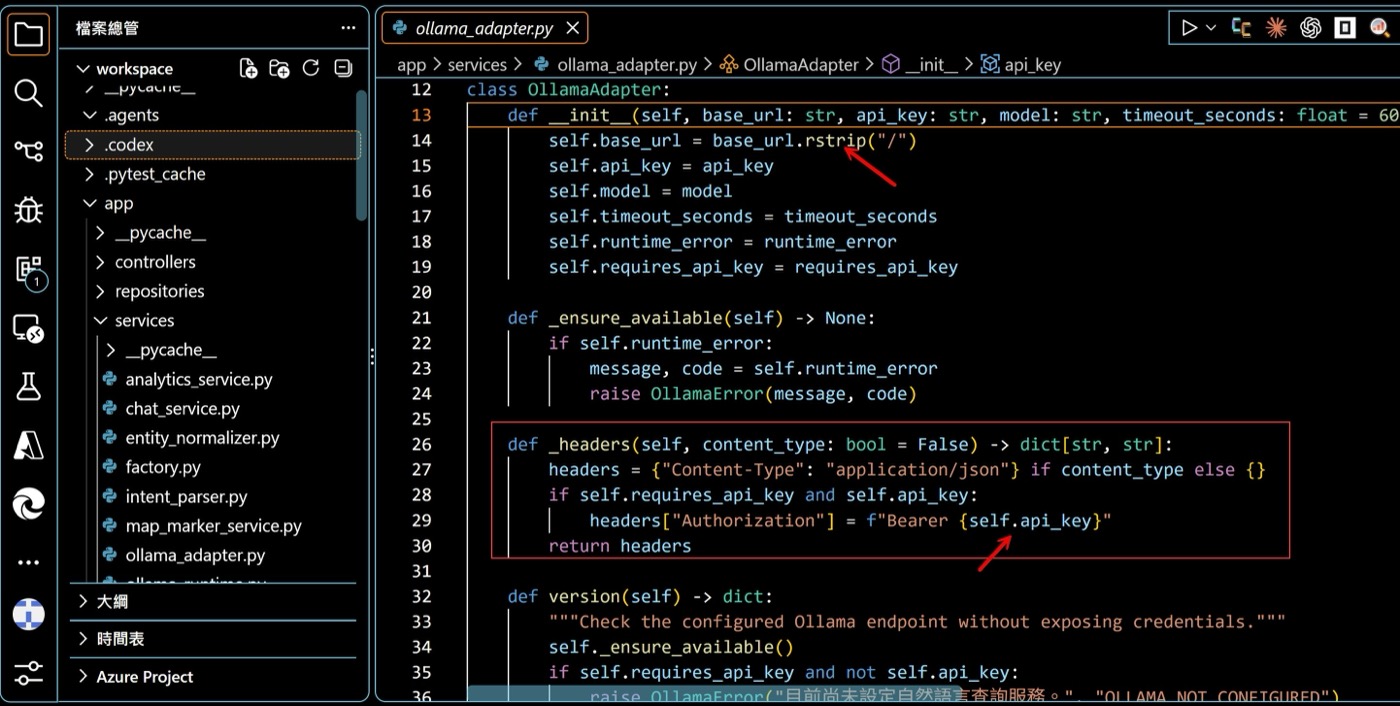
Eric 老師用 codex 驅動 gpt-5.6 luna,延伸整合 TDX 平台的高雄市電車充電樁資訊服務,並用 ollama 配置 apikey 指向雲端 gemma4:31b-cloud 做 NLP 意圖解析,再透過 function calling 查資料庫。
他的原話:「第一次 Changes 中的 Task 明明有執行完成,但 ollama 服務功能卻不存在?我整個系統程式碼 Code Review 之後發現環境變數與功能都沒有生成,難怪 SSE 不存在。得重新在下一個新的 changes 才能補上去完整的服務!」他的結論是「codex+gpt 5.6 luna 在發呆降智」。
應用系統自己送出 HTTP Request Header,帶 apikey 呼叫 Google Gemma 4 開源模型做 NLP(自然語言解析 Intent and Entity),把回應內容交給 function calling 轉成 SQL 語法進行資料存取;原則上 gpt 5.6 不需要調用任何工具,只要能把需要的程式語言生成出來即可。
「平時我不太用這樣的模組,我都是使用 claude,除非帶學員上課使用才會用其他模組。」
第 3 堂
Spring Bean Singleton 執行緒安全筆記
這是一段純文字討論——Eric 老師看到一支影片裡的 Spring Bean 程式碼,判斷它在併行環境下會出問題,順手寫了一段完整的分析,還在看完影片後修正了自己第一時間的判斷。
這支程式用 Spring Framework Bean(Component)設計架構,透過 Autowired 做依賴注入,直接把元件交給 Controller 操作,沒有架構 Service 層處理 Transaction readonly 與非同步非阻塞配置——「面對併行時一定會出問題」。
他先判斷這是讀取功能,若只跟資料一致性有關,應該是 ACID 的 Isolation 問題、跟 Thread Safe 無關,只要下達 @Transactional readonly 就好。
看完影片後他修正判斷:影片沒提到的前提是這個 Spring Bean 有沒有定義 Life Cycle Scope,沒定義就會預設為 Singleton,多個請求會共用同一個物件,定義在類別層級的變數(Data Field)就會因併行存取互相改寫、造成衝突。
把定義在 class level 的 Data Field(透過 Autowired 注入的元件)改成用 execute method 參數注入(區域變數架構),就能解決併行衝突問題。
第 4 堂
台塑 RAG 知識庫(知盾 ZhiDun)
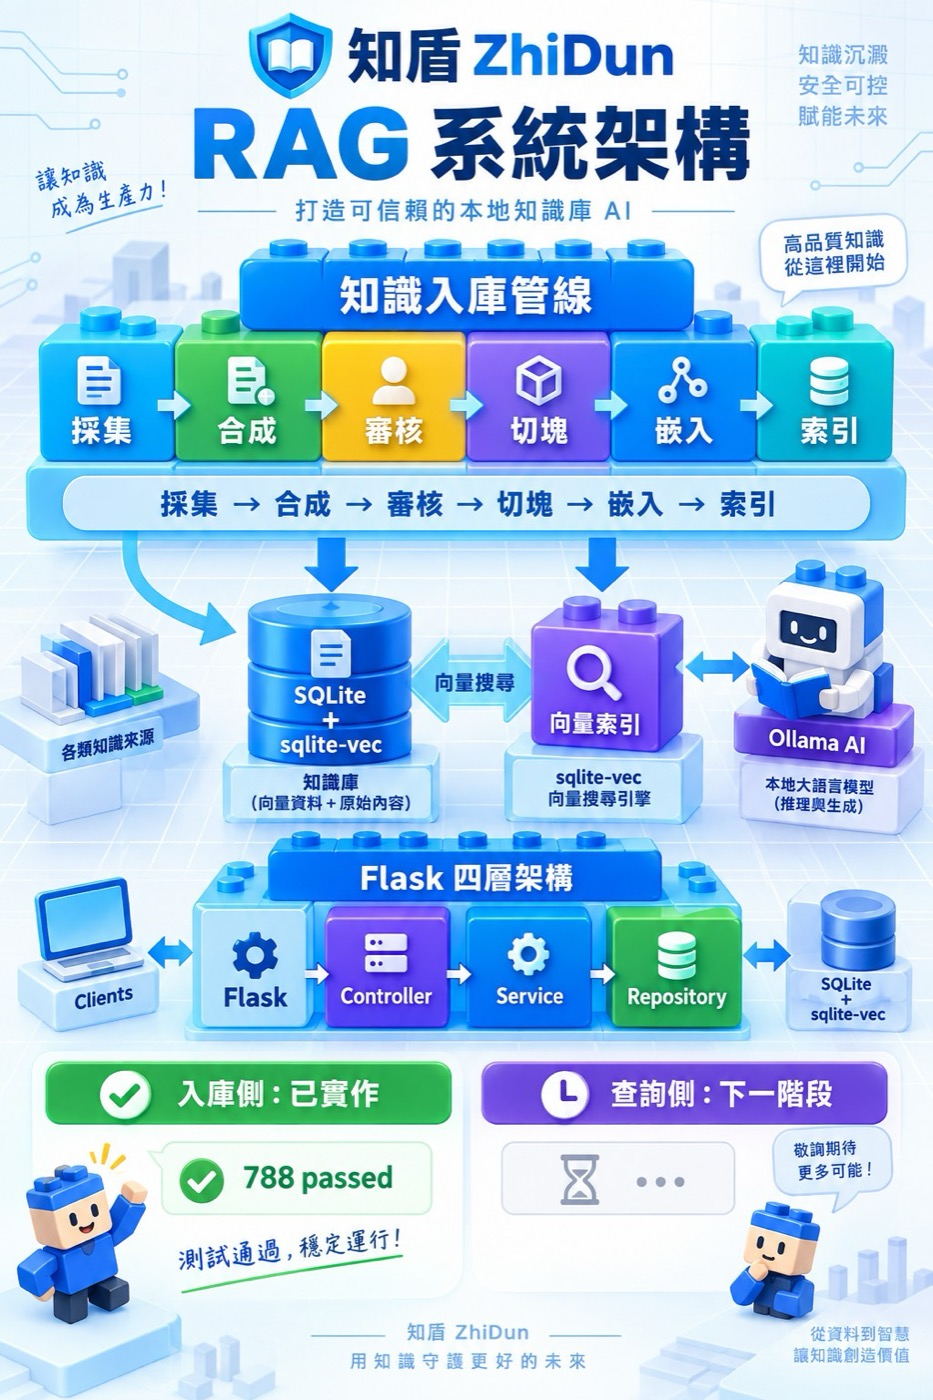
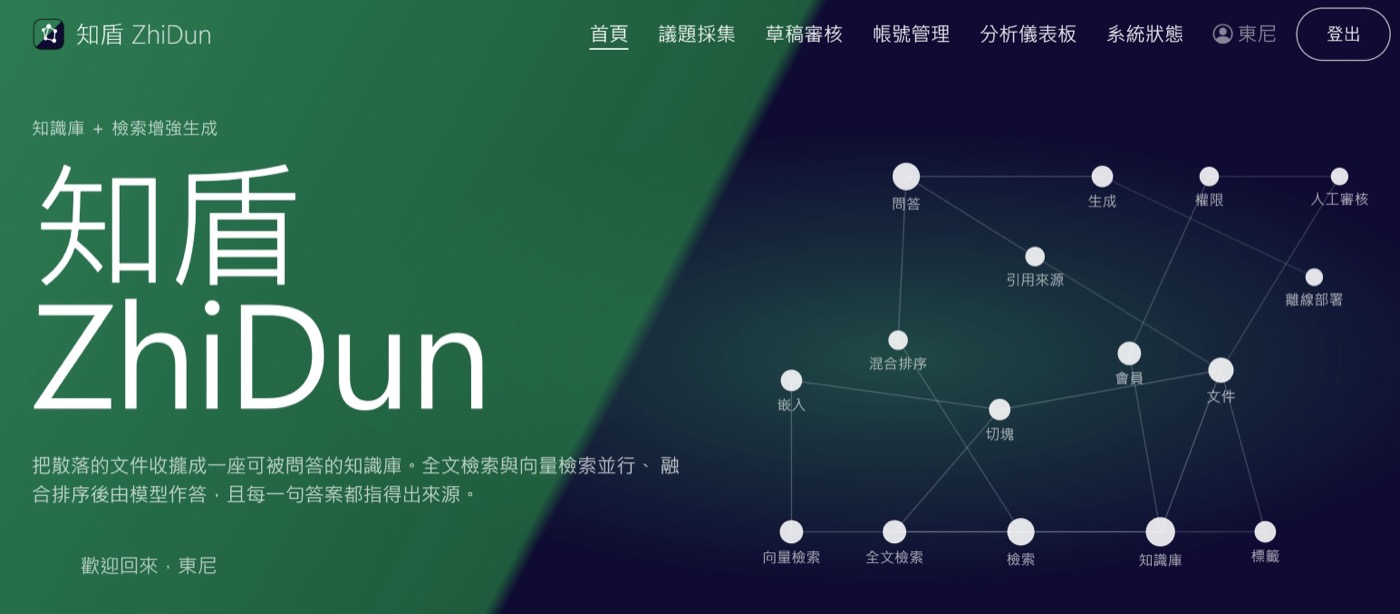
Eric 老師晚上在帶台塑設備工程師建置部門的 AI 智能諮詢+RAG 知識庫應用,系統名稱是「知盾 ZhiDun」,這一輪完成了入庫端的階段設計。
採集 → 合成 → 審核 → 切塊 → 嵌入 → 索引。資料存進 SQLite + sqlite-vec(知識庫,向量資料+原始內容)與向量索引(sqlite-vec 向量搜尋引擎),搭配 Ollama AI 做本地大語言模型的推理與生成。
Clients → Flask → Controller → Service → Repository → SQLite + sqlite-vec。入庫側已實作,「788 passed,測試通過,穩定運行」;查詢側是下一階段才做。
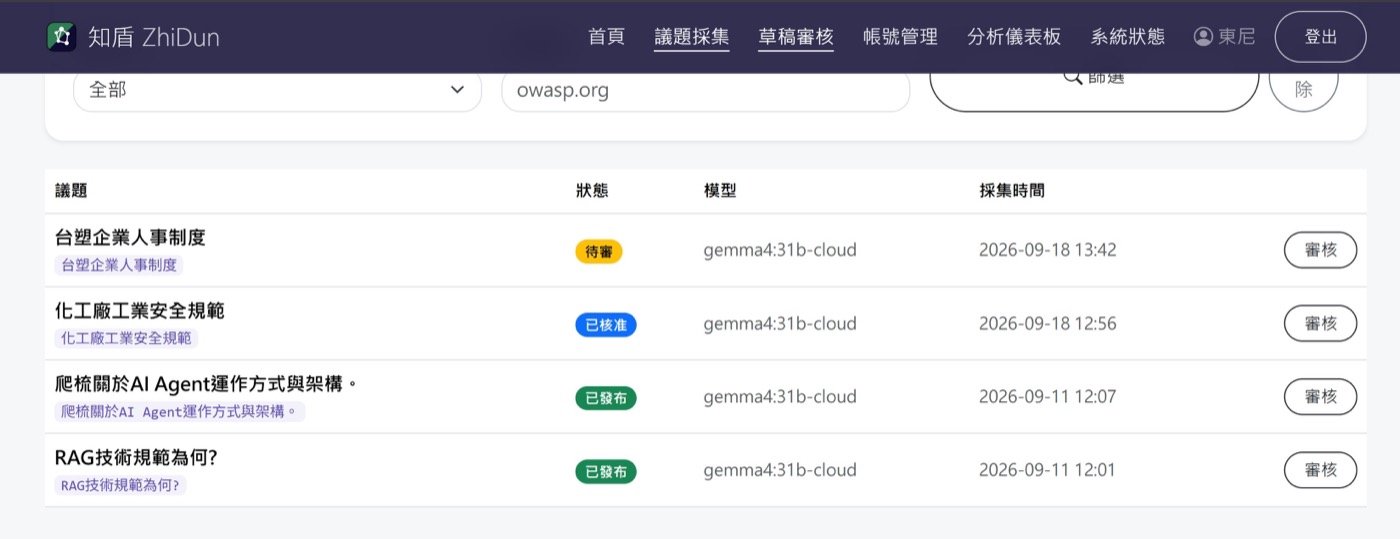
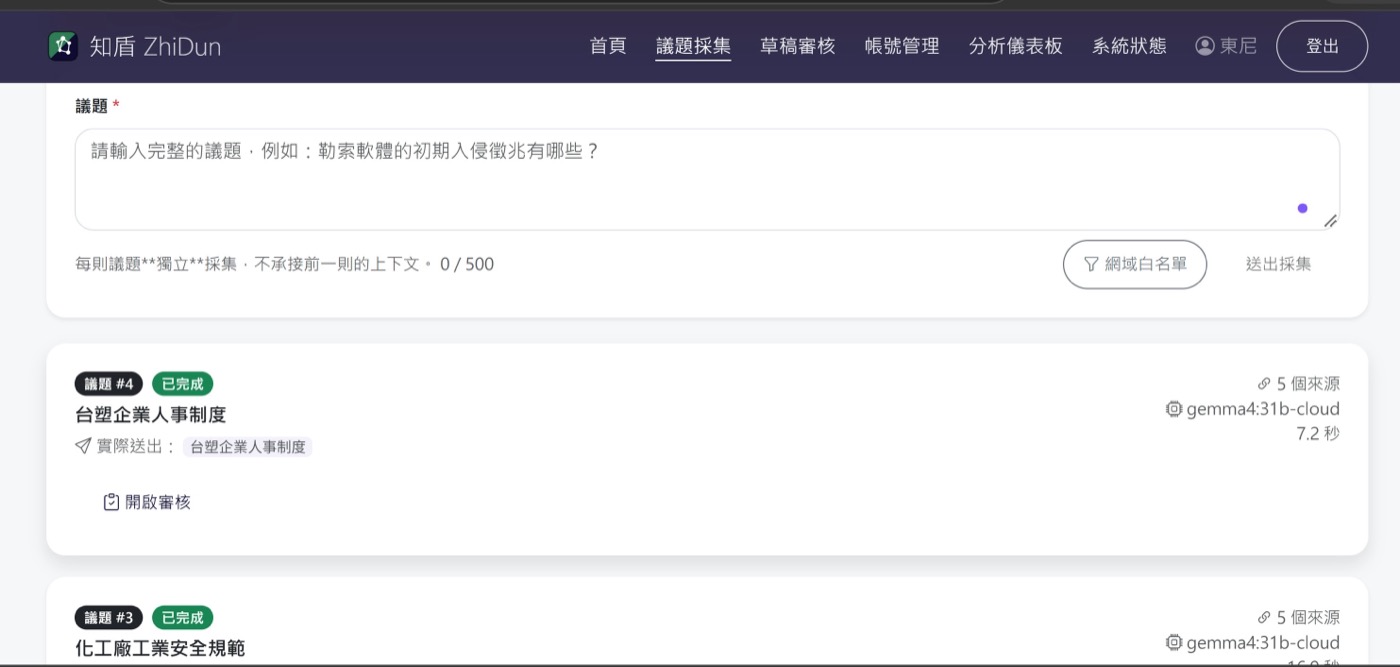
議題採集後台可以看到「台塑企業人事制度」「化工廠工業安全規範」等議題,狀態欄位分待審/已核准/已發布,模型統一用 gemma4:31b-cloud。
Eric 老師補充:「RAG 2.0 逐步帶入,會在後面階段引入」,代表這套系統還在往前演進,不是一次性完工的展示品。
第 5 堂
AI 全自動化教學影片製作工作區
Eric 老師分享他怎麼用 AI 全自動化做教學影片:從掃描課綱大綱、自動建構範例章節,到截圖、寫講義、做海報、配音、剪字幕,全部串成一條自動化管線。他形容一個章節的工作量「近乎一本 500 頁厚度書籍」的規模。
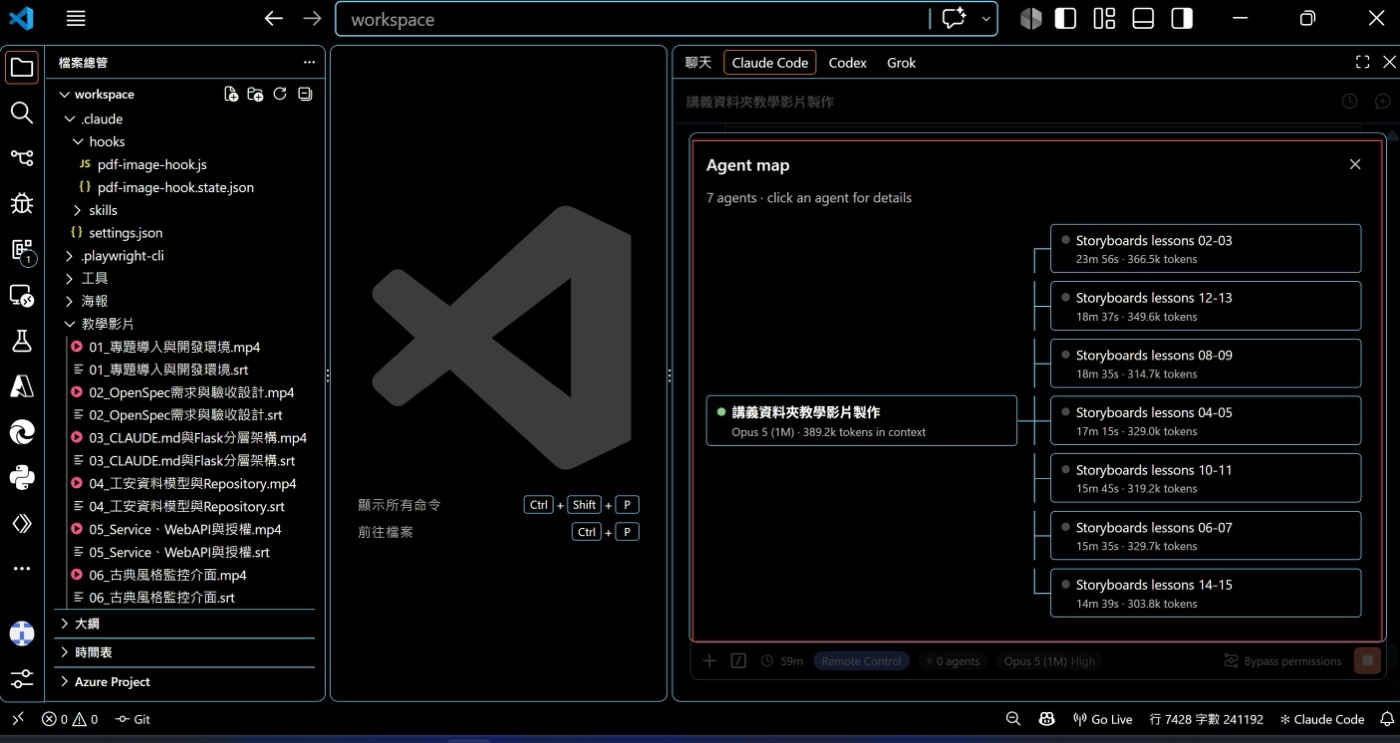
Agentic AI 自動化(agent skill 與 Hook)掃描課綱大綱 → 依 CLAUDE.md 與 skills 自動建構範例章節專案 → E2E 檢核與自動模擬操作系統並截圖,作為講義素材依據 → 閱讀技術內容逐一製作講義(md 與 pdf)→ 透過 Hook Listener 事件,把講義檔案自動 Connector 到 ChatGPT 做海報製作。
用 Claude Code 的「Agent Teams(代理團隊)」驅動自訂的語音生成 skill 與字幕產生器,整合截圖、字幕檔、TTS 與操作範例錄製,完成教學影片。
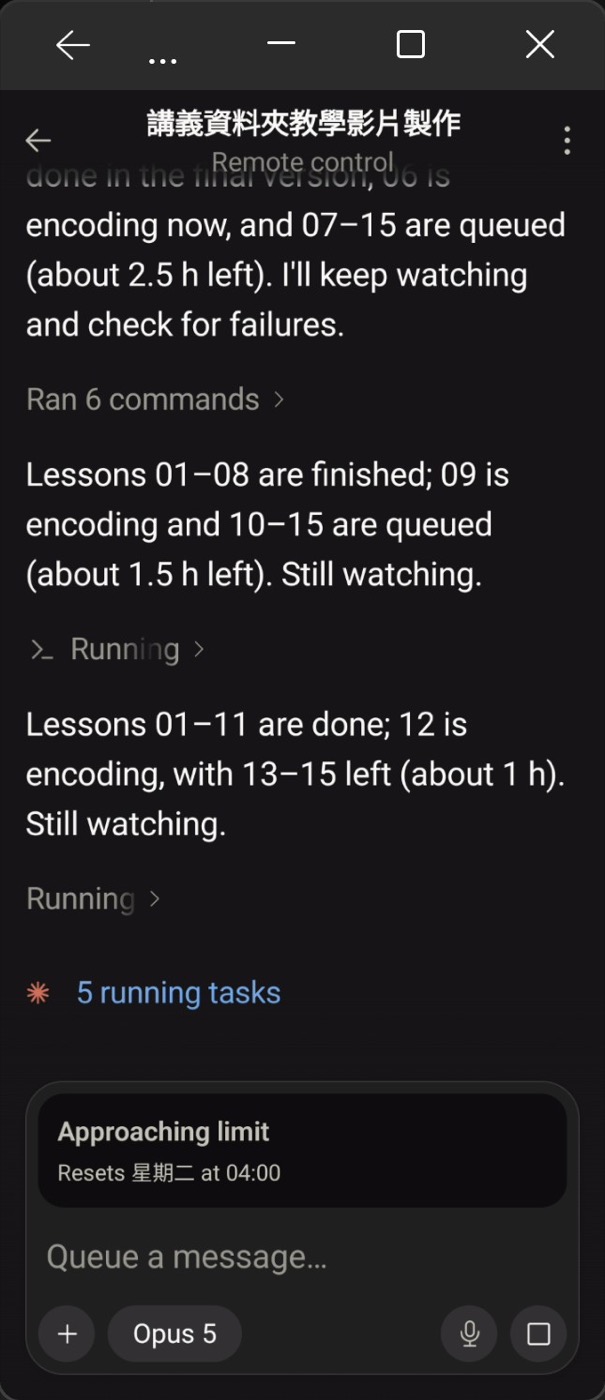
一個約十五章 30 小時的議題,完整設計建置與生成十五個章節,近乎六小時的教學影片,「一氣呵成全自動化,但往往需要跑上一整天的時間」——他形容自己「只負責拿個手機遠端監控即可」。
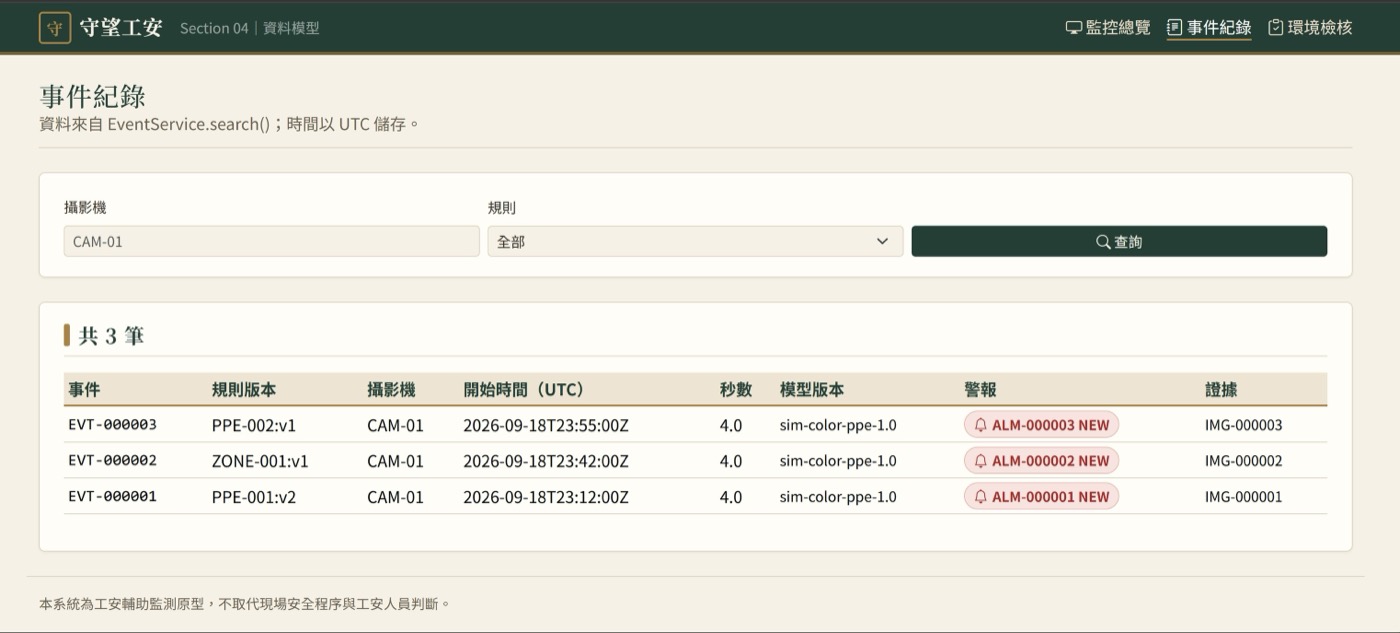
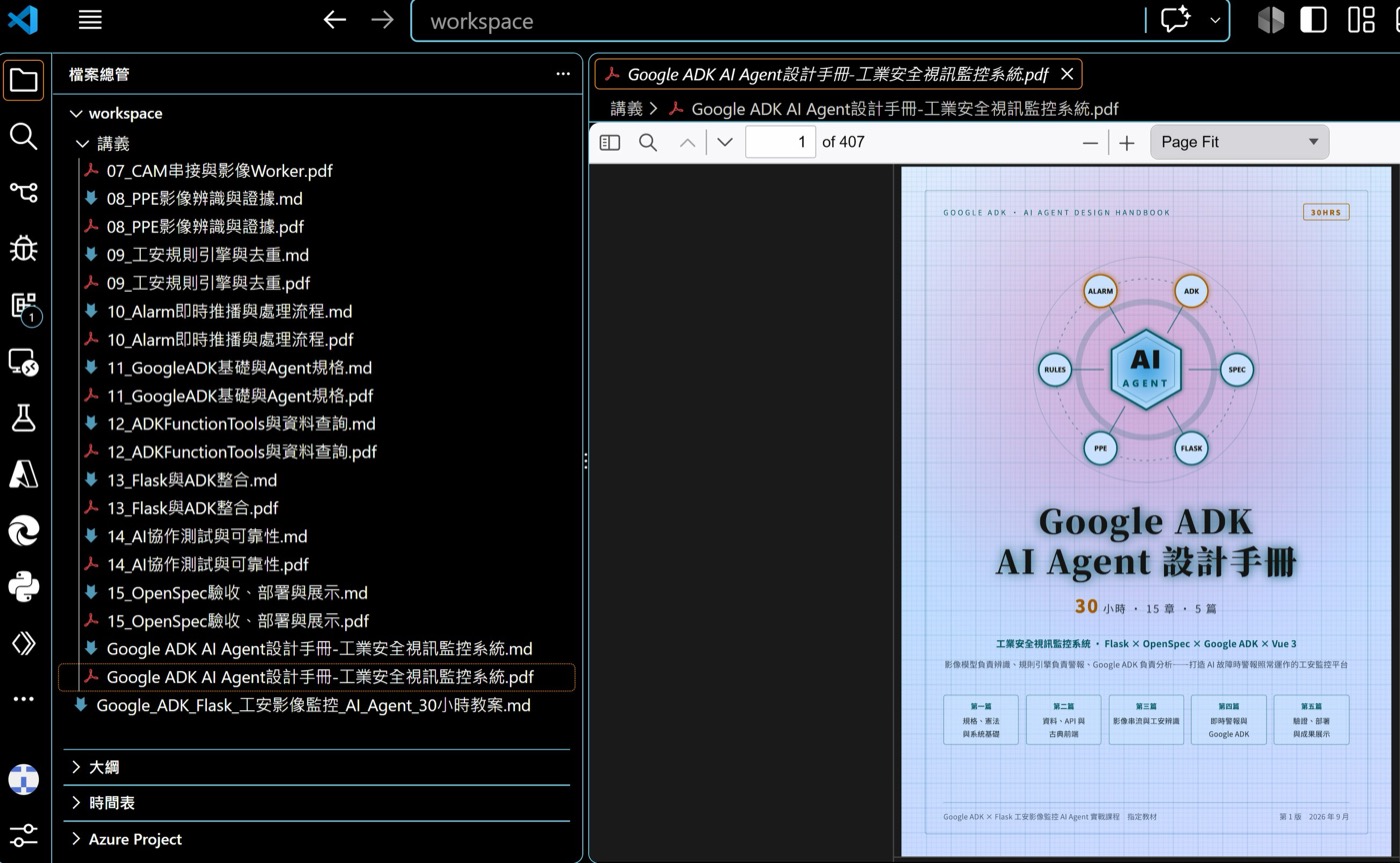
從截圖看,同一套工作區同時也在跑「工業安全視訊監控系統」的 30 小時教案(Google ADK AI Agent 設計手冊),代表這套自動化管線不只做一門課,是可以重複套用的模板。
第 6 堂
數位孿生遠端照護系統
Eric 老師分享一套數位孿生的遠端照護系統,包含韌體程式、雲端服務、監控台系統,並整合 LINE Bot Webhook Web API Service,四套模組合併運行,全部由 Agentic AI 架構 Nocode 完成。
他的原話:「除了要能說服自己相信自己可以駕馭 AI 以外,且要讓 AI 可完全說明系統架構與程式碼 Infra,並且完全符合 CICD 安全性與佈署。」
「這一段影片甚長,其中談論的不只是系統功能,而是需要將系統運行架構與核心規範完全解說清楚的」——包含一段自審與操作的說明。
數位孿生遠端照護系統(Hff5gwb2eSg):韌體、雲端服務、監控台、LINE Bot 四套模組整合運行。
第 7 堂
Harness 工程+SDLC 工程播放清單
Eric 老師在自我介紹的第一天,就分享了一個七段影片的播放清單,把目前的 Harness 工程架構以及安全性的 Hook 講過一輪,也是他規劃的 Python AI Agent 30 小時課程的先導內容。
七段影片,主題是「目前的 Harness 工程架構以及安全性的 Hook 全部談上來」。
他的原話:「我有規劃一個 Python 30 小時(15 個 Section Harness 加上 SDLC 工程的完整課程),線上影片我想逐一放給大家慢慢看,且有完整的範例與講義在逐一分享給大家。總希望在 Vibe coding 架構即使不是 IT 工程師,亦有機會進入駕馭 AI 開發的領域。」
Harness 工程+SDLC 工程播放清單(PLCXv8LDLrtzI),共七段影片。
第 8 堂
Hermes Agent 串 LINE Bot:用手機聊天驅動 AI 助理
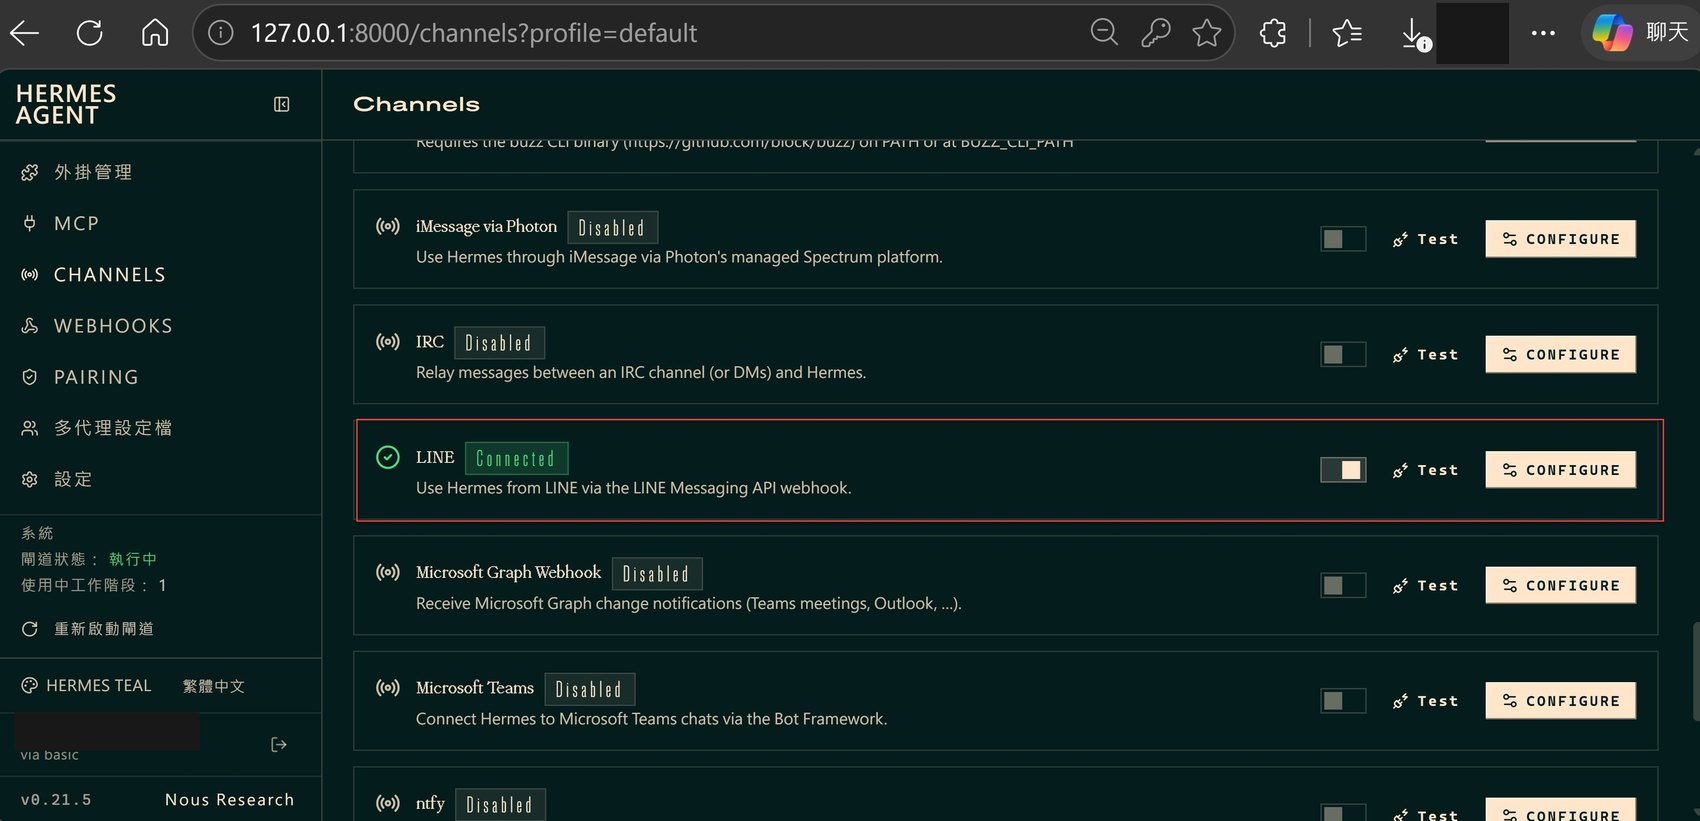
Eric 老師上完一整天的線上開發課,空檔把 Hermes Agent(Nous Research 開源的 AI 助理,截圖版本 v0.21.5)串到自建的 LINE Bot。從截圖可以看到本機管理介面(127.0.0.1:8000)的 Channels 頁,LINE 這一列顯示 Connected。
透過 LINE App 跟 Hermes 聊天、下達工作指示、查核進度;老師說 Hermes 可以自我訓練與提升,接下來預定開始「操練小助理」。
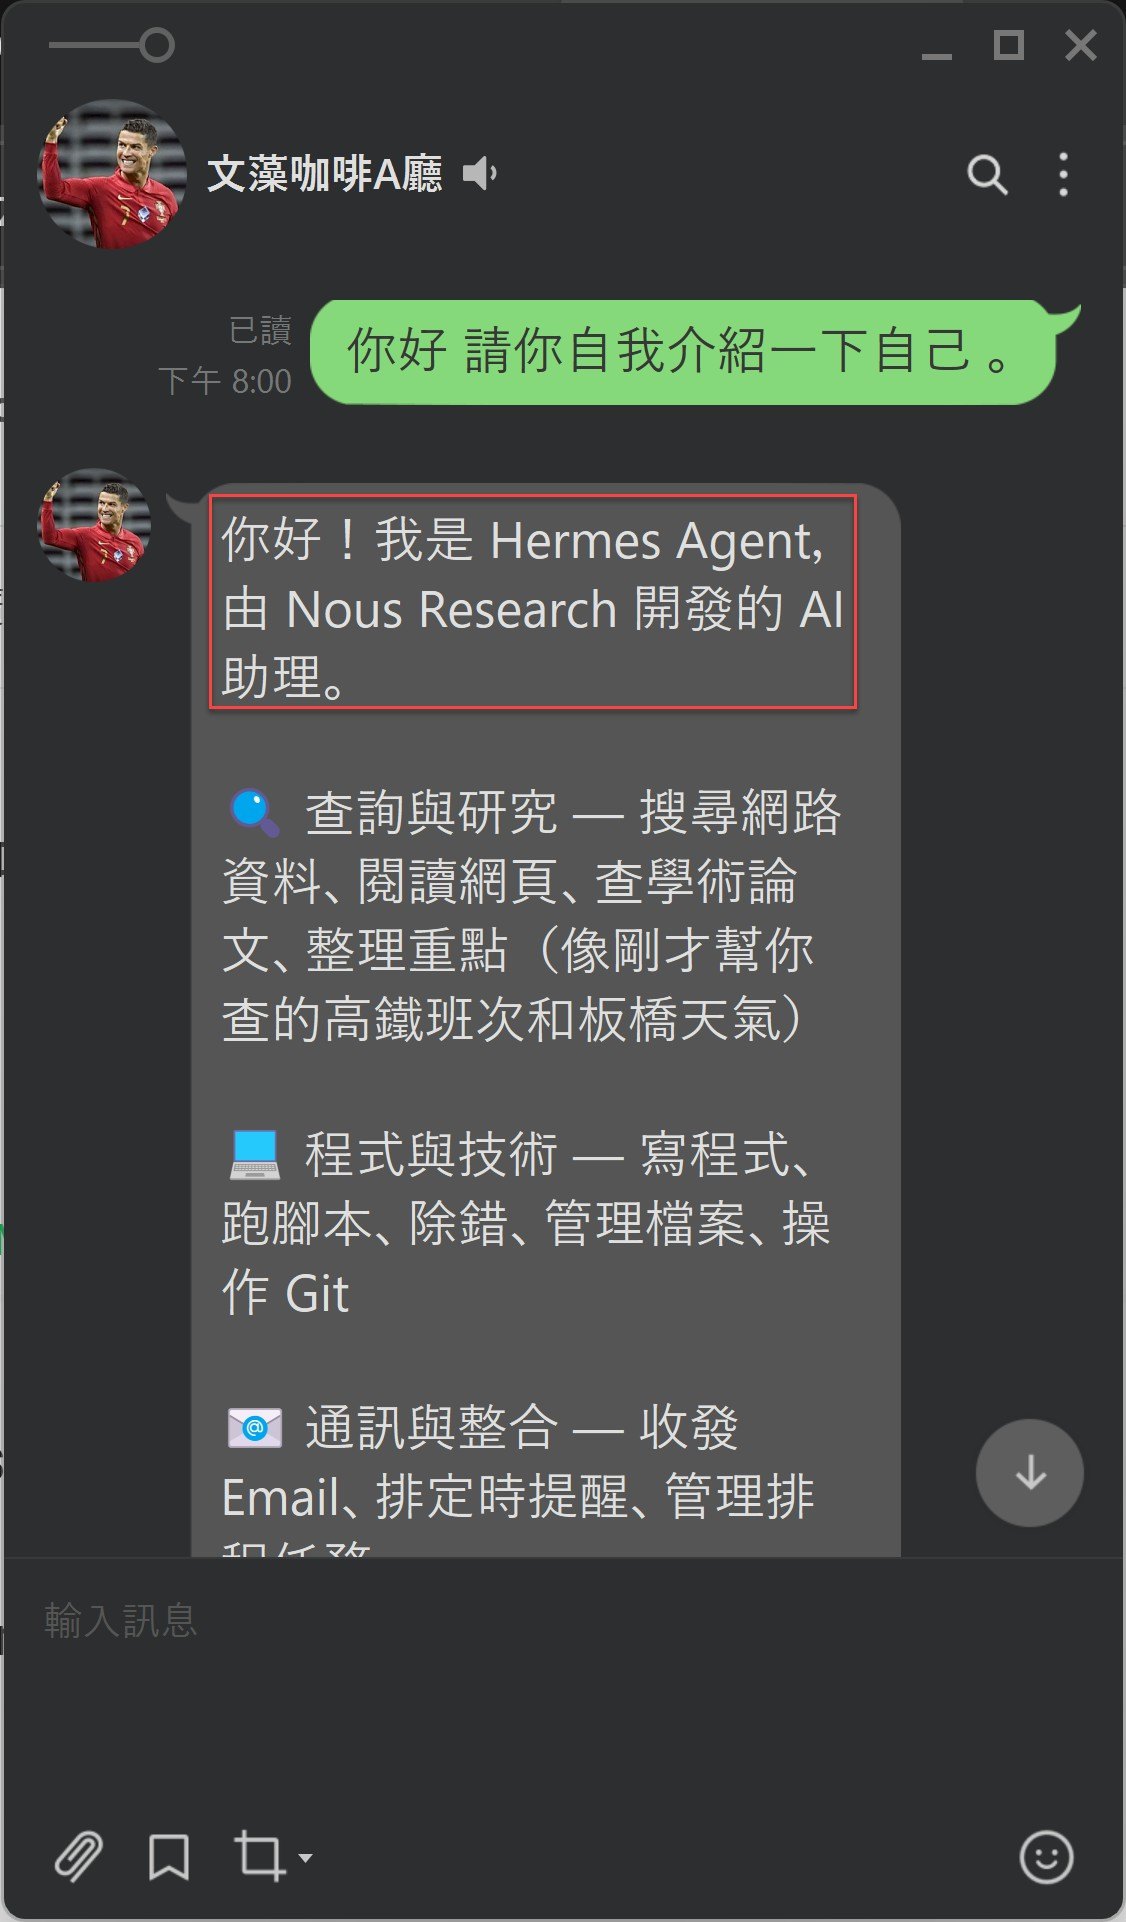
請它自我介紹時,Hermes 列出三大類:查詢與研究(搜尋網路、閱讀網頁、查學術論文)、程式與技術(寫程式、跑腳本、除錯、操作 Git)、通訊整合(收發 Email、排定時提醒、管理排程任務)。
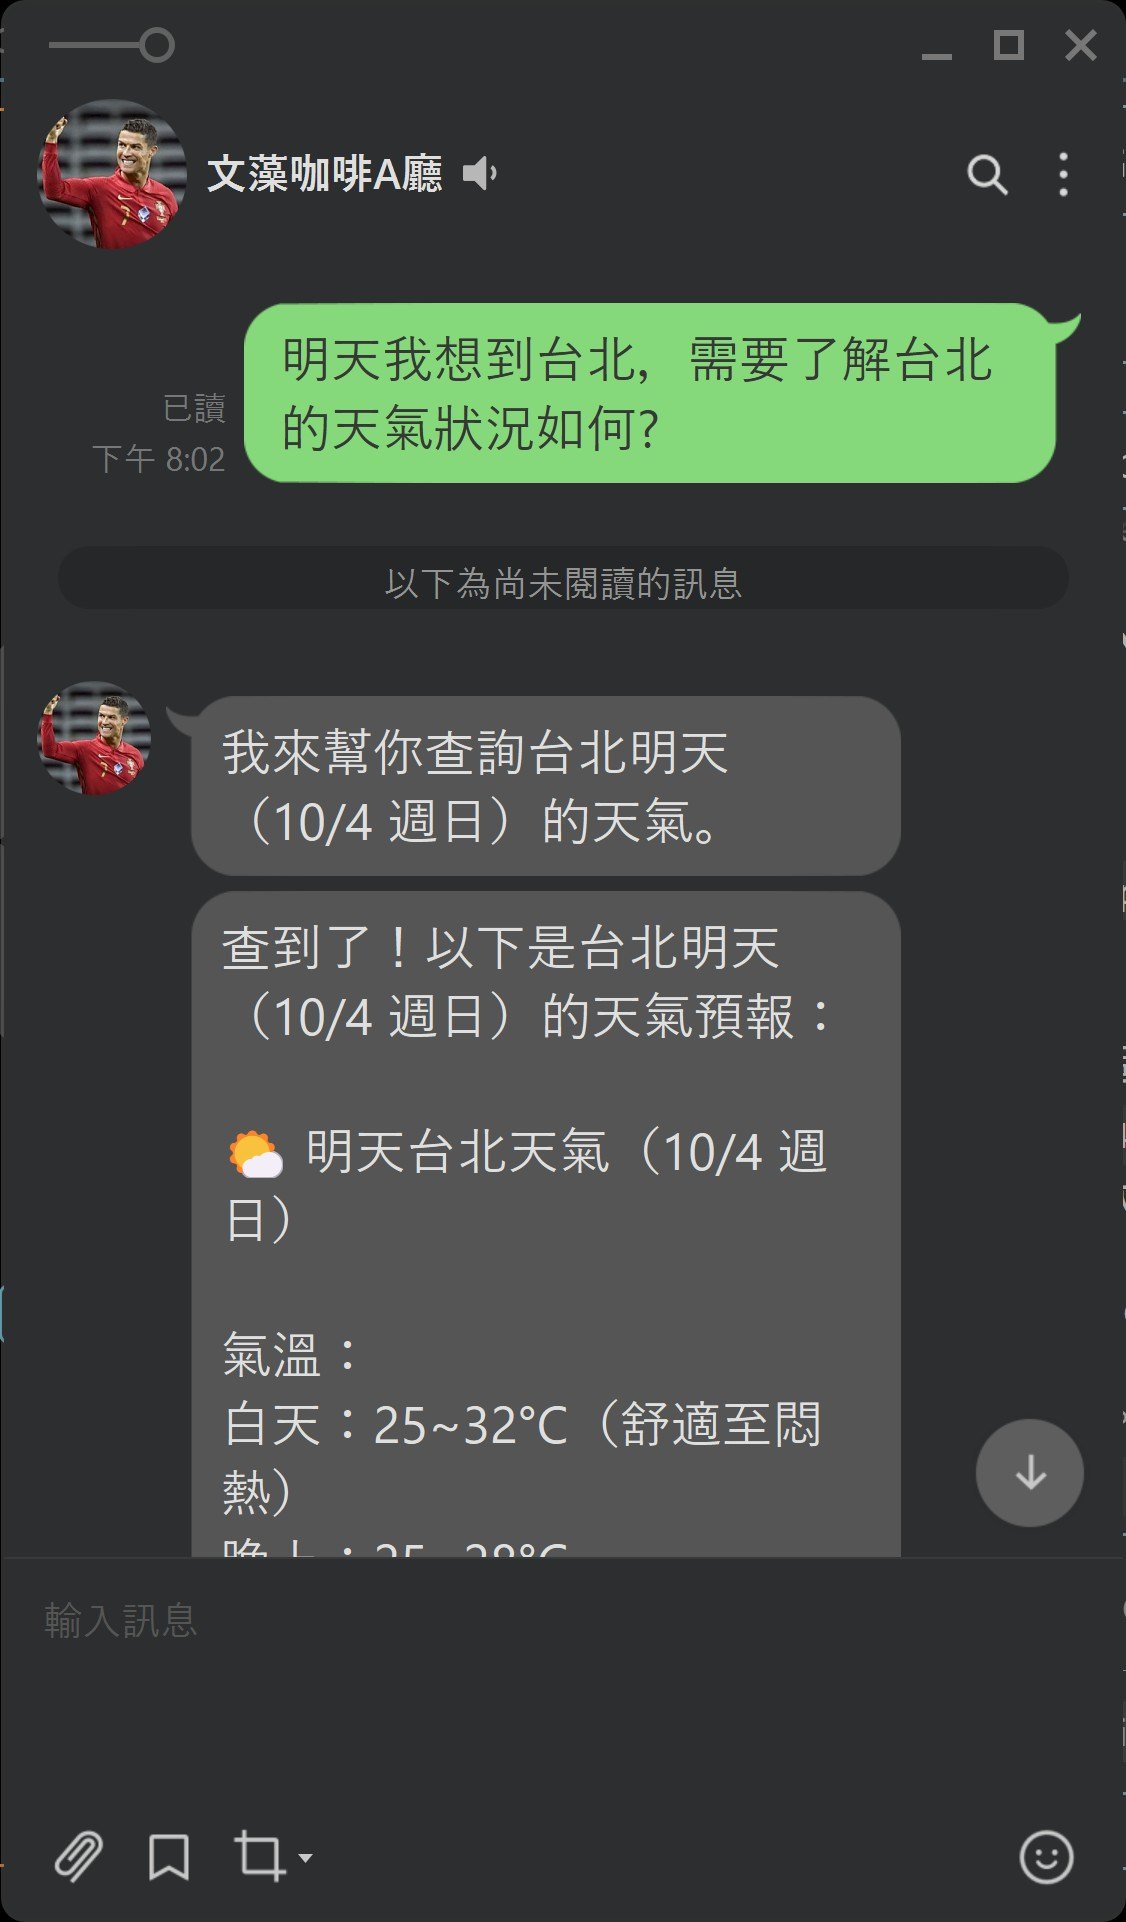
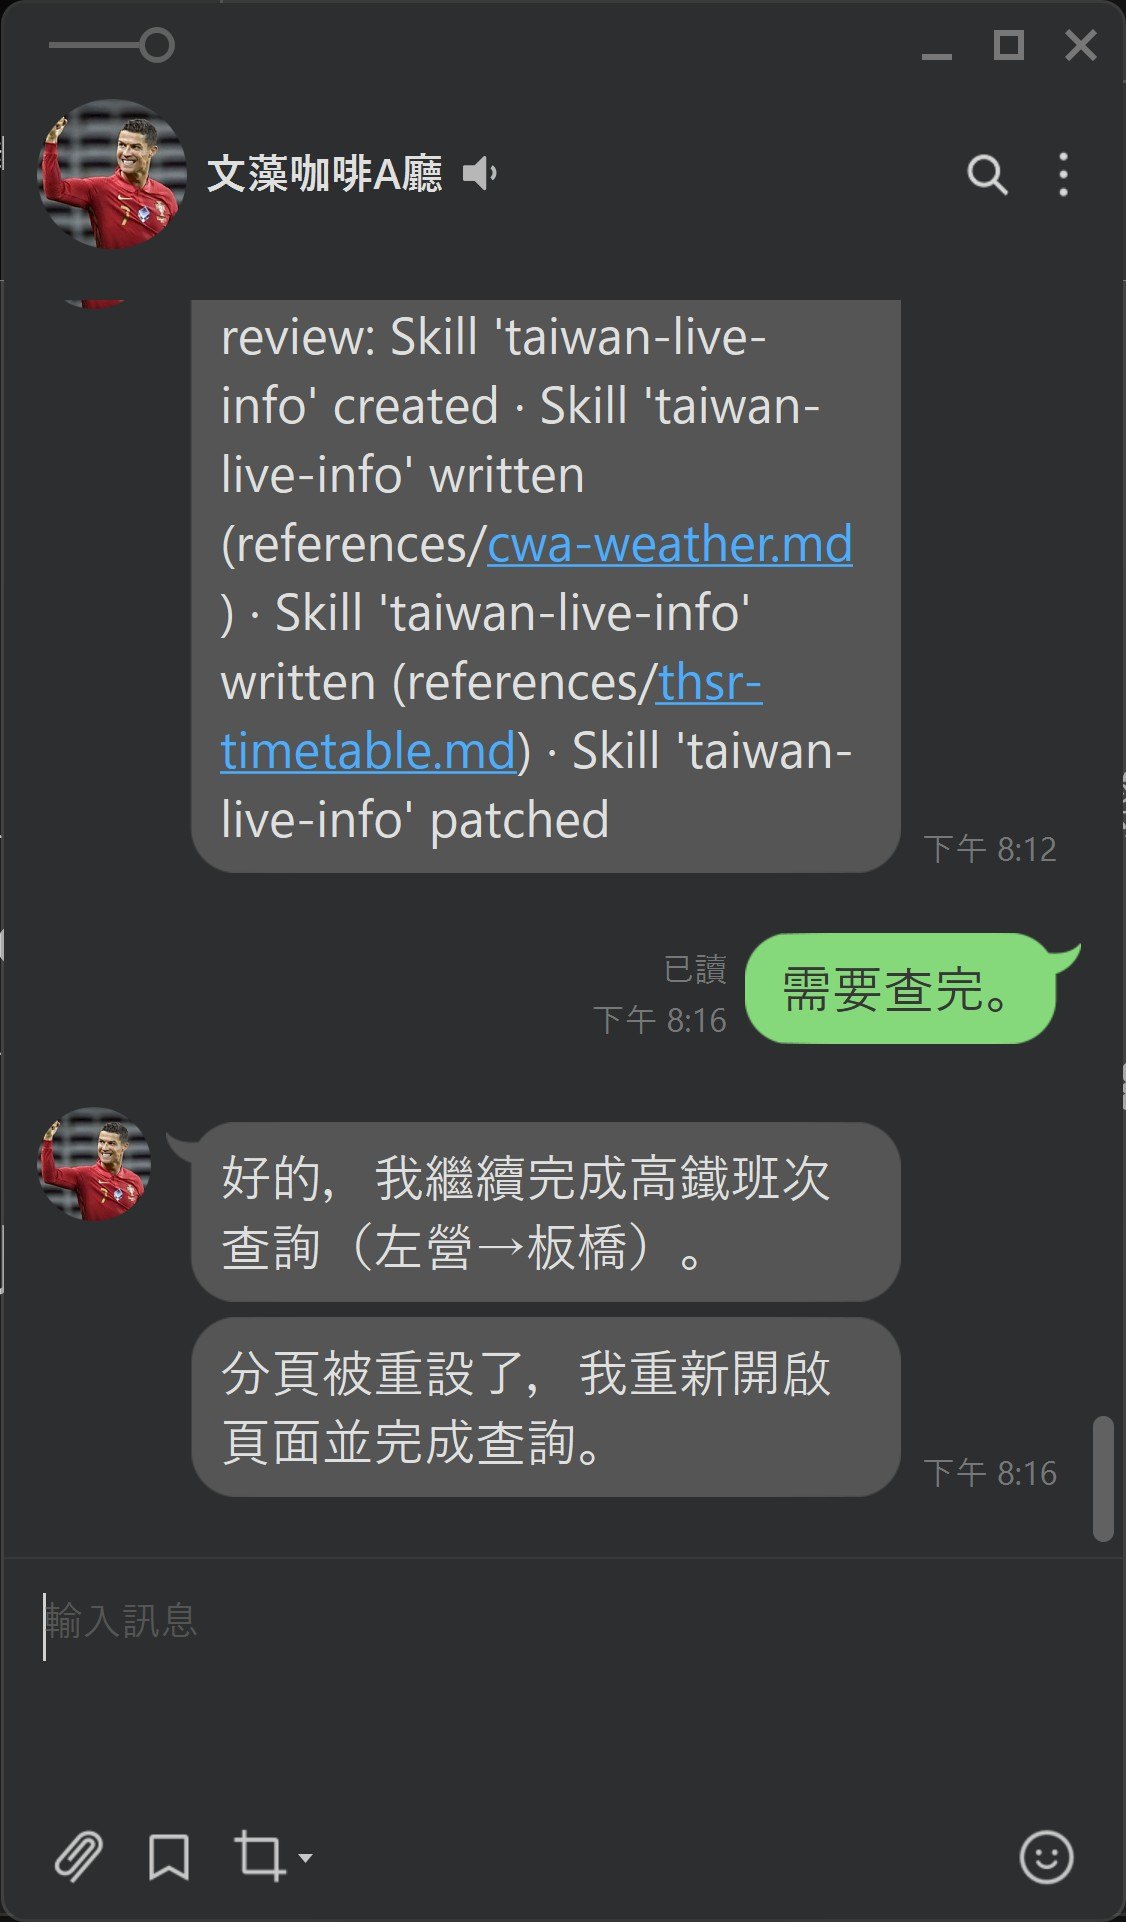
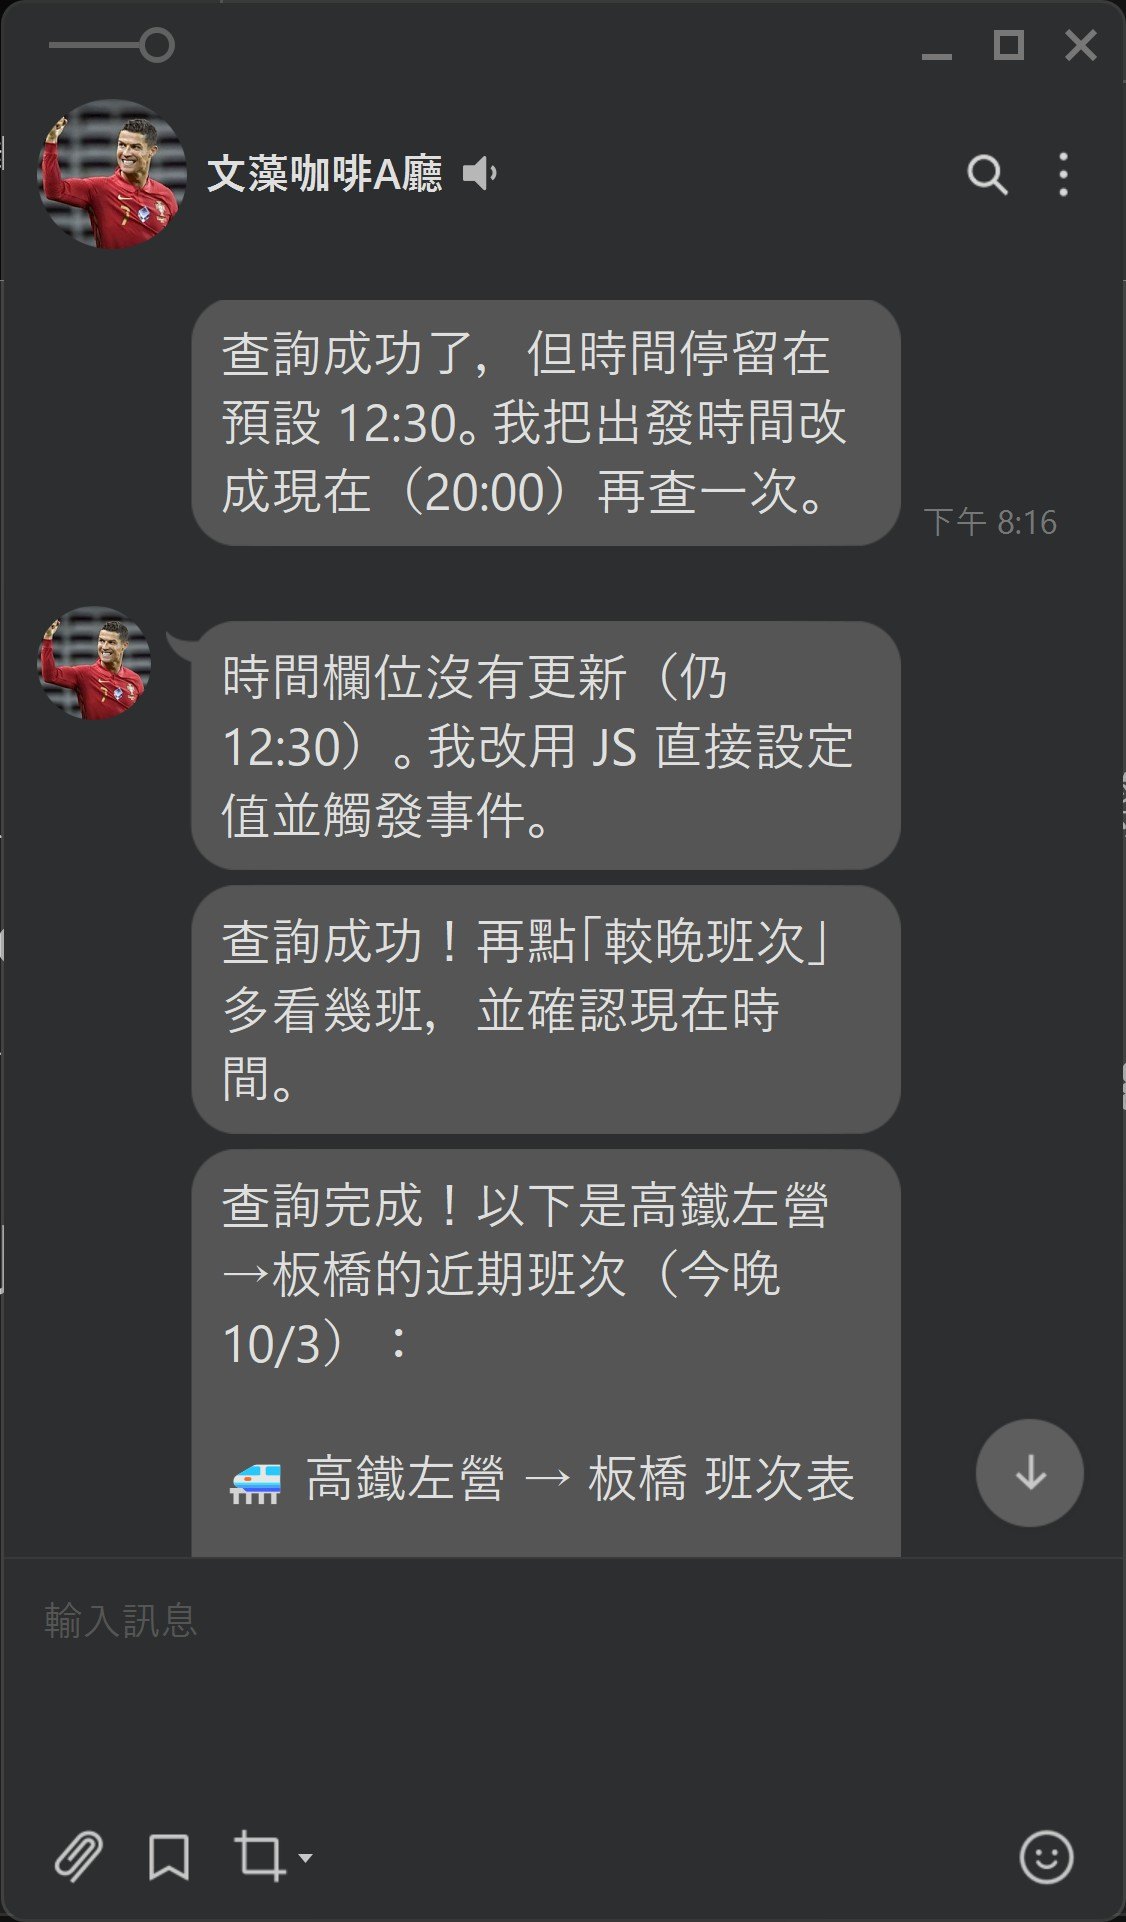
老師問「明天我想到台北,需要了解台北的天氣狀況如何?」Hermes 回了 10/4 的天氣預報。查高鐵左營到板橋的班次時,網頁的時間欄位停在預設的 12:30,Hermes 改用 JS 直接設定欄位值並觸發事件才查成功;中途分頁被重設,它自己重新開啟頁面接著查完。
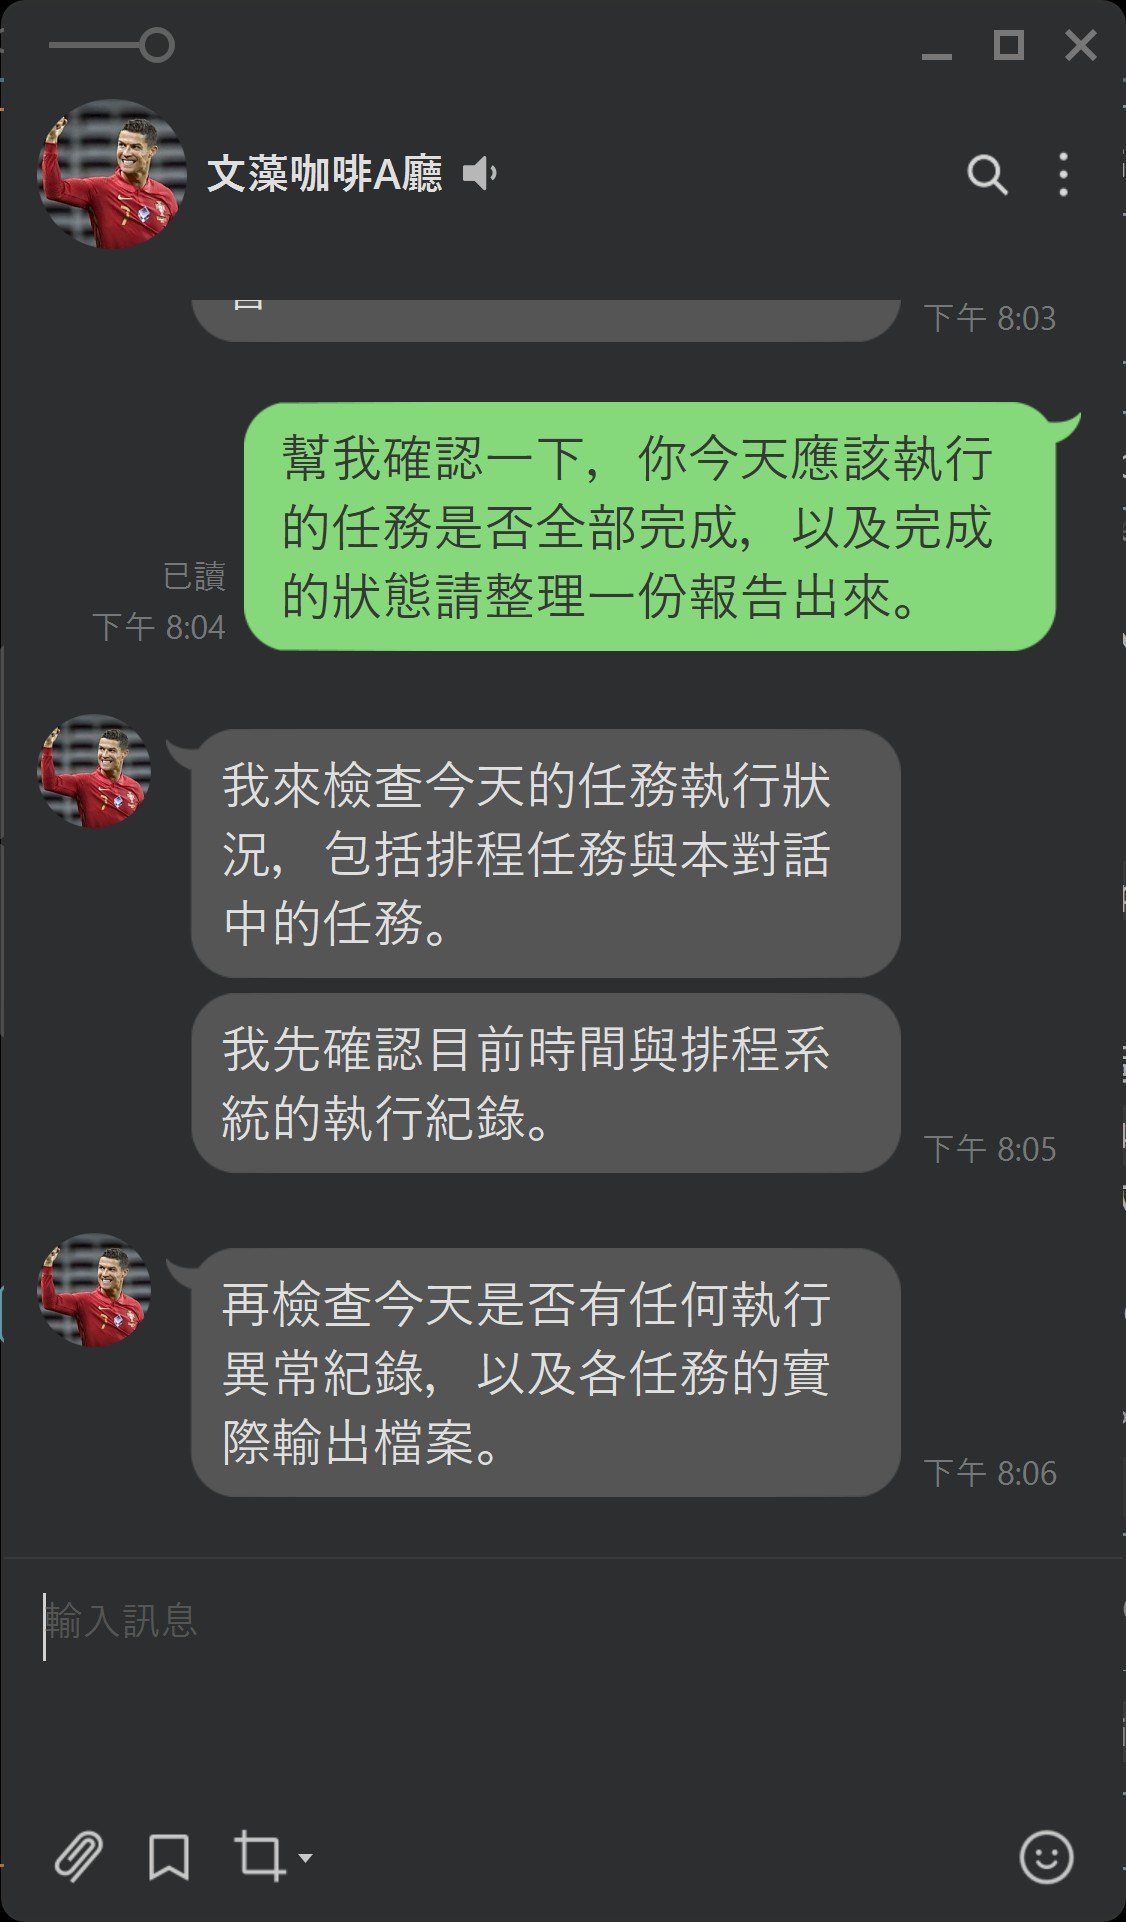
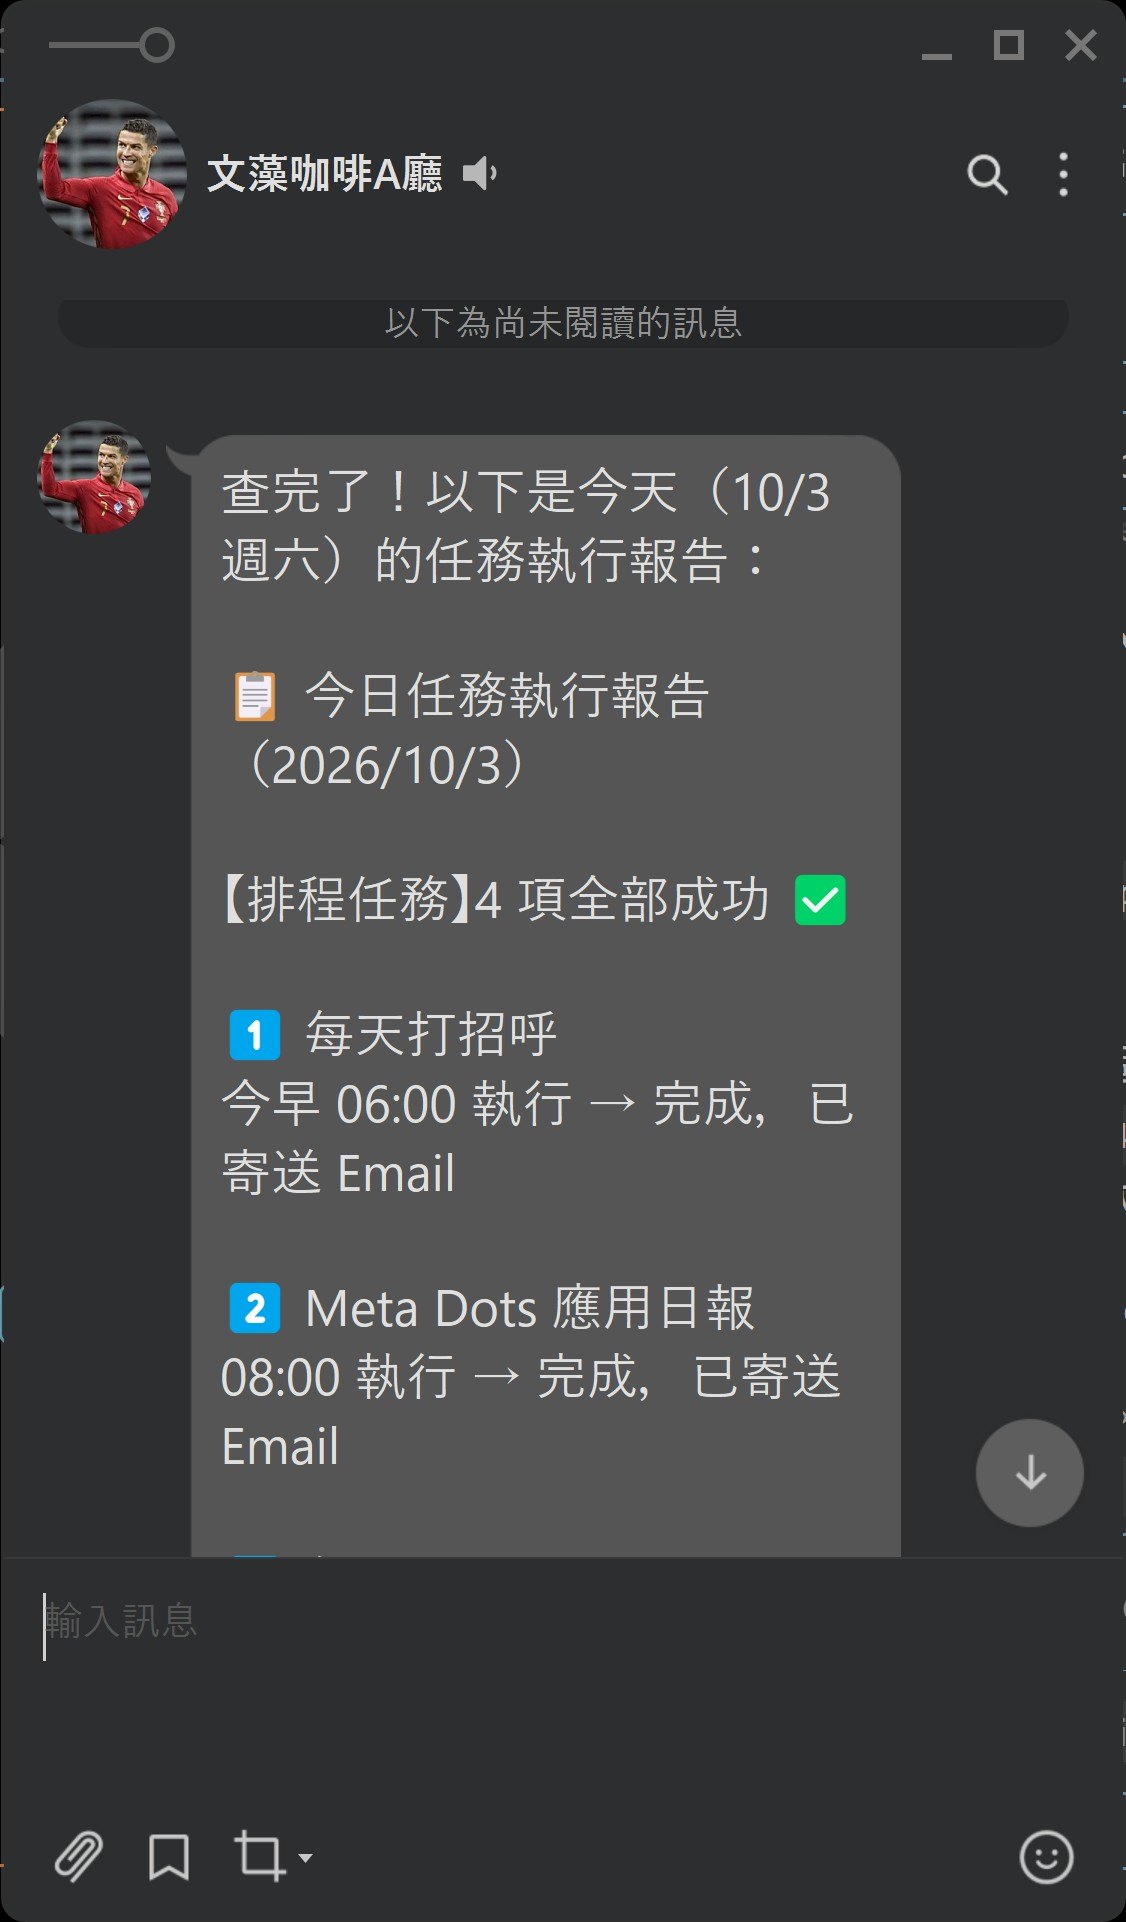
老師請它確認今天該執行的任務是否完成並整理報告,Hermes 檢查排程與執行紀錄後回報:4 項排程任務全部成功,例如 06:00 每天打招呼(已寄送 Email)、08:00 Meta Dots 應用日報(已寄送 Email)。
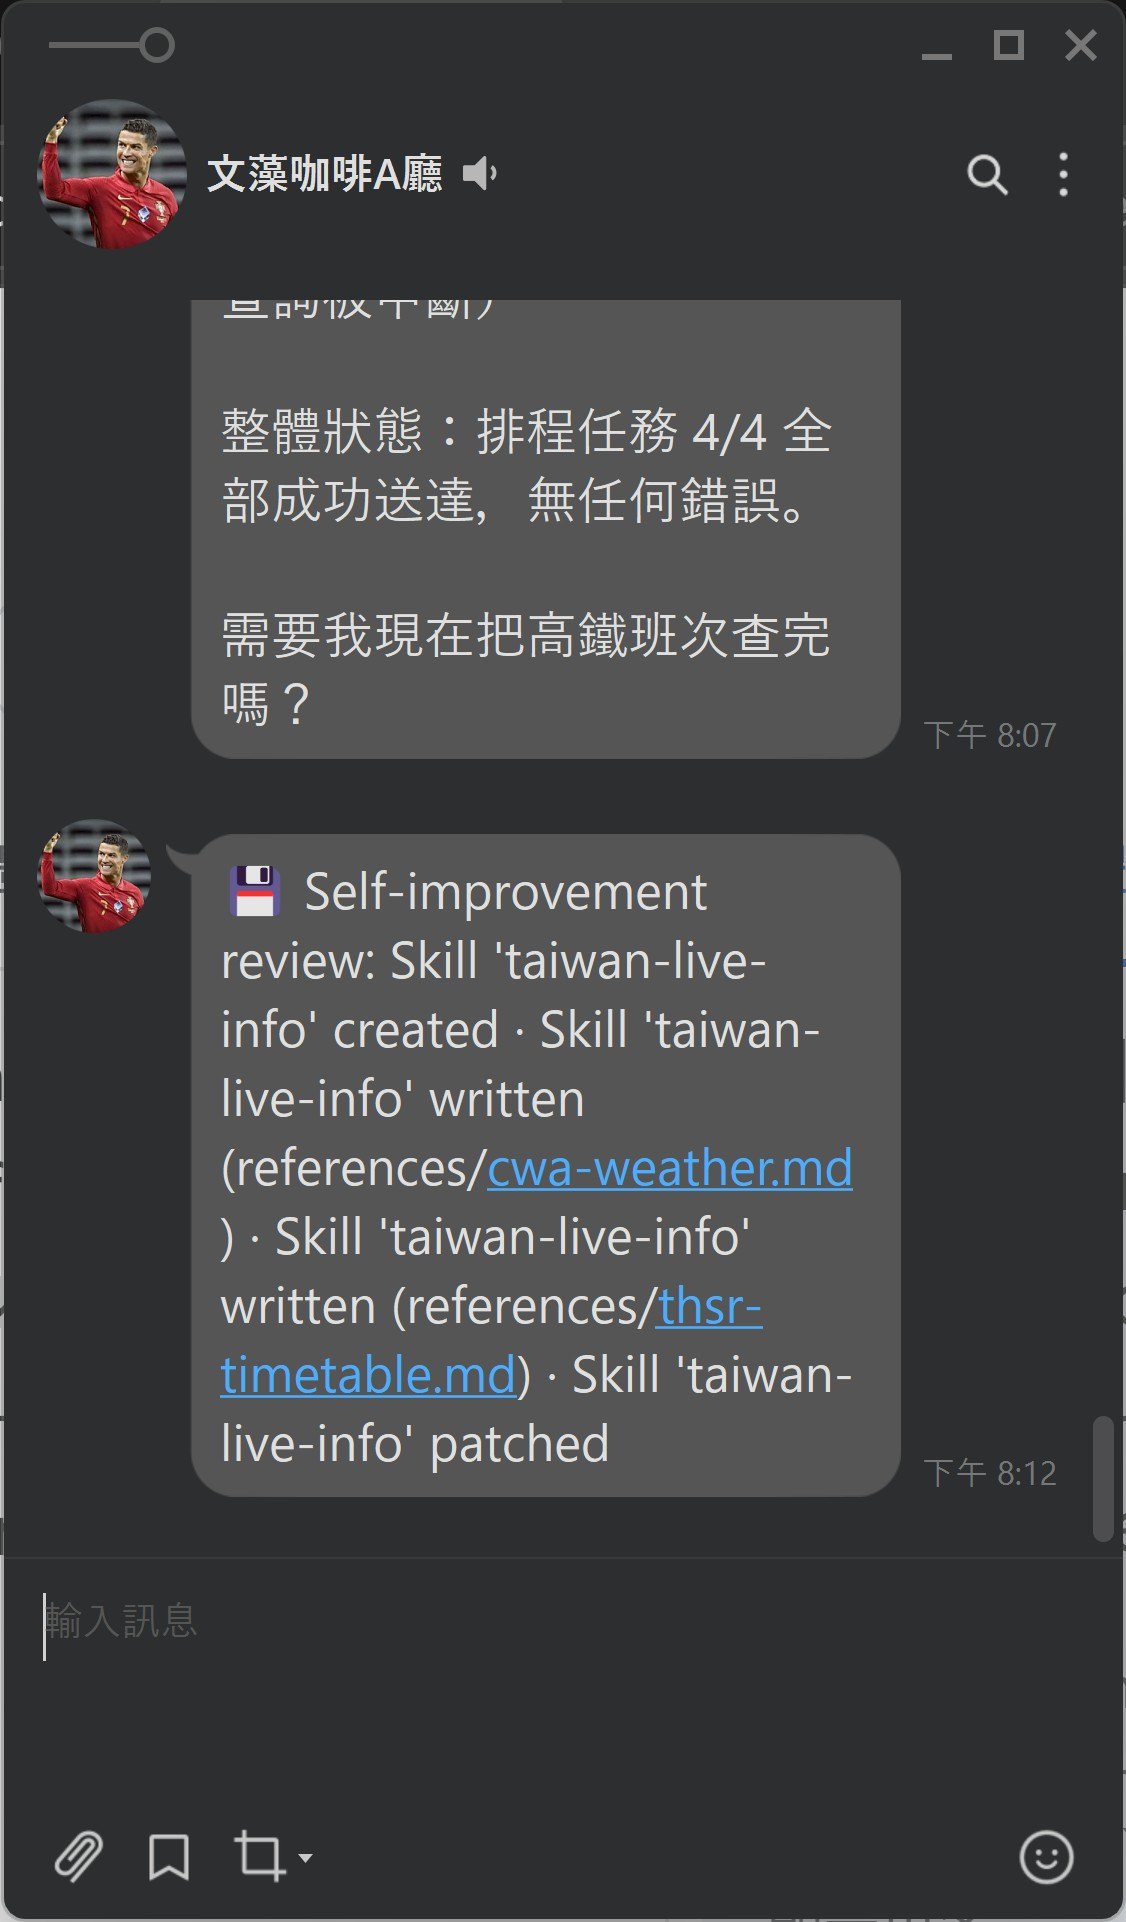
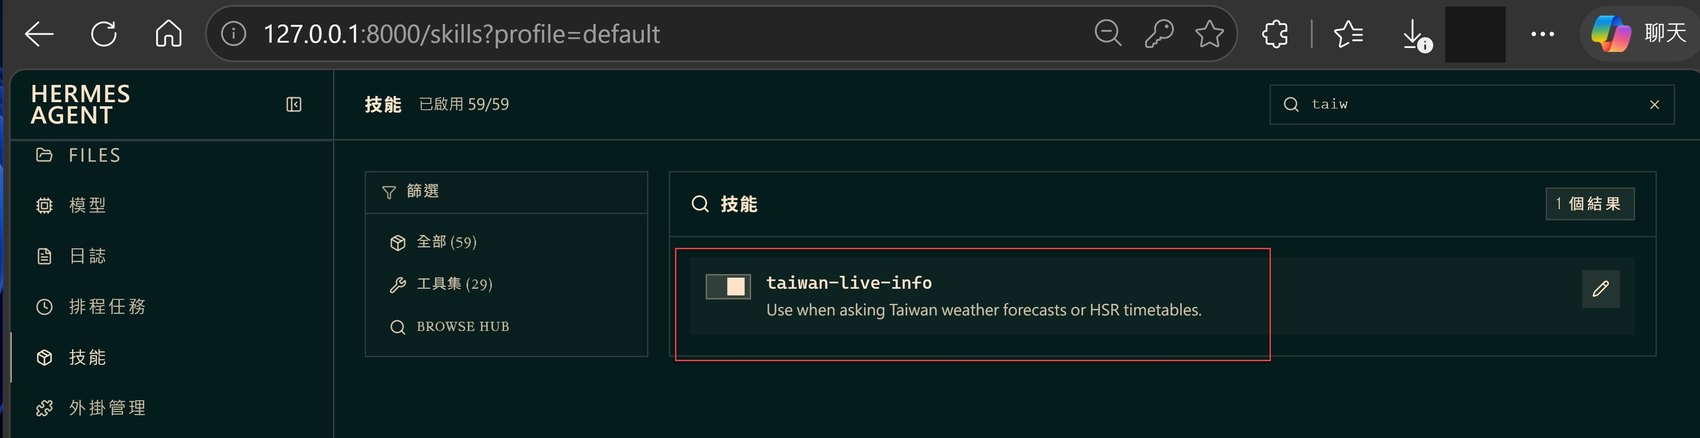
對話中跳出 Self-improvement review 訊息:建立了技能 taiwan-live-info,並寫入 cwa-weather.md、thsr-timetable.md 兩份參考資料。Dashboard 技能頁搜尋可看到它,說明是「問台灣天氣預報或高鐵時刻表時使用」,目前已啟用技能 59/59。
老師預告要用 Hermes 驅動自己設計的 MCP Server,接內部資料庫伺服器,做訂單與客戶資料的查詢與作業整合——這就是下一堂的內容。
想看這套 Docker 架構怎麼搭:Docker Hermes Container 系統架構圖解(老師 20:41 補充了 v4 架構圖解)。
第 9 堂
Hermes + MCP 用 LINE 查企業資料庫(Northwind)
接續上一堂的預告,老師完成了:在 Hermes Agent 架一個 MCP Server,提供工具查詢 Docker 裡 SQL Server 資料庫的「客戶資料」與「訂單資料」,再整合到 LINE Webhook,讓人用自然語言(NLP)透過 LINE 查企業內部資料庫。示範用的是 Northwind 範例資料庫。
LINE Bot 的 webhook 串到 Hermes webhook,由 Hermes 配置的 MCP Server 與工具(function calling)去連 Docker 裡的 MS SQL Server。老師同晚貼了兩份架構圖解當作整體說明,見下方連結。
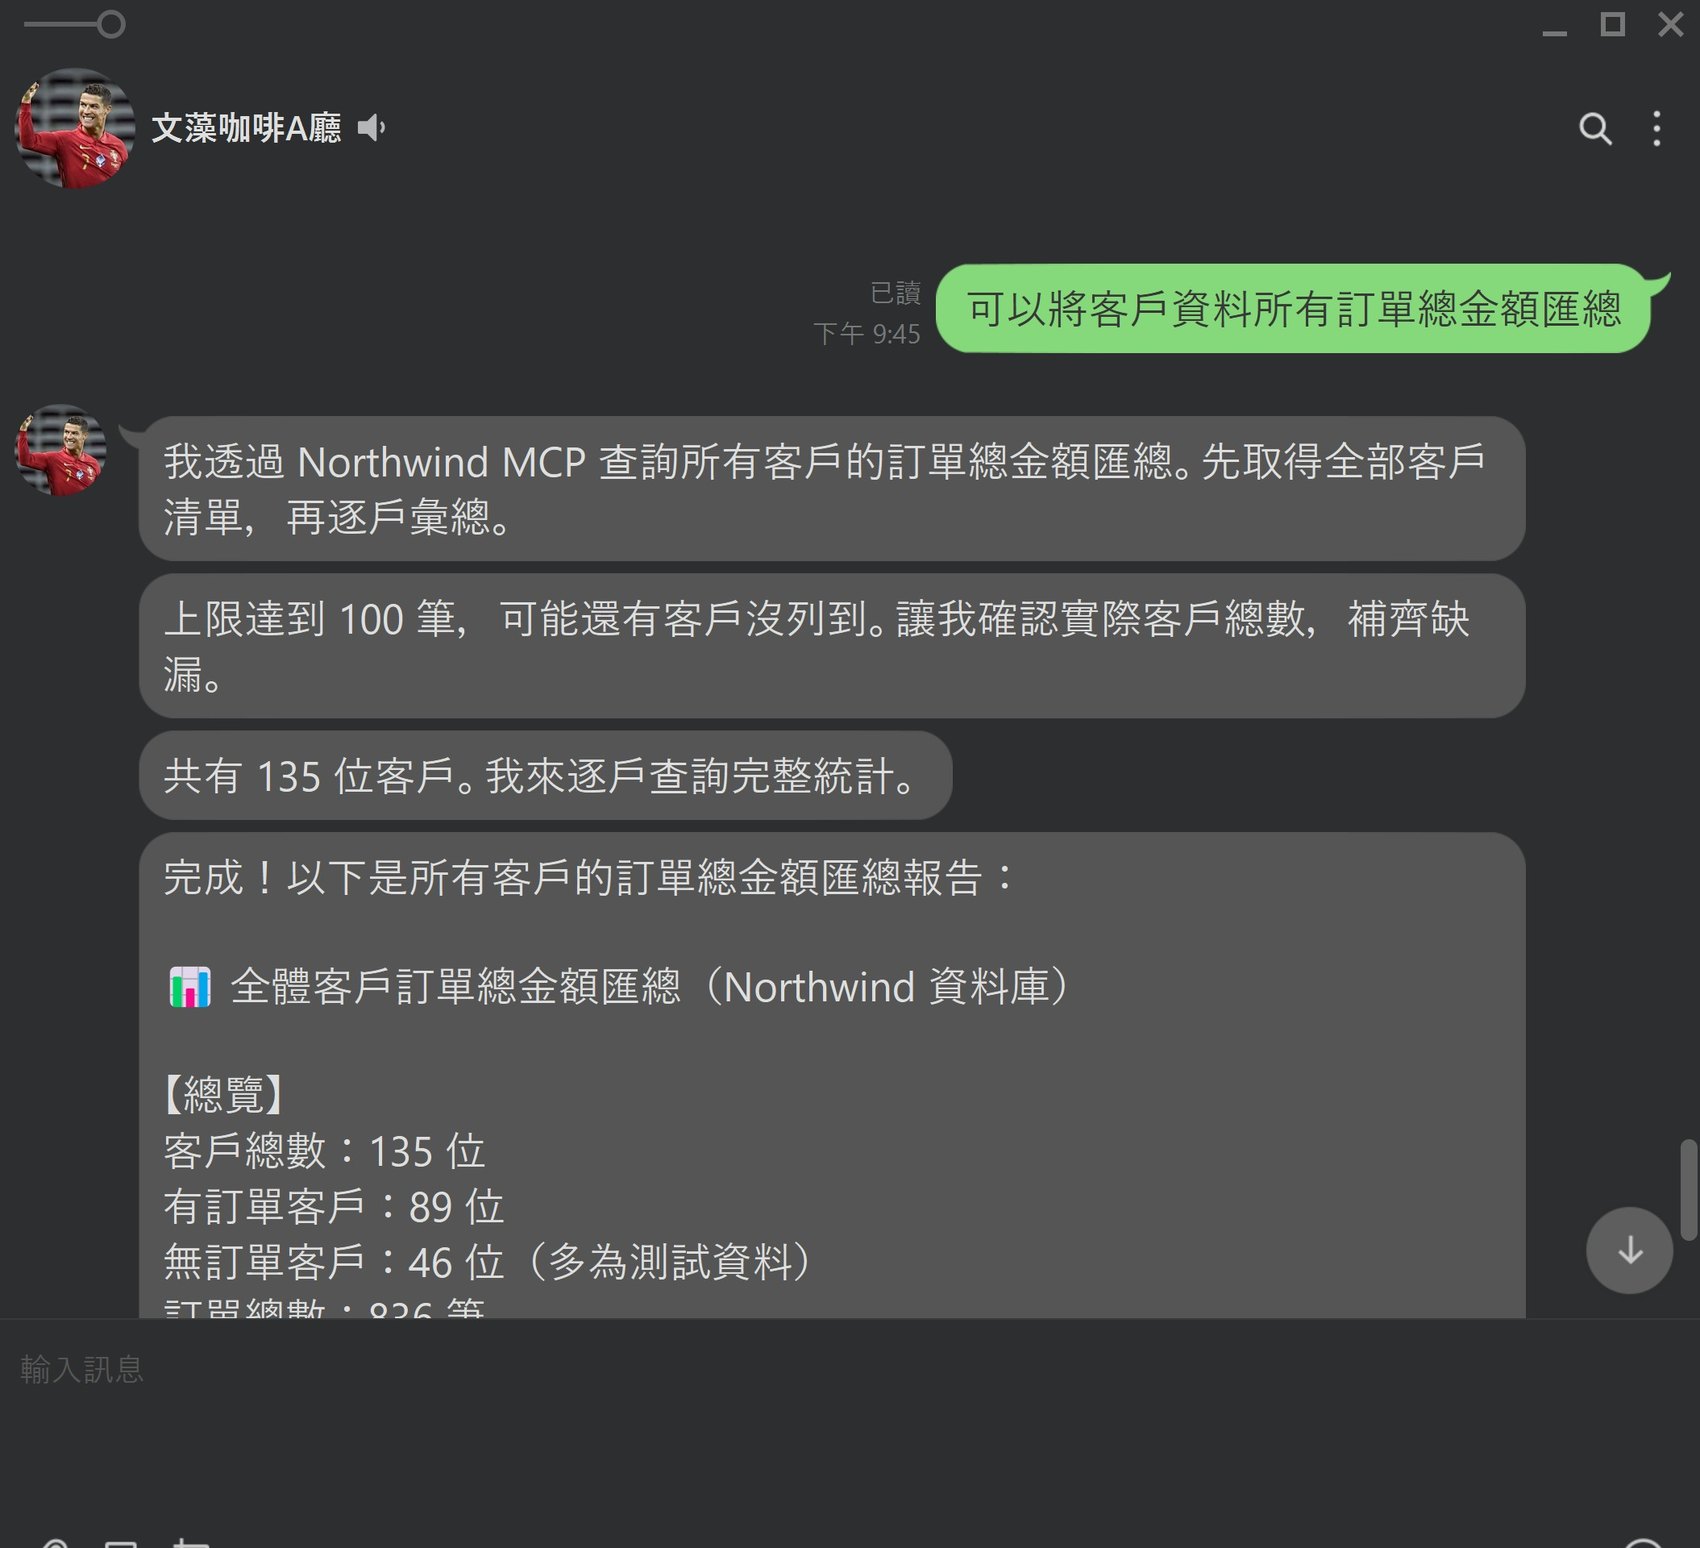
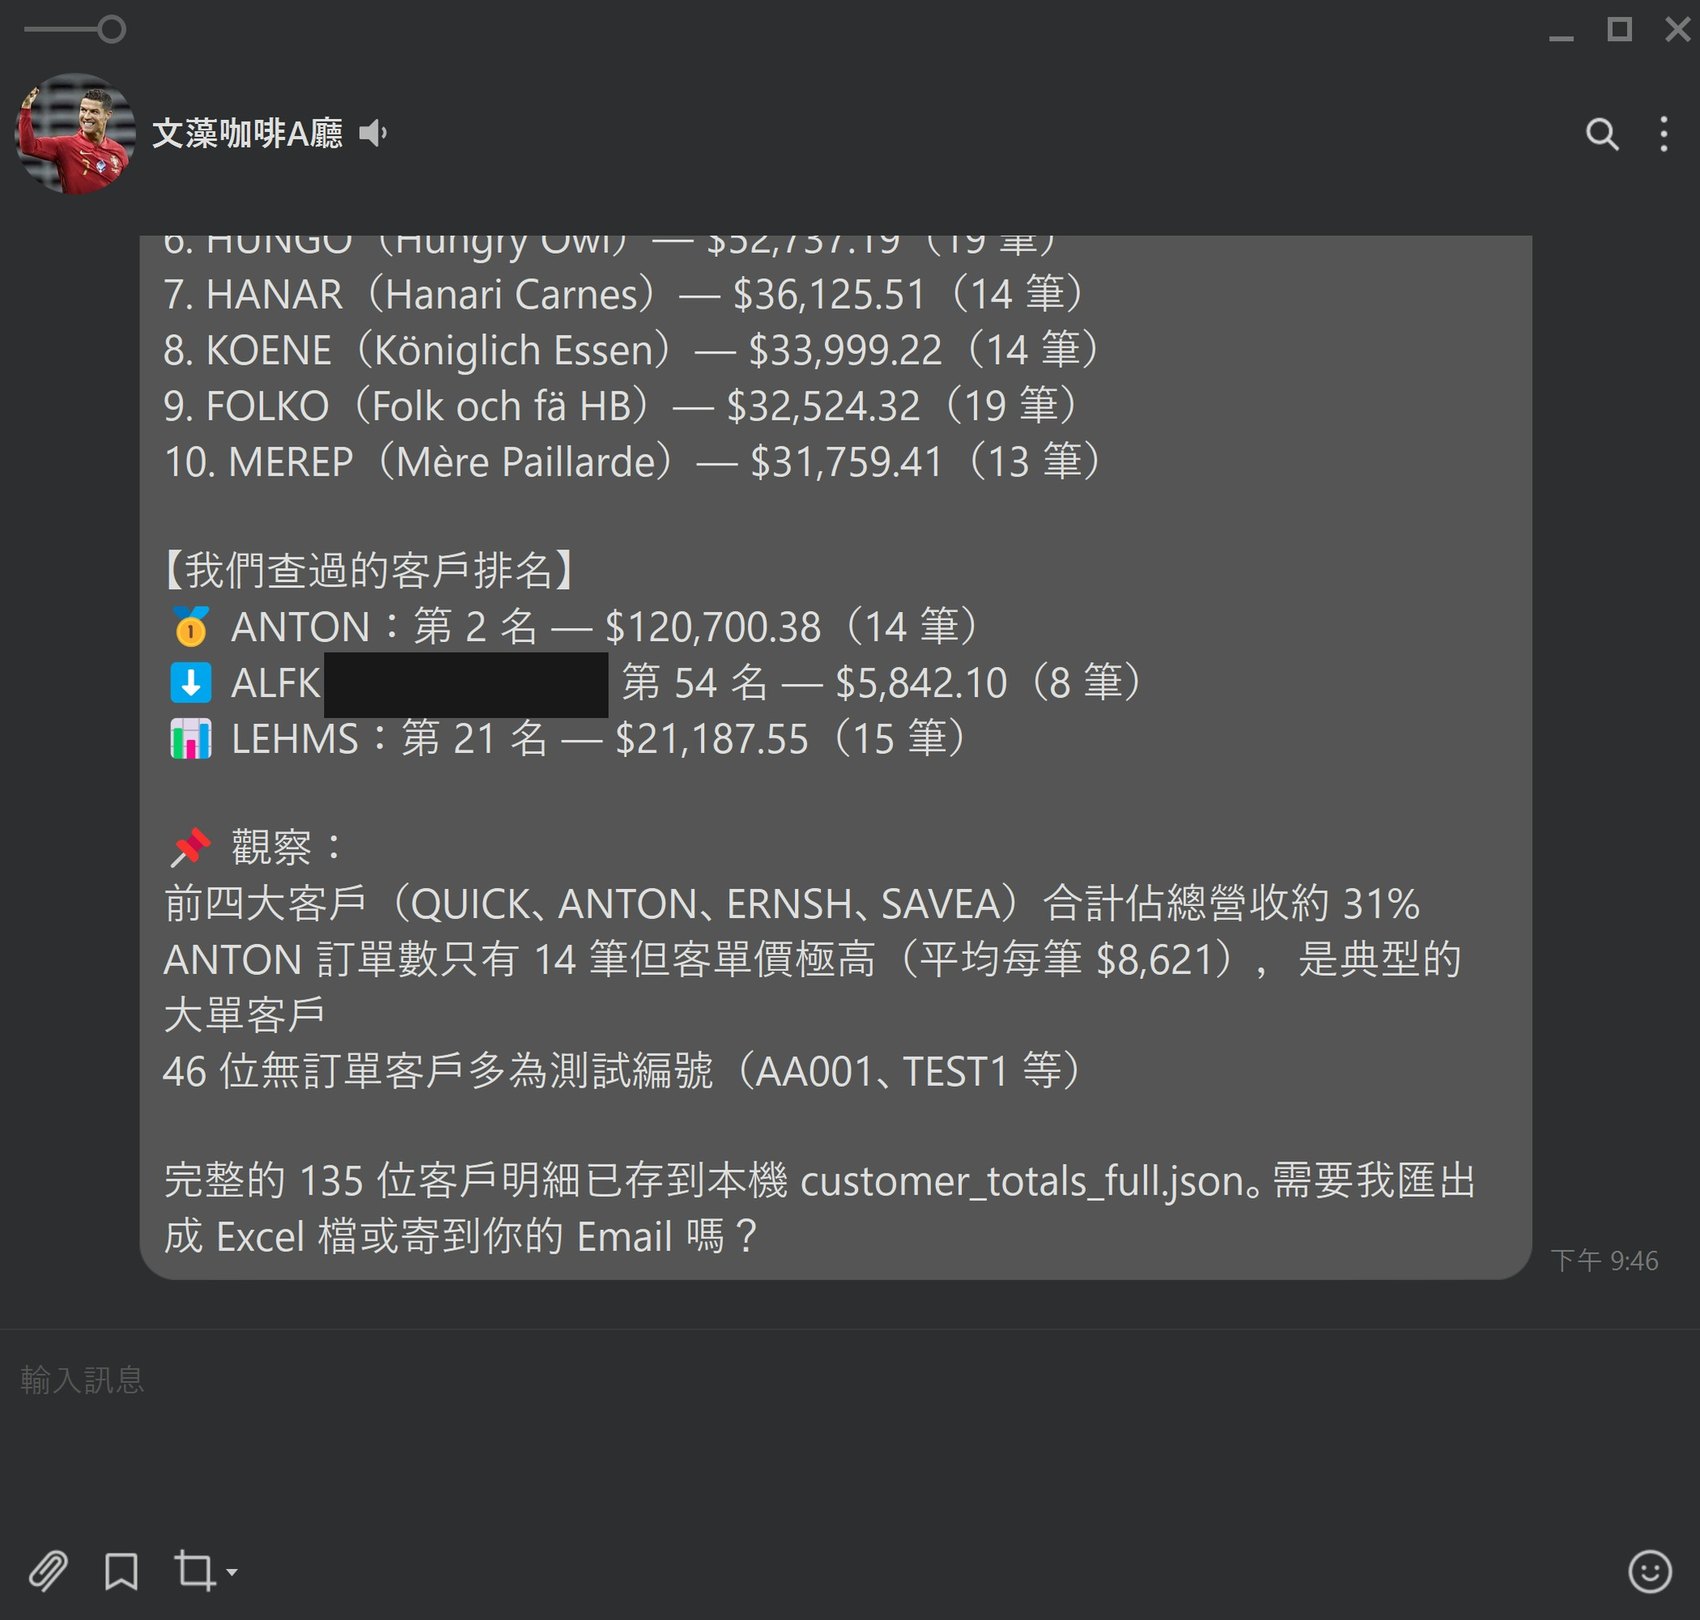
在 LINE 問「可以將客戶資料所有訂單總金額匯總」。Hermes 透過 Northwind MCP 先取得全部客戶清單;第一次查詢遇到 100 筆上限,它自己確認實際客戶總數是 135 位,再逐戶查詢彙總。
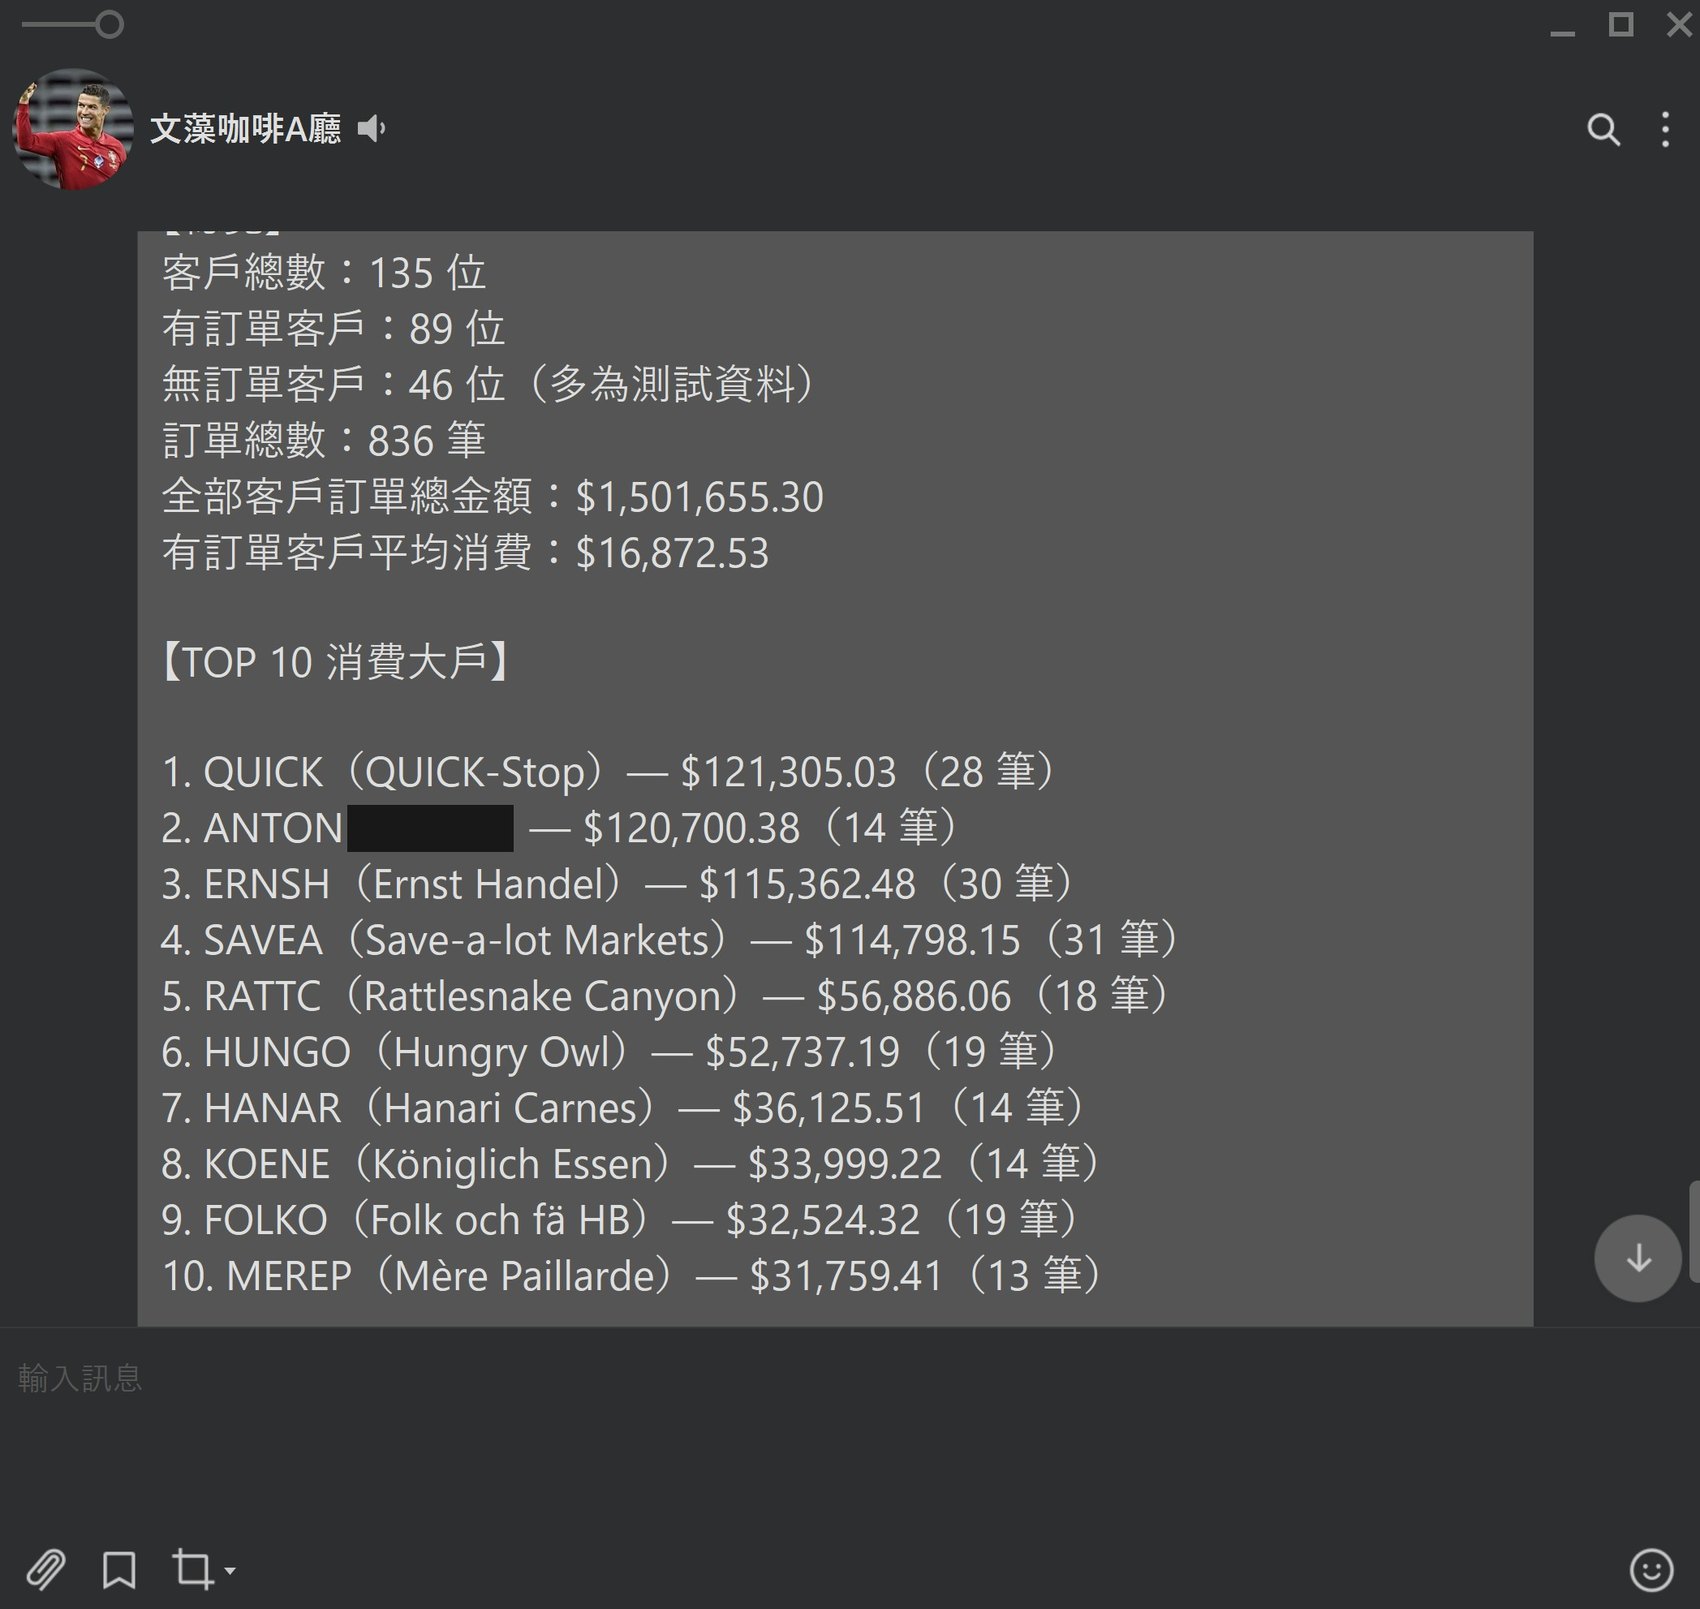
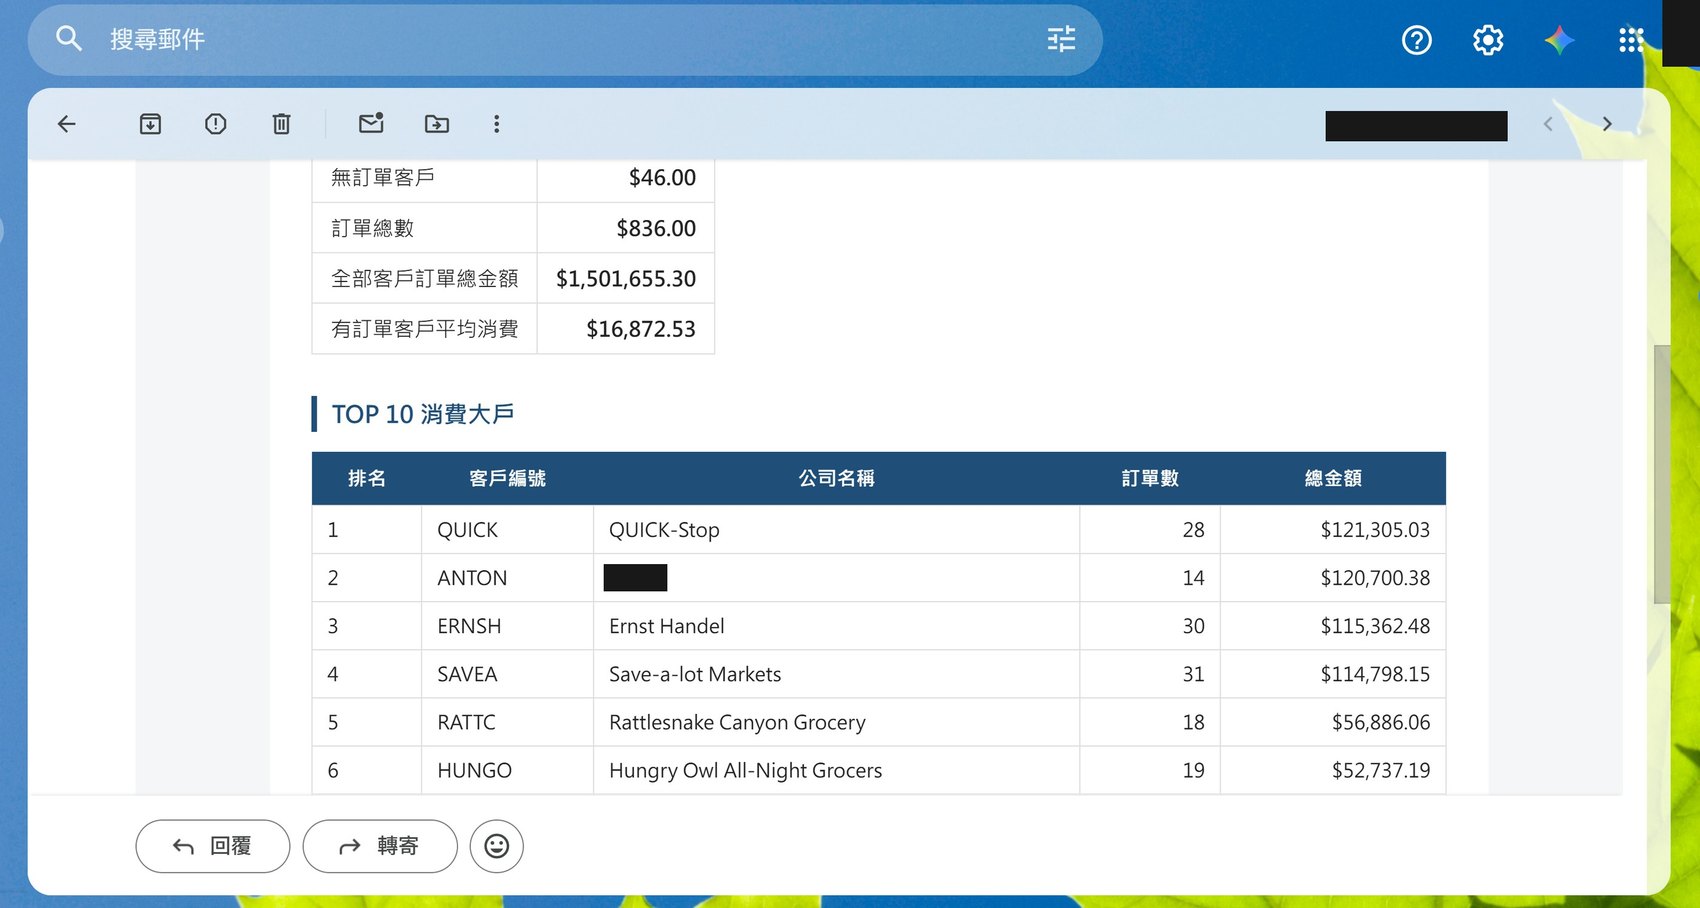
客戶 135 位、有訂單 89 位、無訂單 46 位(多為測試資料)、訂單 836 筆、全部客戶訂單總金額 $1,501,655.30、有訂單客戶平均消費 $16,872.53,並附 TOP 10 消費大戶。Hermes 還給了觀察:前四大客戶合計約占總營收 31%;ANTON 只有 14 筆訂單但平均每筆約 $8,621,是典型的大單客戶。
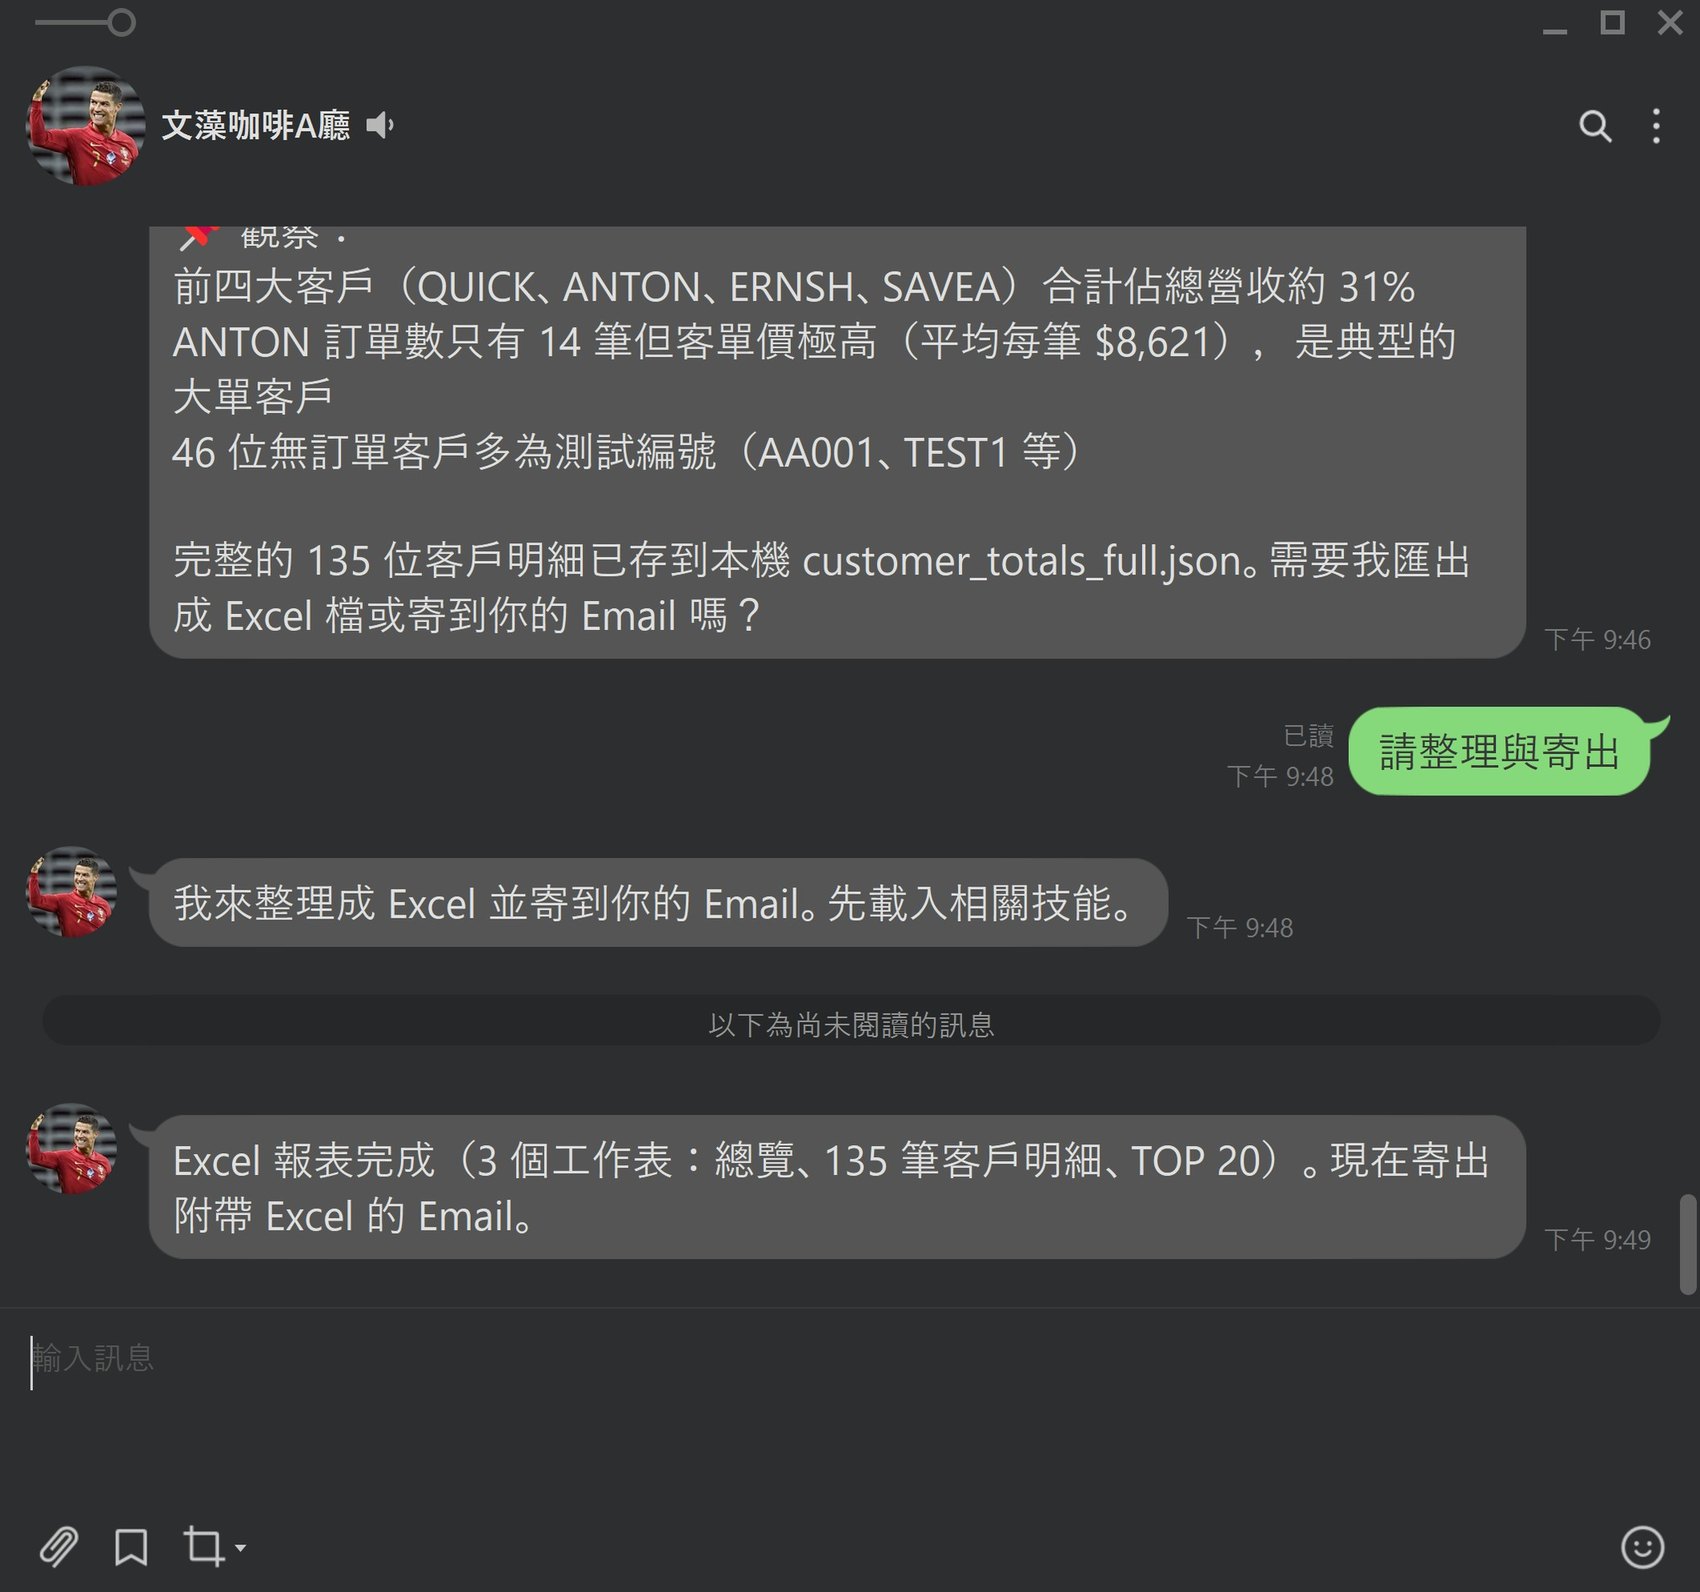
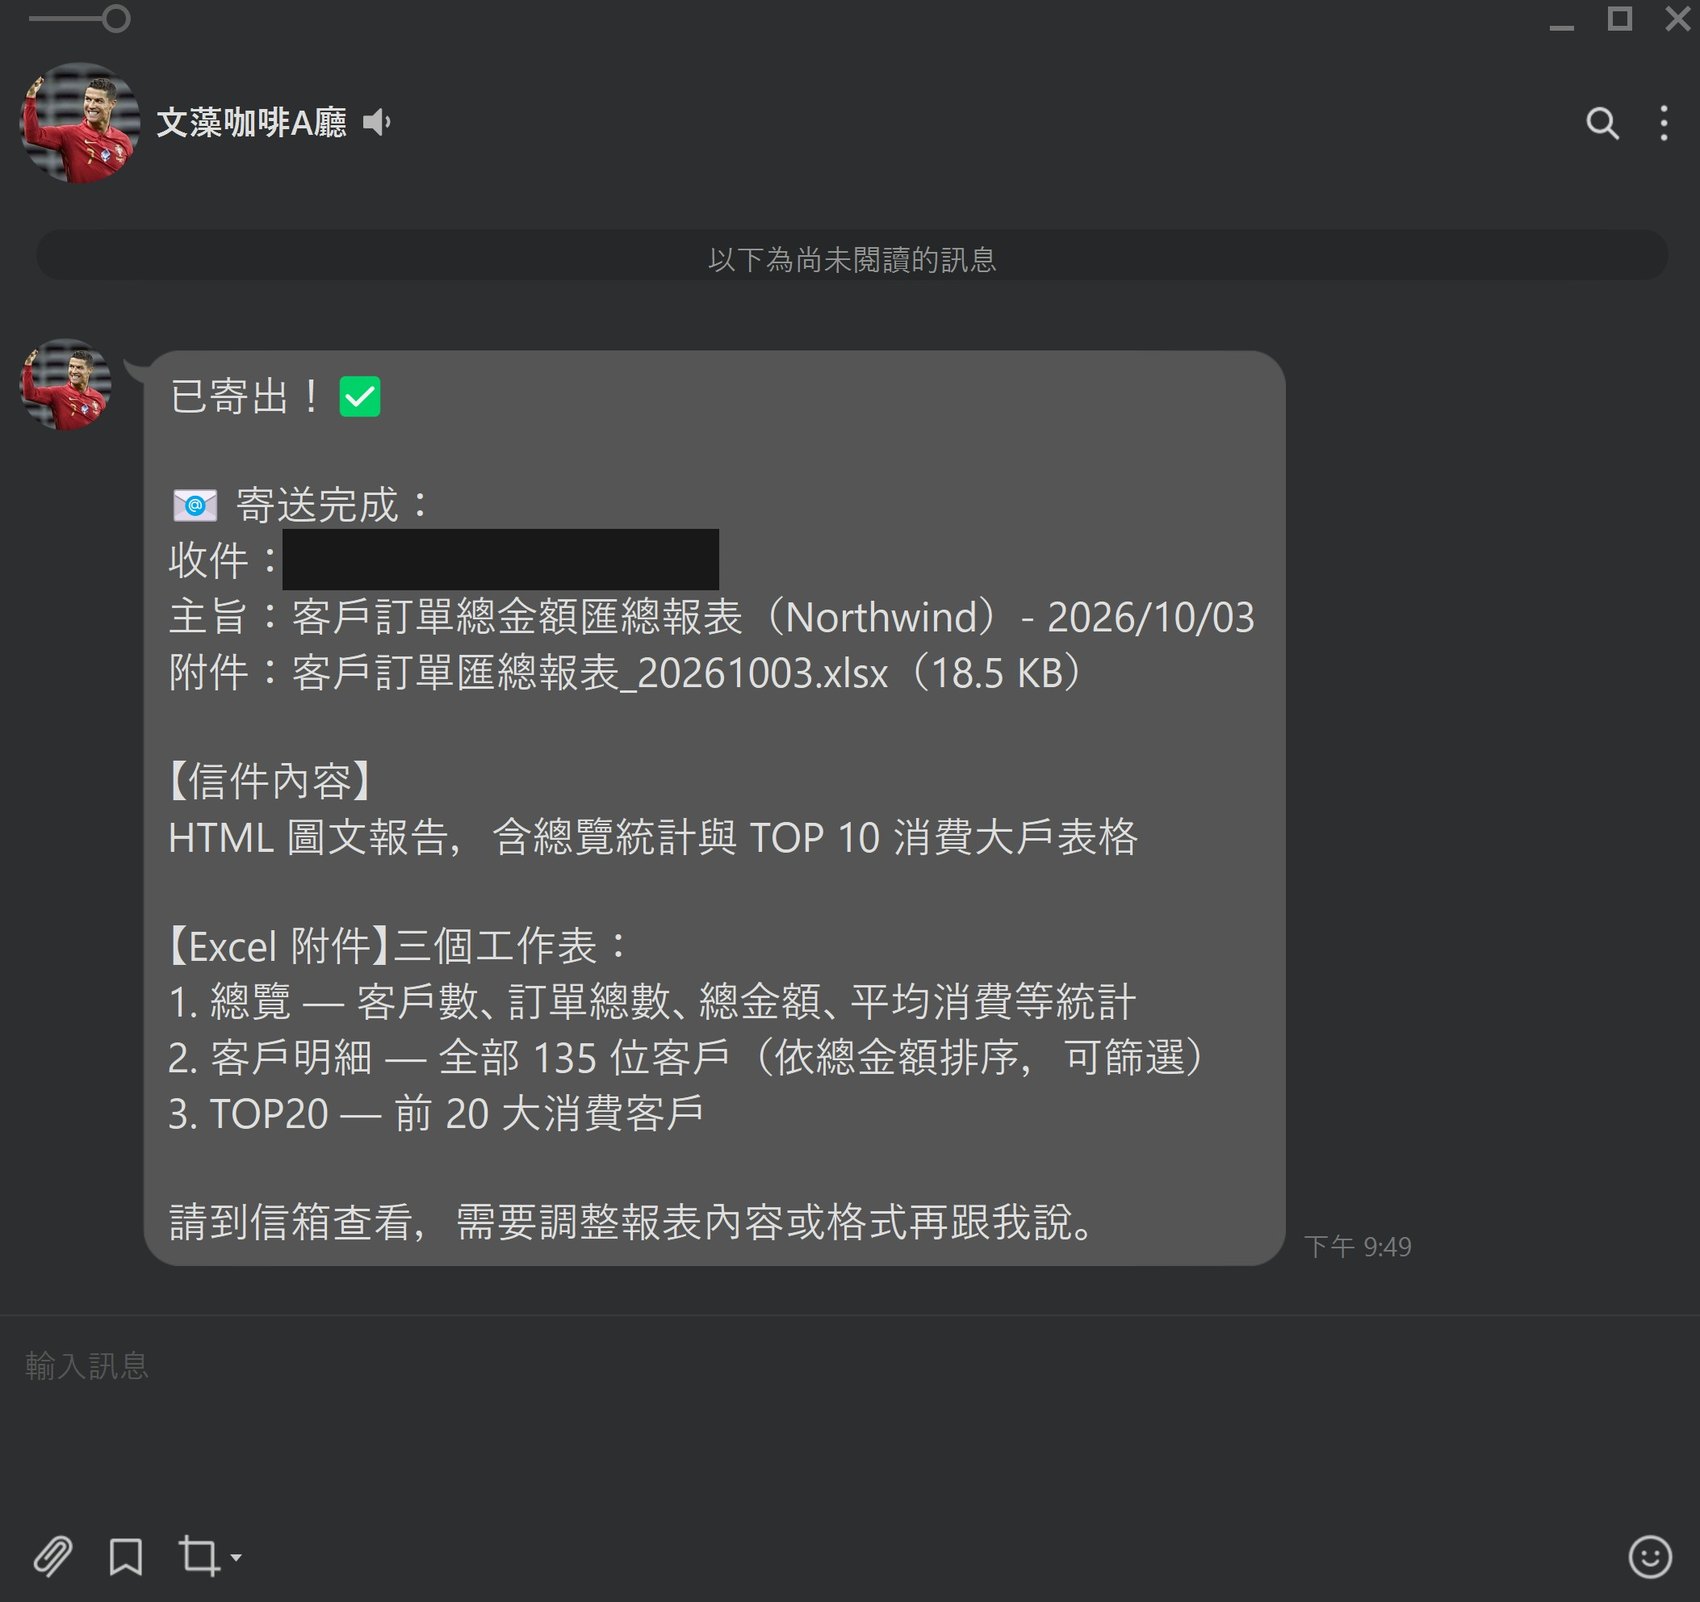
Hermes 問要不要匯出成 Excel 或寄到 Email;老師回「請整理與寄出」,它產出 Excel(總覽、135 筆客戶明細、TOP 20 三個工作表)與 HTML 圖文報告,寄到信箱。截圖中可看到寄送完成的說明,以及信件裡的總覽統計與 TOP 10 表格。
配套架構圖解:Docker Hermes Container 系統架構圖解(v4、v5),其中 v5 專講 NORTHWND MCP Server 與 LINE Webhook。
第 10 堂
Hermes LINE Channel 處理架構流程:一則 LINE 訊息怎麼被處理
前兩堂老師示範了用 LINE 聊天驅動 Hermes Agent。這一堂他把背後的架構整理成一份 21 頁簡報加一份 24 頁報告:讓 Hermes 掛在 LINE Messaging API 的 Webhook 上,被叫「小艾」才回應;在對話視窗內連續聊天不必再喊名字;語音訊息走同一套判斷。老師分享時補充:流程控制是用程式碼配合 NLP 做機械式決策,目的是省 Token、提高正確率與速度(這一句是口頭說明,不在簡報裡)。
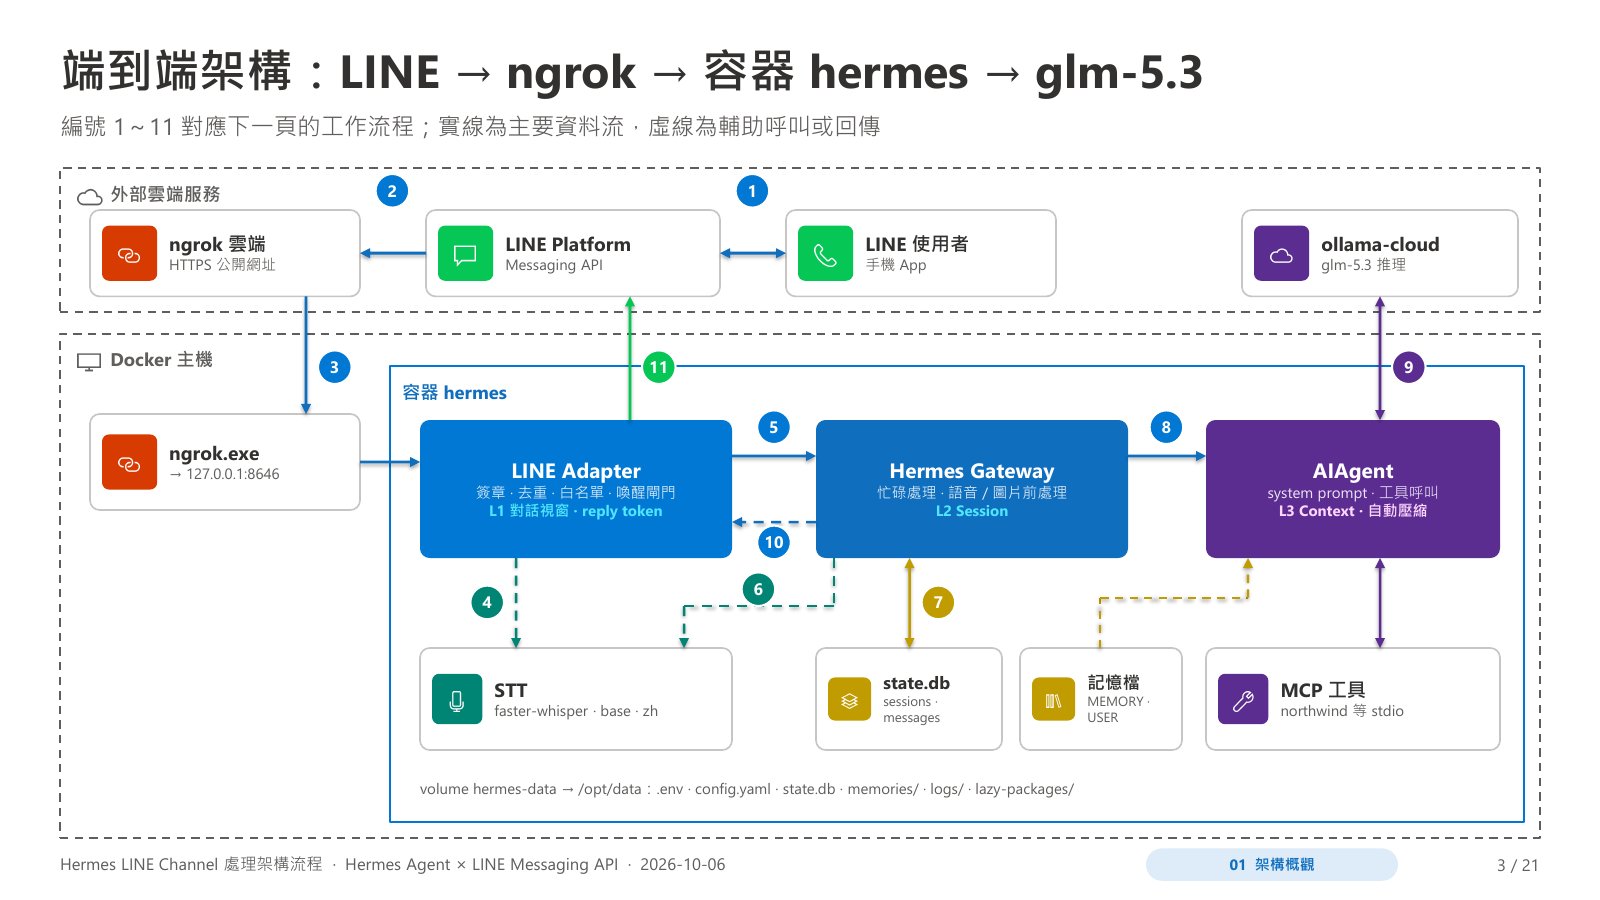
LINE 使用者傳訊息,LINE Platform 以 Webhook 呼叫 ngrok 提供的 HTTPS 公開網址,轉進 Docker 容器 hermes 裡的 LINE Adapter(監聽 127.0.0.1:8646),再交給 Hermes Gateway、AIAgent,由 AIAgent 呼叫雲端模型 glm-5.3(ollama-cloud)與 MCP 工具(例如 northwind)。簡報把一則訊息拆成十一個步驟,所有事件處理完才回 HTTP 200。
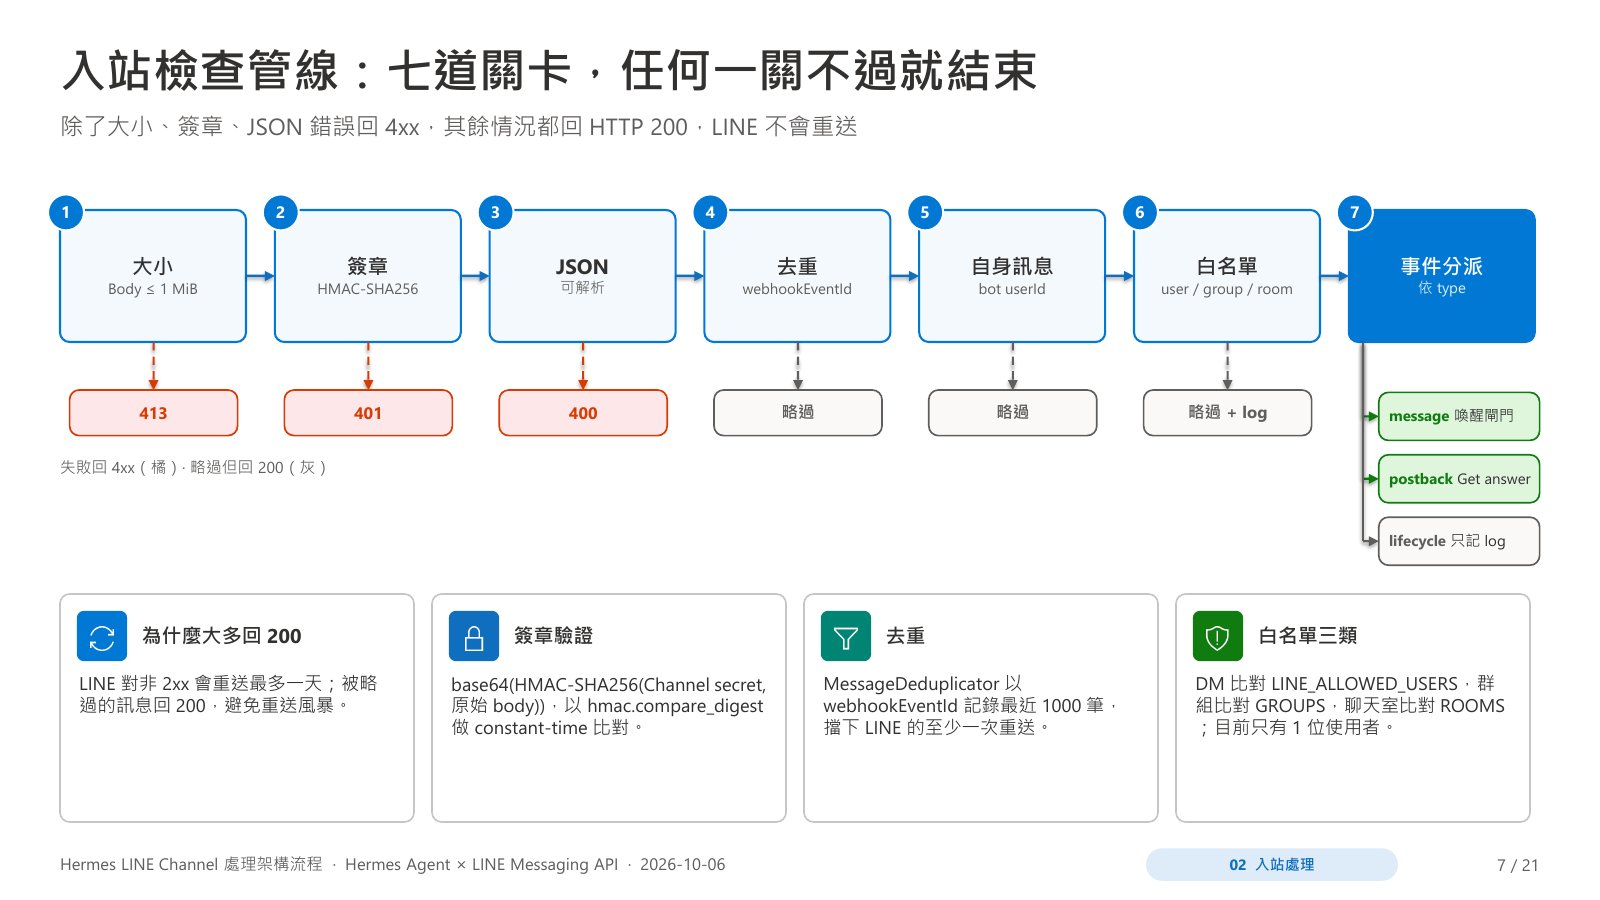
七道關卡依序是:大小(Body 不超過 1 MiB)、簽章(HMAC-SHA256)、JSON 可否解析、去重(以 webhookEventId 記最近 1000 筆)、自身訊息、白名單、事件分派。大小、簽章、JSON 失敗才回 4xx,其餘略過的情況都回 200,避免 LINE 重送。通過後進「喚醒閘門」:文字要含小艾(或 @ 機器人),視窗內則任何訊息都算;沒提到小艾的文字、圖片、貼圖,在下載媒體與暫存 reply token 之前就結束,不呼叫模型。
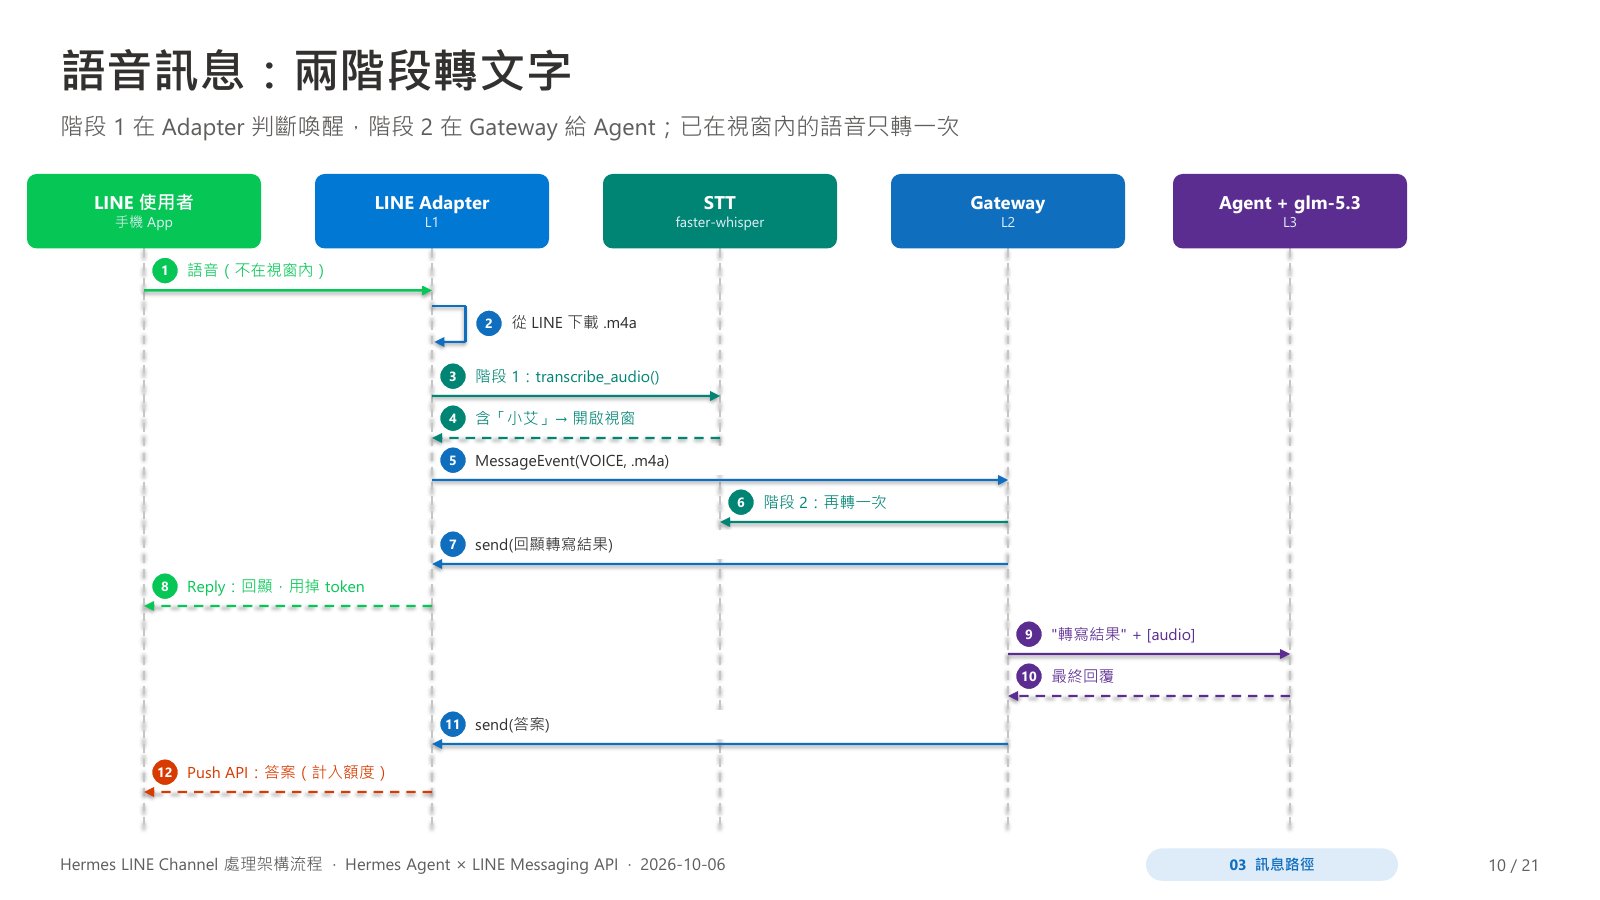
文字:一次通過閘門,Agent 看到原文。語音:視窗外的語音必須先下載並轉文字才知道有沒有提到小艾,所以 Adapter 轉一次、Gateway 再轉一次給 Agent;轉寫回顯預設開啟,會用掉唯一一次的免費 reply token,所以答案改走 Push(計入官方帳號每月額度)。其他媒體:視窗外一律略過,視窗內交給 Agent 處理:圖片在模型支援時直接附圖、否則先轉成文字描述,貼圖與位置轉成文字說明。
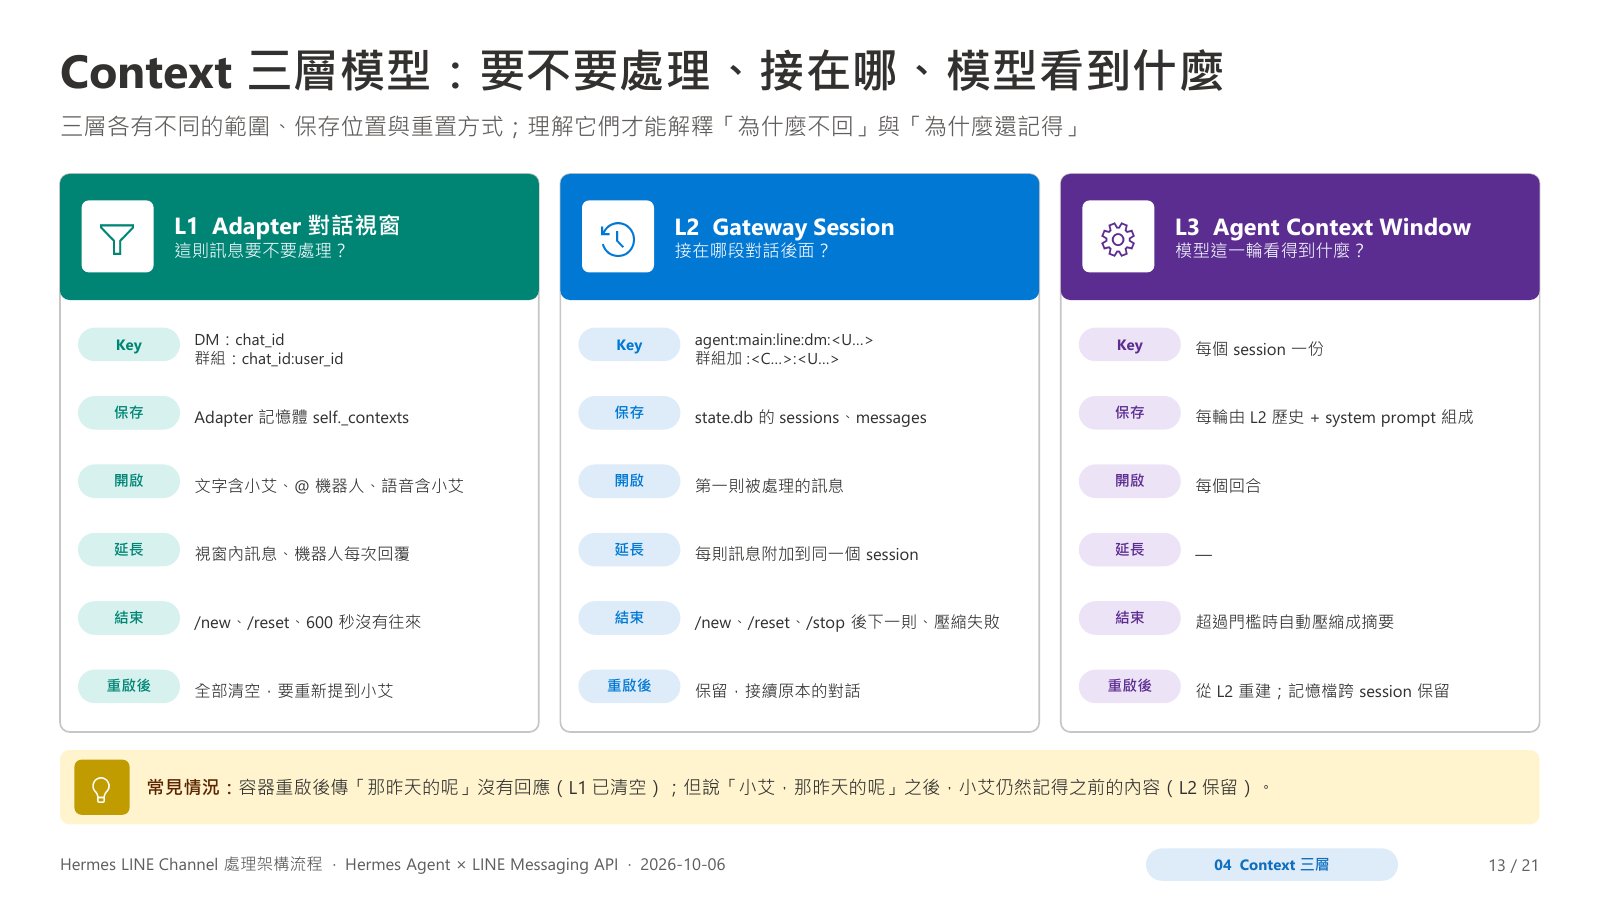
L1 Adapter 對話視窗,決定「要不要處理」:只存在記憶體,600 秒沒往來就關,容器重啟後清空,要重新提到小艾。L2 Gateway Session,決定「接在哪段對話後面」:存在 state.db,重啟保留,不依時間重置,只有 /new、/reset、/stop 或壓縮失敗才會開新 session。L3 Agent Context Window,決定「模型這一輪看到什麼」:每輪由歷史加 system prompt 組成,超過門檻時自動壓縮成摘要(保留前 3 與後 20 則)。簡報舉的例子:容器重啟後傳「那昨天的呢」沒有回應(L1 已清空),但說「小艾,那昨天的呢」就還記得之前的內容(L2 保留)。
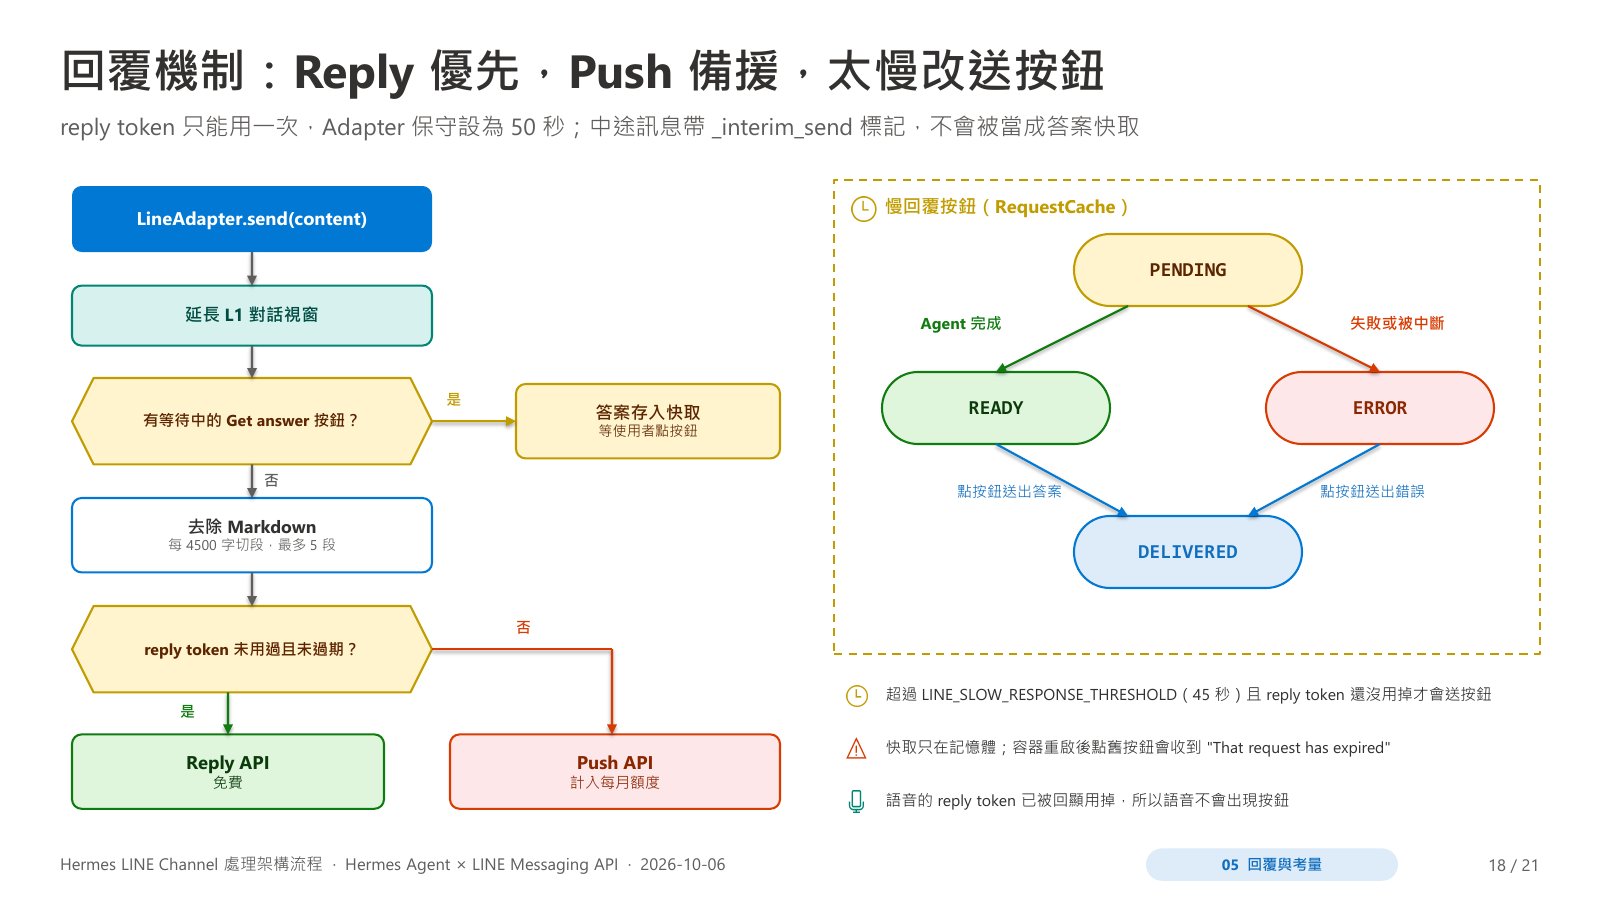
Reply 優先、Push 備援。reply token 只能用一次,Adapter 保守設為 50 秒;token 沒用過且未過期就走免費的 Reply API,否則走 Push API。回覆太慢(超過 45 秒且 reply token 還沒用掉)會改送「Get answer」按鈕,使用者點了才送出答案;按鈕的快取只在記憶體,容器重啟後點舊按鈕會收到過期訊息。語音因 reply token 已被回顯用掉,所以不會出現按鈕。
限制:L1 視窗不持久化;視窗外的語音轉兩次;目前只能回文字(回傳圖片與語音需要設定 LINE_PUBLIC_URL);ngrok 免費方案重啟會換網址。後續:用真實 LINE 訊息做端對端測試、確認 MCP 工具呼叫是否正常、改用固定 HTTPS 網域,並評估把 stt.echo_transcripts 設為 false,讓語音答案能用免費 Reply。
接續前兩堂:第 8 堂(Hermes 串 LINE Bot)、第 9 堂(用 LINE 查企業資料庫)。
第 11 堂
Hermes × Hindsight:把 Agent 的記憶外掛到 PostgreSQL
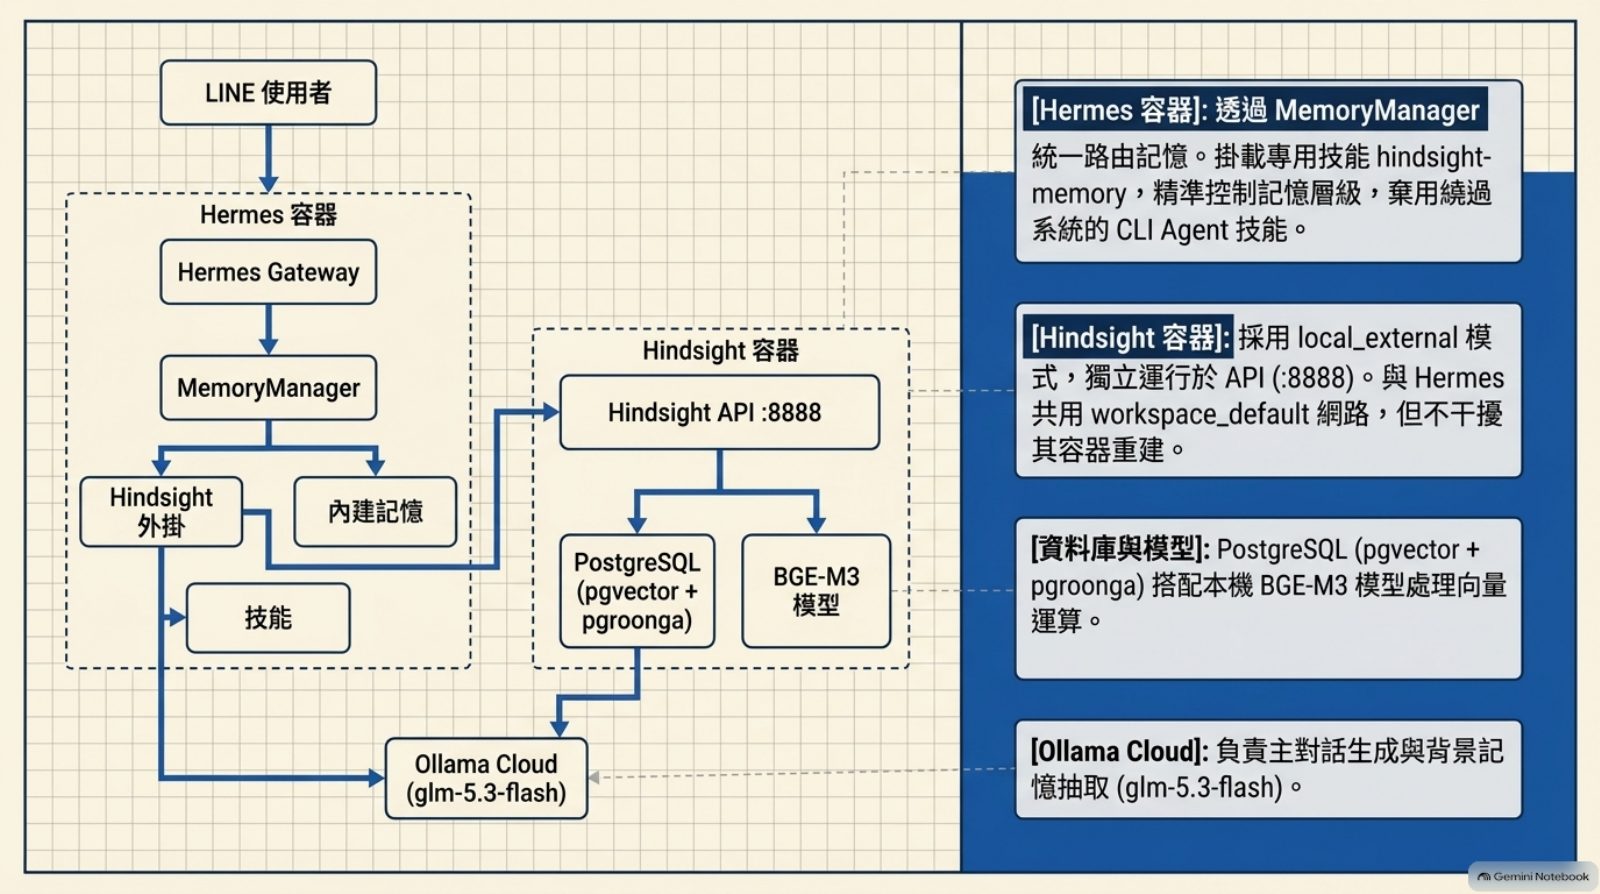
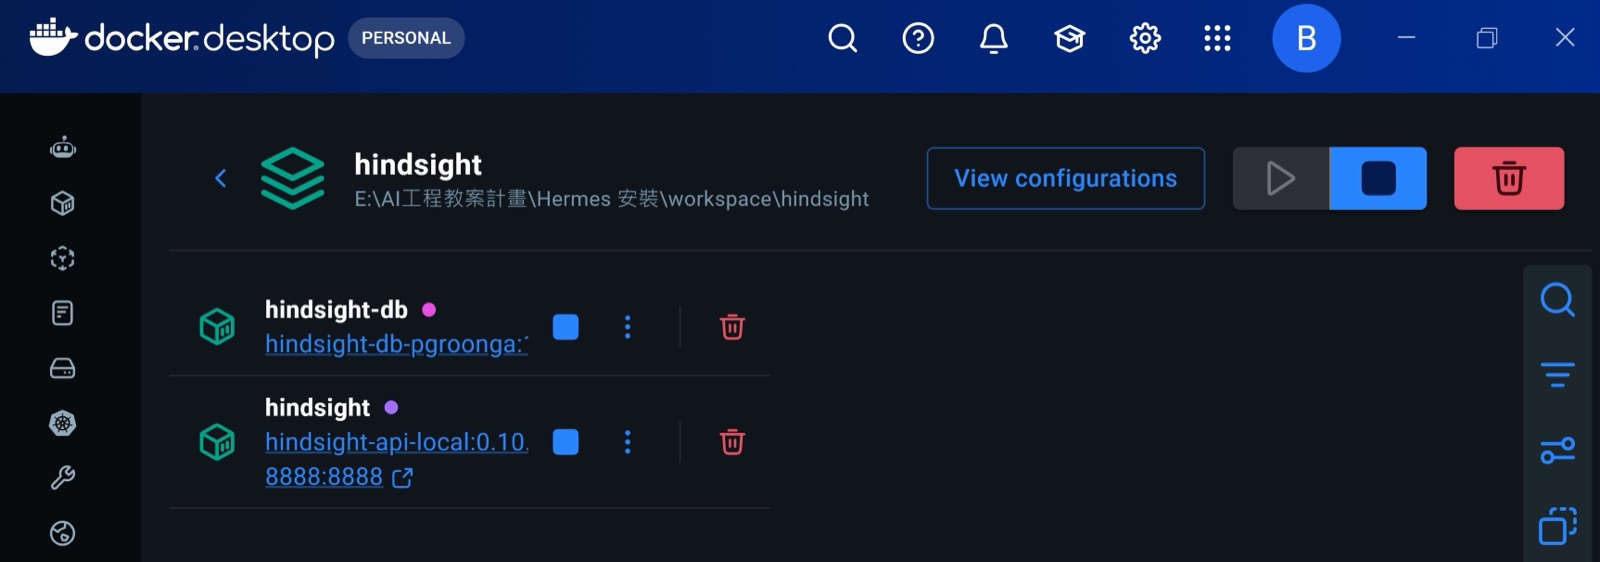
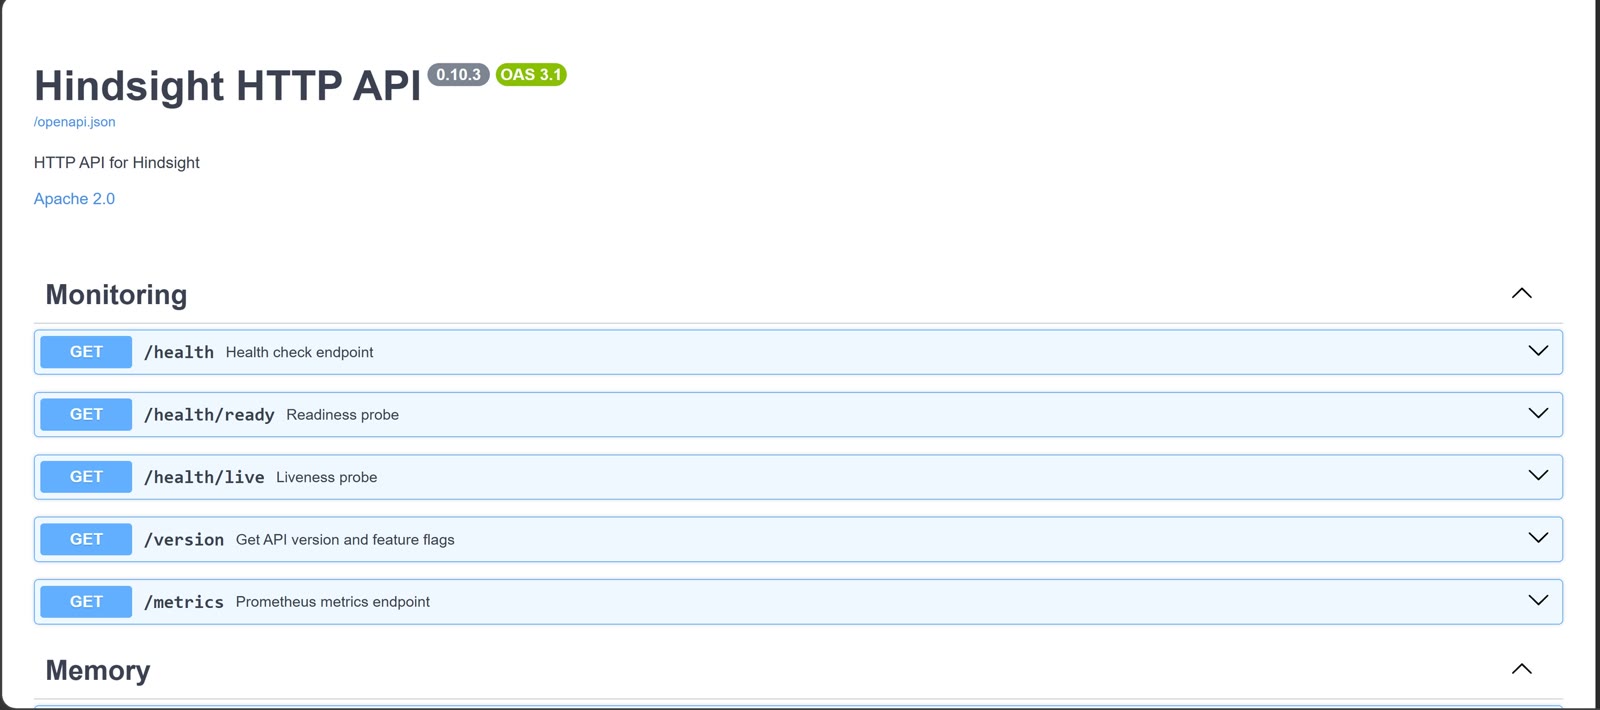
Hermes(nousresearch/hermes-agent v0.21.5)原本的記憶是幾個 Markdown 檔,在開場時整份塞進提示詞。老師把它外掛到開源記憶服務 Hindsight:在自己電腦用 Docker 跑兩個容器,一個是 Hindsight 的 Web API(127.0.0.1:8888,附 Swagger 文件頁),一個是裝了 pgvector 與 pgroonga 的 PostgreSQL。他說自己是開發者角色,AI Agent 的配置常常是黑箱,他要每個設定都掌握得到、改過都能回溯。這一堂整理他的示範影片、兩張實機截圖和一份 14 頁簡報。
系統架構圖解 HindSight Memory 配置(OjYX5gCMSKM,約 15 分鐘):Hermes 與 Hindsight 的配置與運行。
容量到頂:核心記憶檔 MEMORY.md 已經用到 2,154/2,200 字元,再也塞不下。資訊過時:舊的錯誤記憶(簡報舉 Northwind 資料庫的例子)不會自己被覆寫,每個 session 都拿出來誤導 Agent。狀態凍結:記憶只在 session 開頭注入一次,對話中途記下的東西要等下一個 session 才看得到。老師在群組補充了他的情況:他自己規劃了一套 MCP,提供工具去存取另一個容器裡的 SQL Server 資料庫,這類工作的記憶很快就把只有 2,200 字元的內建記憶撐爆,所以需要 RAG 架構的外掛記憶來補強。
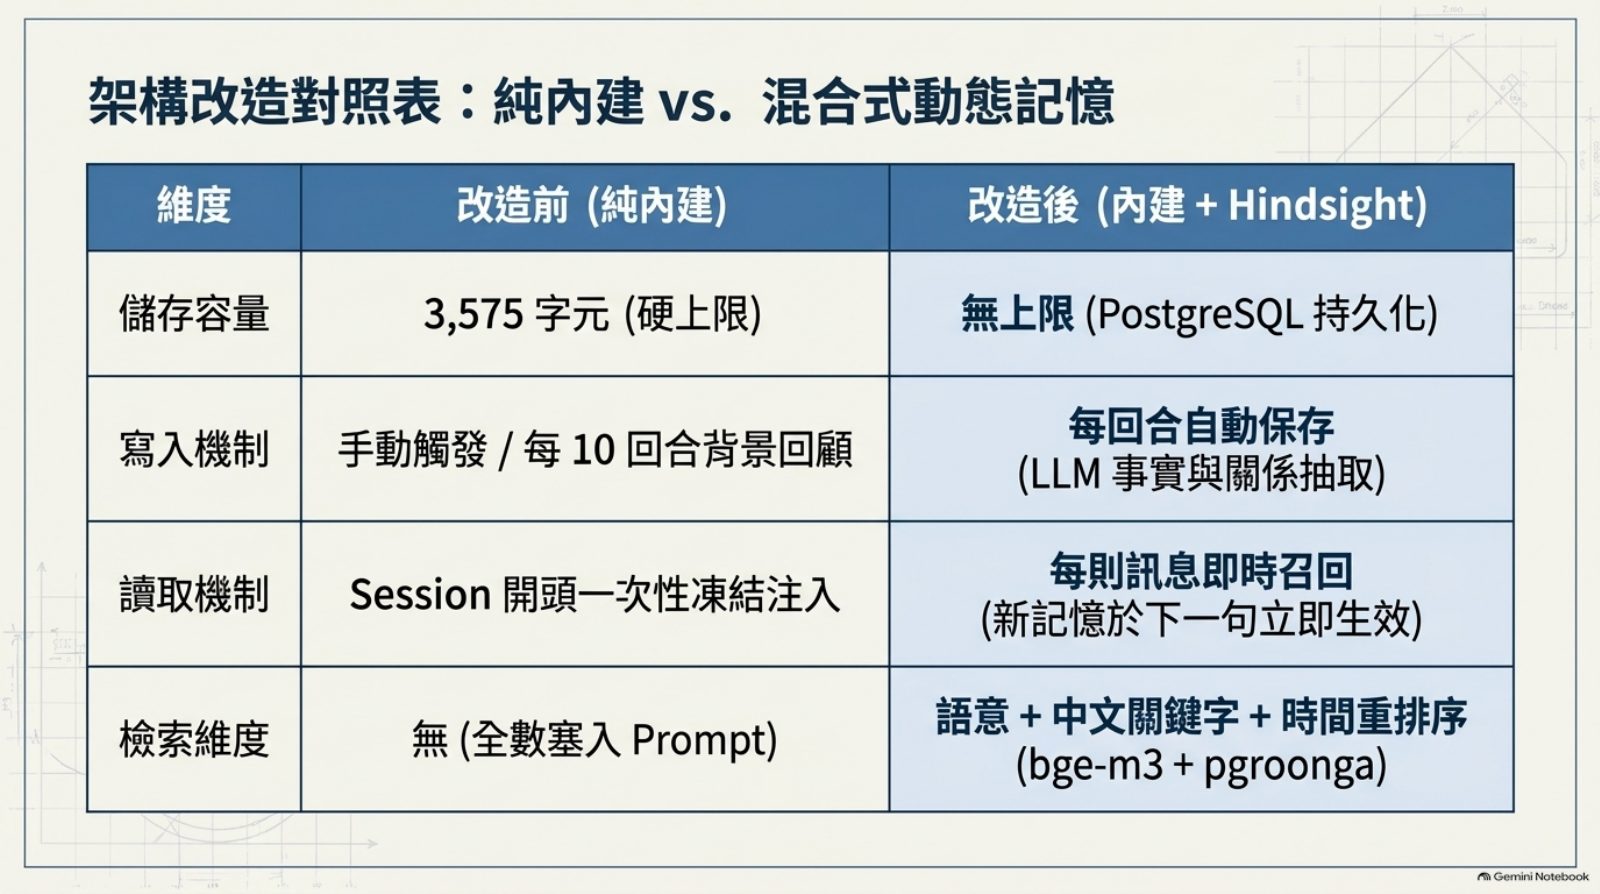
儲存容量:內建有硬上限(簡報對照表寫 3,575 字元),改成存在 PostgreSQL 就沒有上限。寫入:原本要手動觸發或每 10 回合背景回顧一次,改成每回合自動保存,由 LLM 從對話抽出事實與關係。讀取:原本只在 session 開頭注入一次,改成每則訊息即時召回,剛記下的事下一句就用得到。檢索:原本沒有檢索、整份塞進提示詞,改成語意加中文關鍵字再依時間重排序(bge-m3+pgroonga)。
LINE 訊息進 Hermes 容器,經 Hermes Gateway 交給 MemoryManager,由它同時路由給 Hindsight 外掛和內建記憶。Agent 用專門寫的 hindsight-memory 技能存取記憶(recall 召回、retain 保存、reflect 整理),不用官方的 CLI Agent 技能,並明確禁止 Agent 自己用 curl 打 API,避免繞過記憶庫。Hindsight 容器用 local_external 模式獨立跑 API,和 Hermes 共用 workspace_default 網路,但 Hermes 重建時不受影響;裡面是 PostgreSQL 加本機 BGE-M3 模型算向量。對話生成和背景抽取都交給 Ollama Cloud 的 glm-5.3-flash。外掛狀態放在 /opt/data/plugins/hindsight,Hermes 容器整個重建也不會遺失。老師捨棄了要綁帳號的 Cloud 模式,也捨棄了唯讀環境裝不了 pgroonga 的 Embedded 模式,所以選 local_external,讓控制權都在本機。
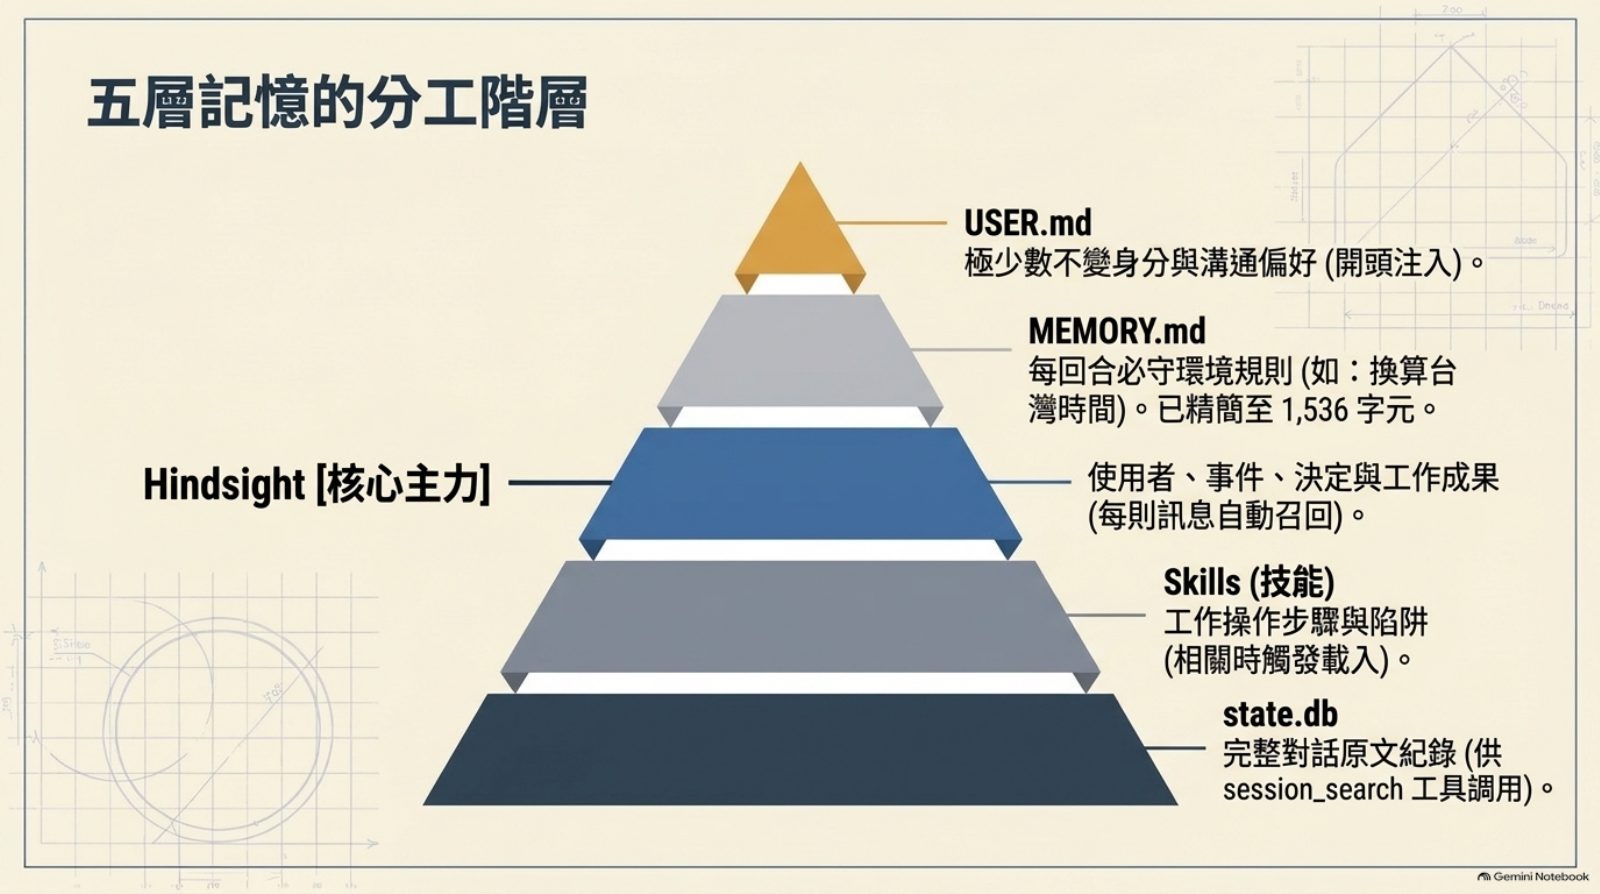
USER.md 只放極少數不變的身分與溝通偏好,開頭注入。MEMORY.md 放每回合都要守的環境規則(例如換算成台灣時間),已精簡到 1,536 字元。Hindsight 是主力,存使用者、事件、決定與工作成果,每則訊息自動召回。Skills 放操作步驟與陷阱,相關時才載入。state.db 存完整對話原文,給 session_search 工具查。
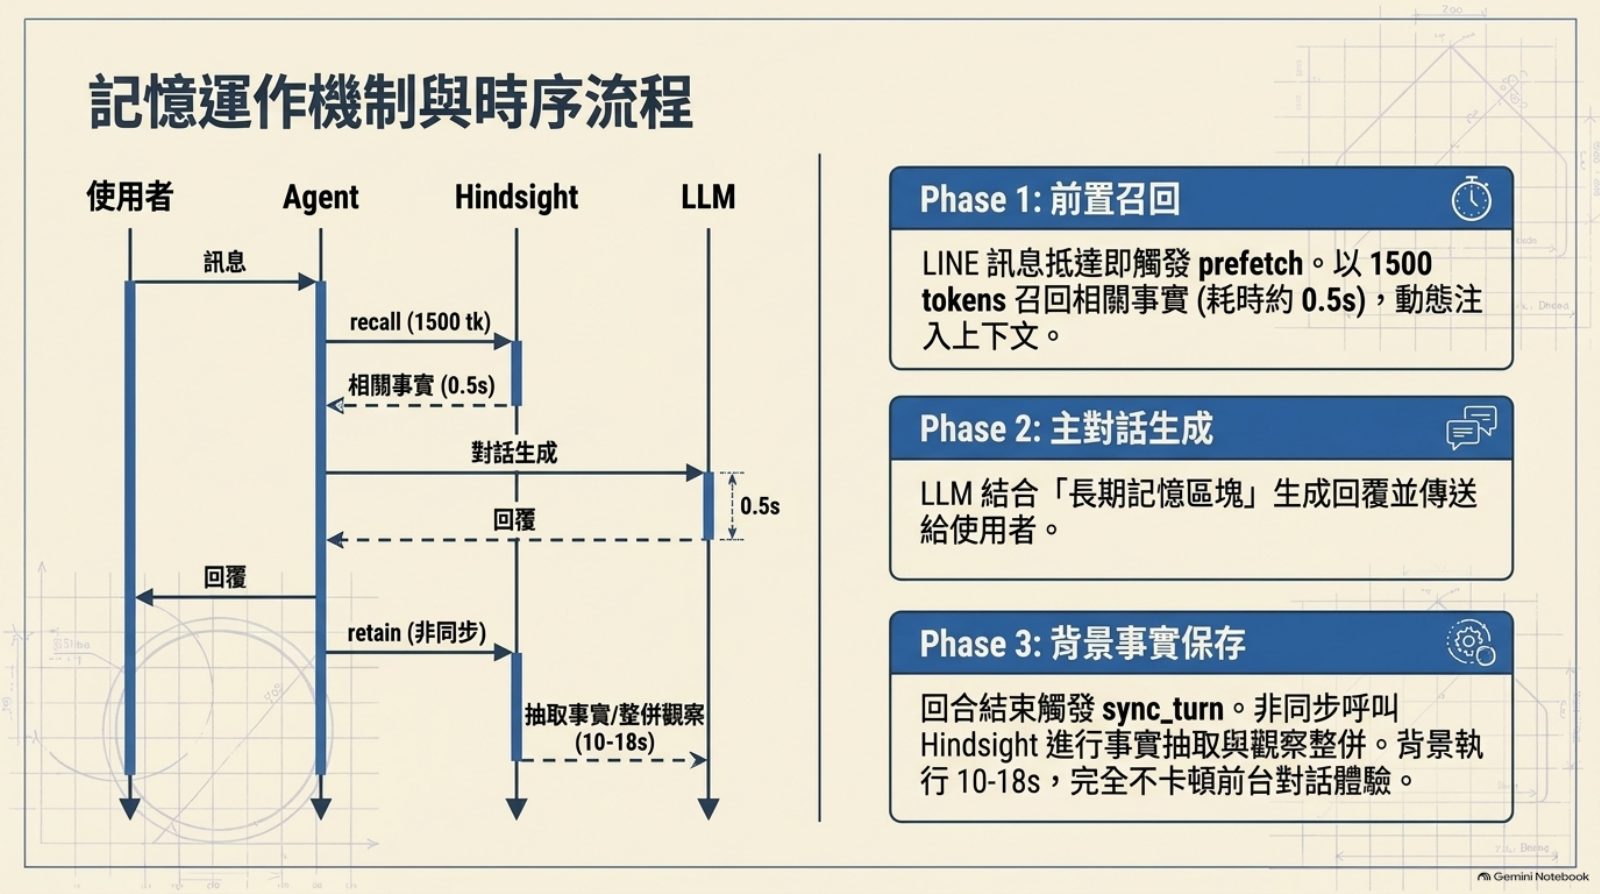
前置召回:LINE 訊息一到就先 prefetch,用 1,500 tokens 的額度召回相關事實,約 0.5 秒,動態放進上下文。主對話生成:LLM 帶著這塊長期記憶產生回覆。背景保存:回合結束觸發 sync_turn,非同步請 Hindsight 抽取事實、整併觀察,約 10 到 18 秒,不卡住前台對話。設定上有三個關鍵:recall_sync 設 true,解決預設背景召回造成的「記憶慢一則」,適合 LINE 這種稀疏的對話節奏;recall_types 收 observation、world、experience 三類,讓一次性的行程也找得回來;recall_indicator 設 false,不在 LINE 跳出英文的狀態訊息。
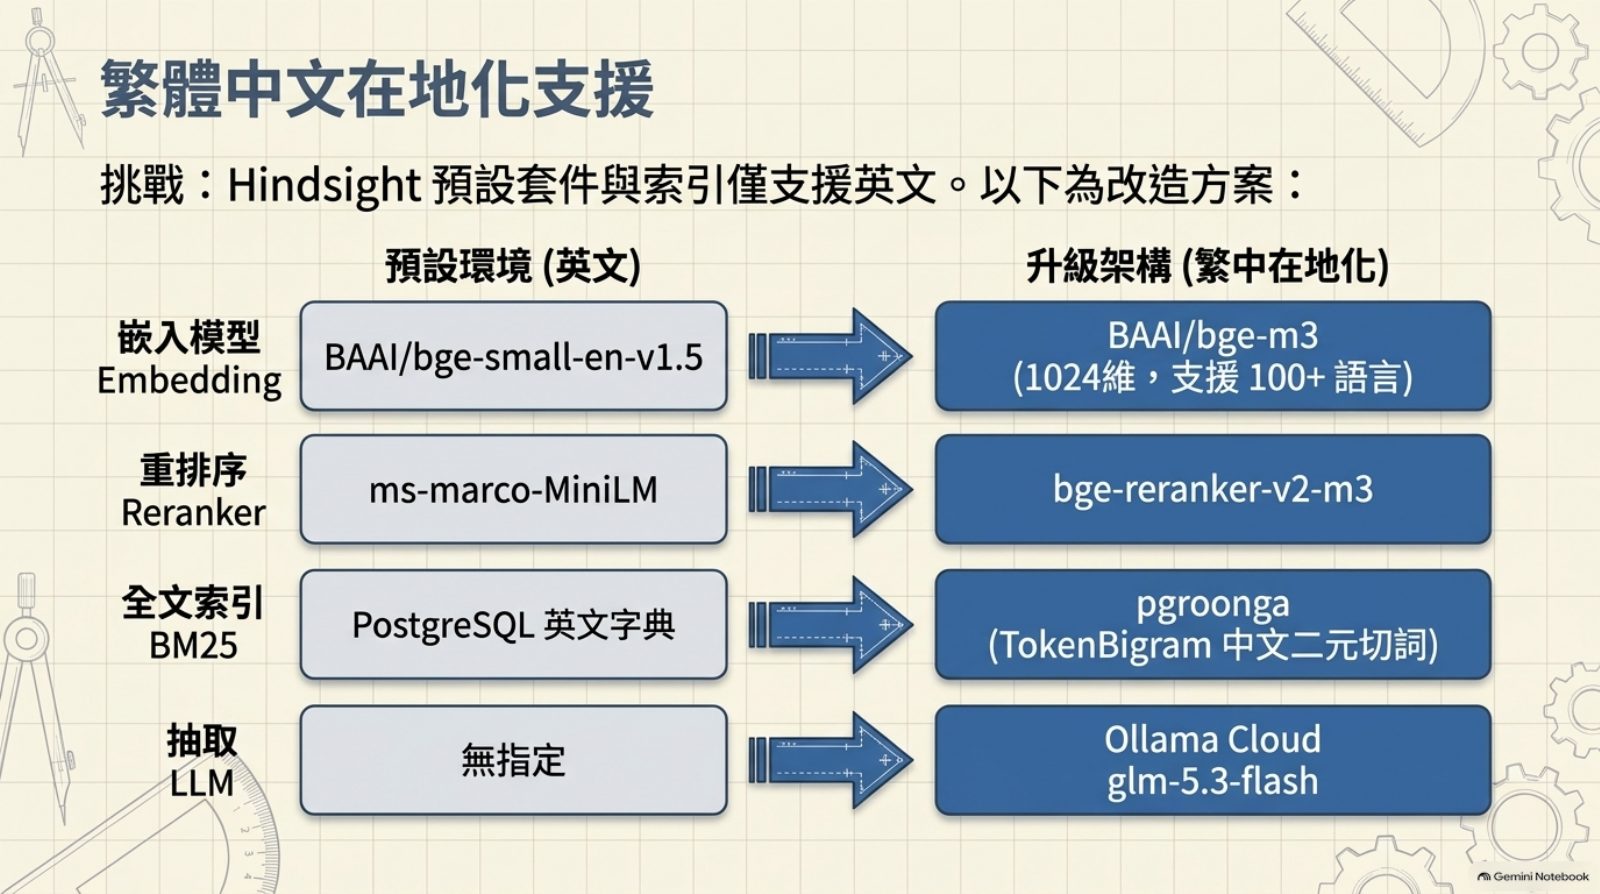
Hindsight 預設的套件與索引只支援英文,老師換掉四樣:嵌入模型 bge-small-en-v1.5 換成 BAAI/bge-m3(1024 維、支援 100 多種語言);重排序 ms-marco-MiniLM 換成 bge-reranker-v2-m3;全文索引從 PostgreSQL 英文字典換成 pgroonga(TokenBigram 中文二元切詞);抽取用的 LLM 原本沒指定,改用 glm-5.3-flash。實測檢索 0.4 到 0.6 秒、背景保存約 18 秒(約 6.2K tokens,對話不延遲),記憶庫約佔 3.2 GiB,大多是本機模型。示範裡問「我下週要去哪裡」,能答出日期正確的行程,「下週三」也正確換算成實際日期。
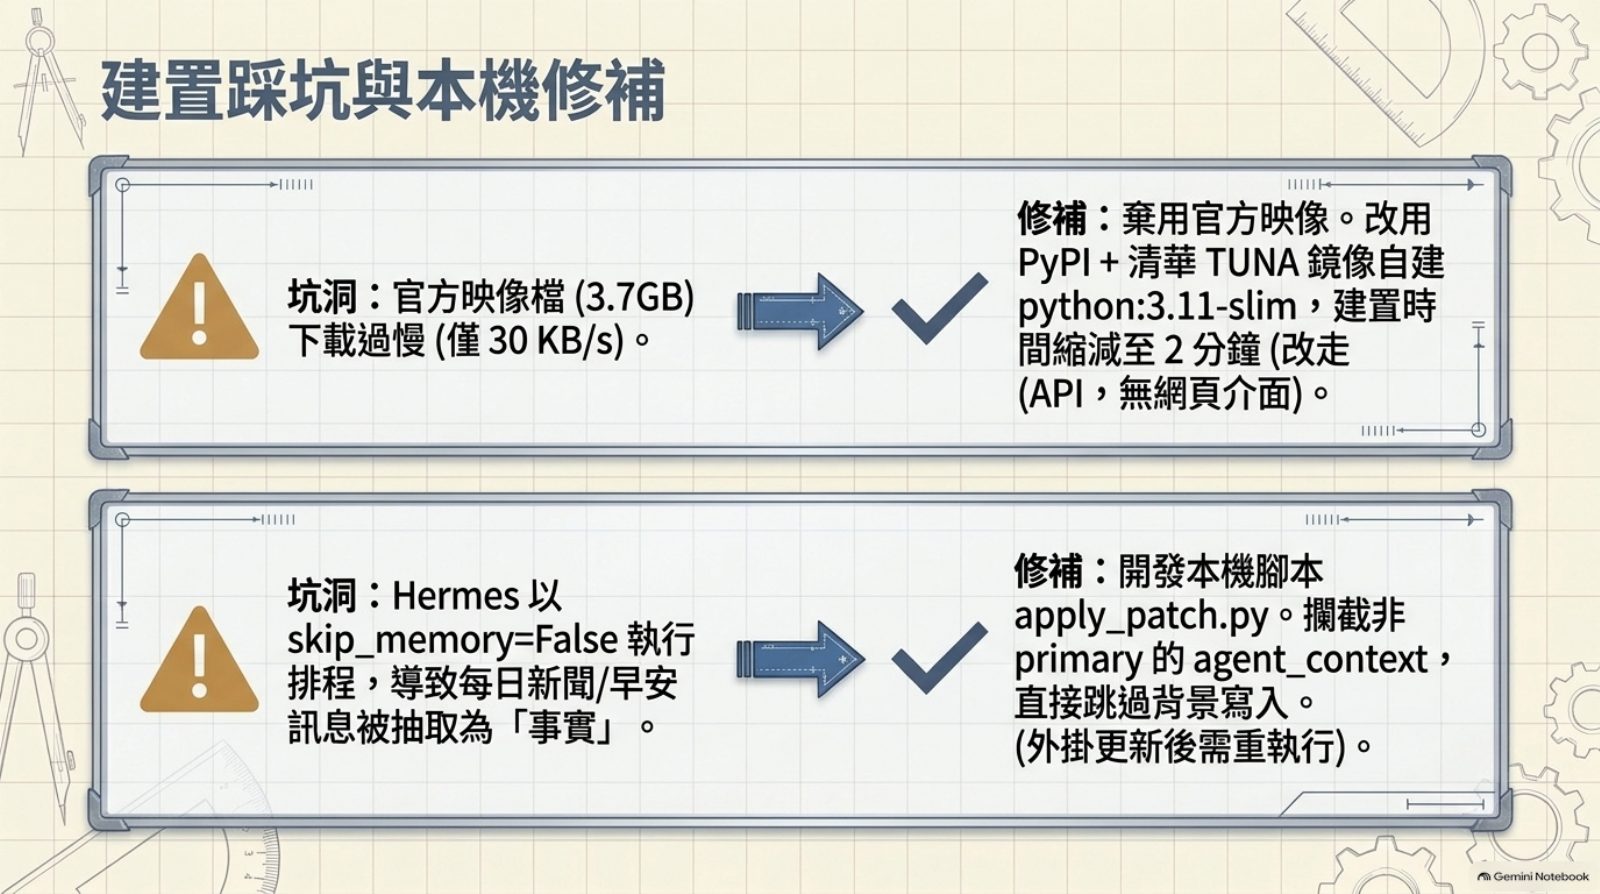
官方映像檔 3.7 GB 只抓得到 30 KB/s,改用 PyPI 加清華 TUNA 鏡像從 python:3.11-slim 自建,2 分鐘建好(只有 API、沒有網頁介面)。Hermes 的排程以 skip_memory=False 執行,每天的新聞、早安訊息都被當成「事實」存進去,他寫了 apply_patch.py 攔下非主要對話的 agent_context、跳過背景寫入(外掛更新後要重跑)。舊記憶先清洗再搬:MEMORY.md 用量原本 97%,修掉 Northwind 幻覺、把長篇 Drive 操作改成一句規則,再用 setup_bank.py --seed 匯入 11 個乾淨條目(標記 migrated-20261009),MEMORY.md 降到 70%。退路:拿掉 config.yaml 的 provider: hindsight 再重啟 Hermes,就回到純內建記憶,資料仍留在 volume。接下來要觀察 Ollama Cloud 的抽取成本(必要時調 retain_every_n_turns),並觀察一週,評估何時把內建記憶整個關掉。
同一天群組裡也有人說,他的 Hermes 還是用原生記憶,因為只有一兩個人在用、目前夠用,也怕改壞。這和老師的動機剛好對照:內建記憶的問題要等到記憶檔快滿、舊資訊開始誤導 Agent 時才會浮現,使用人數少、記憶量小時,原生方式通常就夠。真的要換,老師這套也留了退路,拿掉一行設定就能回到原狀。
接續前面的 Hermes 系列:第 8 堂(Hermes 串 LINE Bot)、第 10 堂(LINE Channel 處理架構)。