第 1 課
業界流程總覽
傳統影視與微短劇的七階段生命週期、時程壓縮與交接產物鏈。
把微短劇與傳統影視的製作 SOP,翻成「一個人+一組 AI 工具」也能照做的流程。每一步附業界來源、我們的理解,以及《星期少女》第一支 MV 的實際做法。
說明:生圖與生影片模型的選型、參數與實測,等第一支 MV 做完後另開一章分享。本版先把流程、關卡與交接格式講清楚。
圖示:示意圖全部依來源重繪,不轉貼原圖,每張圖下方標來源;引用卡的縮圖是該文章的公開預覽圖,點了回原文。
Ctrl/Cmd + 滾輪縮放・滾動平移・拖曳移動・雙擊重設
一句話:AI 短片不是一鍵生成,是把「拆鏡、定角色、做關鍵幀、生影片、後製、聲音字幕」串成可重複的流程;一致性靠文件與關卡守住,不靠運氣。
傳統影視與微短劇的七階段生命週期、時程壓縮與交接產物鏈。
敘事經濟學:單集 1〜3 分鐘閉環、黃金三秒與付費卡點設定。
一個人+AI 工具鏈的七道關卡、文字錨點優先與出包防線。
每階段七份關鍵文件的標準欄位、命名規則與鏡頭卡範本。
《星期少女》四週一支 MV 的每週里程碑、工時分配與集羣延伸。
三層架構前言、劇本拆鏡、角色設定、場景模板與關鍵幀生成。
普通鏡頭圖生影片、對嘴唱歌、高難度鏡頭專用處理與動作參考。
畫質放大調色、韓文歌曲生成、ASR 字幕對位與最終剪輯輸出。
集中收錄全書 16 篇核心文獻與十三步 45 篇外部實務文章對照。
本版待查項目、專有名詞對照表、版本修訂紀錄與版權宣告。
傳統影視(電影、影集)與微短劇的差別,不在技術,在時程被壓到多短、以及每一段交什麼東西給下一段。先看傳統的五階段與時程,再看微短劇怎麼把同一條線壓扁。
Ctrl/Cmd + 滾輪縮放・滾動平移・拖曳移動・雙擊重設
| # | 階段 | 負責角色(傳統影視) | 負責角色(微短劇/本專案對應) | 輸入 | 產出文件/資產 | 驗收點(誰看、看什麼) | 典型時程(傳統) | 典型時程(微短劇) |
|---|---|---|---|---|---|---|---|---|
| 1 | 開發 | 監製、編劇、企劃、開發主管 | 製作人+主創(同一人) | 市場訊息、IP/題材候選 | 人設書、故事聖經、世界觀文件、系列大綱 | 故事核心能不能一句話說清?人設一致?世界觀自洽? | 數週〜數月 | 1〜3 天 |
| 2 | 劇本 | 編劇、故事編輯 | 編劇(一人) | 大綱、人設書 | 集數大綱→分場大綱→對白稿;微短劇另加集鉤子/卡點清單 | 人物語氣一致?每集結尾有鉤子? | 數週〜數月 | 1〜3 天/集 |
| 3 | 前製 | 副導、製片主任、選角導演、美術指導、分鏡師 | 一人兼副導+分鏡師(生圖模型扮演分鏡) | 定稿劇本 | 分鏡表、鏡頭清單、美術設定、選角清單(=角色提示詞)、通告單、排程表、預算 | 時程與算力預算內做得完?分鏡涵蓋所有對白鏡頭? | 3〜6 個月 | 1〜2 天/集 |
| 4 | 製作 | 導演、攝影、收音、場務、美術陳設 | 一人+AI 工具鏈(生圖/生影片) | 分鏡表、素材、通告單 | 每日產出素材、場記表、素材命名與歸檔 | 每日產出達標?照命名規則?有沒有連戲問題? | 3〜8 週 | 整部兩週內;本專案四週一支 1.5 分鐘 MV |
| 5 | 後製 | 剪接、調色、音效、配樂、混音 | 一人+AI 配音/配樂 | 素材、對白稿、配樂參考 | 粗剪→精剪→畫面鎖定→調色→配音配樂音效→字幕→交片 | 節奏對?動機清楚?色彩一致?混音平衡? | 數日〜數月 | 1〜3 天 |
| 6 | 發行與數據 | 發行商、行銷、平台關係 | 行銷(一人) | 交片檔、平台規格 | 上架素材(標題、縮圖、字幕檔)、投放素材、數據回饋表 | 完播率、互動率、付費轉化達標? | 同步進行 | 上架後 24〜72 小時回收首批數據 |
| 7 | 品管(貫穿) | 各階段主管 | 製作人 | 每階段產物 | 稽核紀錄、版本紀錄 | 過關才准進下一階段 | — | — |
Ctrl/Cmd + 滾輪縮放・滾動平移・拖曳移動・雙擊重設
微短劇(中國大陸稱「短劇」,海外平台如 ReelShort、DramaBox)與傳統影視最大的差別,在敘事經濟學:每集 1〜3 分鐘,整季長度約等於一部電影;製作成本極低,但對「鉤子與卡點」的依賴極重。
Ctrl/Cmd + 滾輪縮放・滾動平移・拖曳移動・雙擊重設
中國短劇常見元素:穿越、穿書、修仙、外掛系統、霸總、贅婿、龍傲天、真假千金、庶嫡衝突、逆襲、因果報應。這些是「爽文」的敘事引擎。
《星期少女》是 19〜23 歲女性的選集,走的不是霸總路線;但每集鉤子、黃金三秒、付費卡點這套結構跟題材無關,照樣沿用。台灣受眾對爽文題材的接受度,目前沒有可靠的公開調查,列在附錄待查。
| 模式 | 怎麼收錢 | 代表 | 對製作端的影響 |
|---|---|---|---|
| Freemium | 前幾集免費,之後買虛擬幣解鎖;幣可看廣告取得 | ReelShort、DramaBox | 卡點集要排在第 8〜12 集,且是情緒高點 |
| 廣告分潤(IAA) | 平台廣告分潤,需先達到觀看門檻 | YouTube Shorts、TikTok、IG Reels | 完播率決定推薦,前 3 秒最重要 |
| 自媒體發布 | 先不收錢,累積作品與受眾 | 本專案目前的路線 | 每一支都是作品集,品質優先於數量 |
| 平台 | 長度上限 | 比例 | 解析度 | 字幕 |
|---|---|---|---|---|
| YouTube Shorts | 3 分鐘 | 直式 9:16 | 1080×1920 | 必加 |
| IG Reels | 依帳號 90 秒或 3 分鐘(待查最新政策) | 9:16 | 1080×1920 | 必加 |
| TikTok | 最長 10 分鐘;60〜90 秒表現最好 | 9:16 | 1080×1920 | 必加 |
| ReelShort/DramaBox | 單集 1〜3 分鐘 | 9:16 | 1080×1920 | 必加 |
把業界七階段翻成我們的動作,並標清楚哪些「AI 整段接」、哪些「一定要人看」。這一課不談模型選型,只談關卡在哪。
| 階段 | 業界動作 | 星期少女的動作 | AI 整段接? | 一定要人看的理由 |
|---|---|---|---|---|
| 1. 開發 | 故事聖經、人設書 | 角色設定文件(人設、三圍、錨點、紅線)+角色設定頁 | 人設由製作人裁示、AI 落筆 | 世界觀與角色口吻是主觀判斷;「不為男性凝視設計」是設計約束 |
| 2. 劇本 | 大綱→分場→對白 | 每位少女一支 MV:歌詞(跟角色國籍的語言)→段落時間碼→分鏡表 | AI 初稿;製作人改稿定稿 | 七個人各自一天、選集不是群像,口吻是核心 |
| 3. 前製 | 分鏡、鏡頭清單 | 歌定稿後照段落時間碼排分鏡表,每鏡頭一張分鏡圖(一張圖一個人一個動作) | AI 生候選;製作人挑鏡頭 | 情緒與節奏 |
| 4. 製作 | 拍攝 | 每晚照週計劃生 3 個鏡頭、每個 3〜4 秒、每鏡頭 3〜4 版 | AI 生;樣片室每天看一眼 | 人物一致性、表情、手部最容易出包 |
| 5. 後製 | 粗剪→精剪→配音配樂→字幕 | 對拍、補鏡頭、字幕(語音辨識對時間軸)、出片閘 | 配音、配樂、字幕 AI 接;剪接節奏一定要人 | 節奏是作品差異化的核心 |
| 6. 發行 | 上架、縮圖、投放 | 先不公開上傳+播放清單,原始檔進雲端硬碟;正式公開另裁 | AI 上傳;製作人決定公開 | 對外發布屬事前要問的那類 |
| 7. 品管 | 階段審核、版本管理 | 三面圖/表情/動作逐張審;參考圖換版就要重推提示詞;一件事一頁審核頁 | 人 | AI 沒有觀眾視角 |
Ctrl/Cmd + 滾輪縮放・滾動平移・拖曳移動・雙擊重設
業界手冊主張「建角色資產庫、每個鏡頭 @ 引用同一張圖」。我們實測後選了相反的路:文字錨點優先,參考圖只在編修既有圖時當底圖。原因是參考圖在不同引擎之間會漂,引擎換了參考圖就沒用了;文字錨點寫進提示詞,換引擎也帶得走。
Ctrl/Cmd + 滾輪縮放・滾動平移・拖曳移動・雙擊重設
下面每張表都是一份檔案的欄位清單,填進試算表、Markdown 或筆記軟體都可以。檔名規則:wg_<專案>_<階段>_<集或鏡頭>_<日期>_<版次>.<副檔名>,例如 wg_wgs_ep01_script_v0.3.md。
Ctrl/Cmd + 滾輪縮放・滾動平移・拖曳移動・雙擊重設
wg_<ip>_bible_v<ver>.mdwg_<ip>_ep<E##>_script_v<ver>.mdwg_<ip>_ep<E##>_shotlist_v<ver>.csvE01_S02_C03.png)。/wg-prod/<ip>/ep<E##>/,底下 script/、shotlist/、storyboard/、video_raw/、audio_raw/、editorial/E##_S##_C##_v<ver>.<ext>,每鏡頭可有多版(_v1、_v2、_selected)E##_S##_C##_still_v<ver>.png|配音:E##_S##_C##_voice_<char>_v<ver>.wav|配樂:bgm_<mood>_<bpm>_v<ver>.wavdaily_log_<date>.md:今天產出幾個鏡頭、幾支配音、遇到什麼問題。wg_<ip>_ep<E##>_edit_v<ver>.prproj 或 .fcpxmlwg_<ip>_ep<E##>_release_v<ver>.md# Shot Card — E01_S02_C03- 集:E01- 場景:S02(深夜房間書桌,檯燈亮著)- 鏡頭類型:insert(插入)- 秒數:4- 角色:MON(@mon_asset_main)- 畫面描述:攤開的筆記本特寫,筆尖停在半句話上,淺景深,杯子在畫面右下角。- 對白編號:—(純視覺)- 情緒:安靜、懸而未決- 剪輯備註:前接 C02(她坐下),後接 C04(她抬頭看窗外),節奏不超過 4 秒。- 稽核:draft → approved(主創/日期)- 草稿圖:./storyboard/E01_S02_C03_v1.png- 引擎/版次/額度來源:v1 本機|v2 雲端服務(額度 1 支)- 算圖次數:v1 / v2 / selected每位少女一個四週週期,不是一個月七支。週日晚製作人填或改一頁週計劃,每天只看樣片室一眼。
| 週次 | 主題 | 這週的產物 | 驗收點 | 對應業界階段 |
|---|---|---|---|---|
| W1 人設打底 | 角色設定頁、逐張生成的三面圖/表情九宮格/動作六格、第二輪獨立審核;人體比例參考 | 設定頁一頁、每張圖單獨過審 | 一張圖一個人一個動作;錨點與體型照合約;不為男性凝視 | 開發+前製(美術設定) |
| W2 聲音 | 一首 90 秒的歌(本機生成),歌詞語言跟角色國籍;配音;人聲分離 | 歌定稿+段落時間碼 | 唱出來的詞不一定等於送進去的詞,要實聽;商用授權先確認 | 劇本(對白=歌詞)+後製前段(配樂先行) |
| W3 動畫 | 先照時間碼排分鏡表,再每晚生 3 個鏡頭、每個 3〜4 秒、每鏡頭 3〜4 版 | 分鏡表;每晚 3 鏡頭的樣片 | 分鏡圖過靜幀稽核才准生影片;影片生成額度是硬上限,超過就排到明天 | 前製(分鏡)+製作 |
| W4 剪接 | 補鏡頭、對拍、字幕、定稿、發布(先不公開+原始檔進雲端) | 粗剪→精剪→畫面鎖定→出片閘通過 | 字幕時間軸取語音辨識實聽時刻,不按字數平均分;對外公開另裁 | 後製+發行 |
Ctrl/Cmd + 滾輪縮放・滾動平移・拖曳移動・雙擊重設
若從「支」轉成「集」(例:30 集 × 90 秒),把單集排程擴展成集羣排程:
| 階段 | 動作 | 排程 | 備註 |
|---|---|---|---|
| 開發 | 故事聖經、整季大綱(30 集) | 1 週 | 30 集的情節弧、人物關係圖 |
| 劇本 | 全 30 集對白稿 | 1〜2 週 | 一次寫完,避免後面的集被前面綁死 |
| 前製 | 角色資產(全部角色)+場景設定稿+鏡頭清單 | 1 週 | 場景重用:30 集共用的場景數要小 |
| 製作 | 生圖+生影片(約 24 鏡頭 × 30 集 = 720 段) | 2〜3 週 | 目標每集一天 |
| 後製 | 粗剪→精剪→調色→配音→配樂→字幕 | 1〜2 週 | 集與集之間風格要一致 |
| 發行 | 平台分批上架(每週 3〜5 集連發) | 持續 | 付費卡點集必須排在第 8〜12 集位 |
| 數據回饋 | 完播率、互動率、付費轉化 | 上架後 24〜72h | 回寫下一批劇本 |
以《黃果》AI 短劇製作流程線(進階版,自由工坊整理)的三層十三步為骨架,逐步對應到《星期少女》星期一 MV:每一步寫原圖在做什麼、業界怎麼做(附日文、韓文、中文的外部引用與中文翻譯)、我們怎麼對應、現在做到哪。
Ctrl/Cmd + 滾輪縮放・滾動平移・拖曳移動・雙擊重設
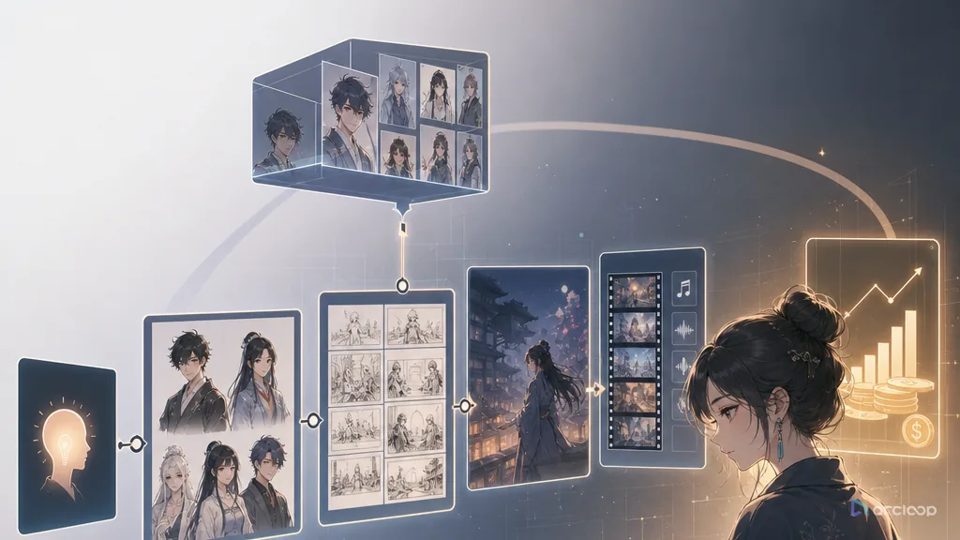
用 LLM 將劇情拆成鏡頭、角色、場景、動作、台詞、情緒;劇本 → 鏡頭清單(Shot_001…)。
業界把劇本拆鏡分成兩個層次:先用文字把整支影片的敘事切成起承轉合的大段落(日本傳統絵コンテ流程叫「シナリオ整理→コマ割り」),再把每個大段落切成可執行的鏡頭卡,每張卡標好景別、動作、對白與生成用的提示詞。日本傳統動畫製作把這道工序切成「整理劇本→決定分鏡格數→畫絵コンテ」三步,AI時代的做法是把最後一步交給模型或平台自動生成鏡頭卡(如ArcLoop的Generate Shots)。中國短劇工業化流程進一步把分鏡表結構化成固定欄位的表格(鏡頭、時長、場景描述、文生圖提示詞、圖生影片提示詞、備註),讓下游AI工具可以直接讀表生成。日本AI創作者在鏡頭語言上也強調構圖法則(如三分法)要寫進提示詞,不能只靠模型自由發揮。
歌詞代替劇本:照韓文歌詞的段落(前奏/主歌/導歌/副歌/尾奏)拆成 22 格,每格寫景別、動作、運鏡、做法(生成/靜態推拉/對嘴/同支裁)。歌還沒選定,所以先照歌詞句排、不排秒數。
ステップ①シナリオを整理:まずは動画のシーン・動き・セリフを簡単な文章で表しましょう。『イントロ(導入部分)→本編→締め』という3つの流れに分ける方法が効率的です。
步驟①整理劇本:先用簡單的文字把動畫的場景、動作、台詞表達出來。分成『導入(Intro)→本篇→收尾』三段的做法比較有效率。
對我們的啟示:我們22格分鏡也可以先按「導入(河邊獨白)→本篇(回憶/情緒推進)→收尾(離別/釋然)」三段大結構分組,再往下拆每一格,而不是一格一格硬想。
ルール・オブ・サードは画面を水平・垂直に3等分し、交点部分に被写体を配置する撮影手法です。
三分法構圖是把畫面水平垂直各三等分,把被攝主體放在交叉點上的一種拍攝手法。
對我們的啟示:22格分鏡的構圖提示詞裡,可以明確寫入三分法(rule of thirds)這類具體構圖術語,而不是只描述「好看的構圖」,讓生圖模型更容易對齊我們要的鏡頭語言。
각 Episode는 하나의 갈등입니다. Episode를 열고 Generate Shots를 클릭하면 ArcLoop가 Episode를 shot card로 나눠줍니다.
每一集(Episode)就是一個衝突。打開該集、點擊「Generate Shots」後,ArcLoop 會自動把該集拆成一張張鏡頭卡(shot card)。
對我們的啟示:我們可以把22格分鏡先寫成一份『每格一個小衝突/情緒轉折』的敘事清單,再逐格轉成鏡頭卡(景別、動作、情緒),跟平台自動拆鏡的邏輯一致,方便之後交給生圖/生影片工具逐格執行。
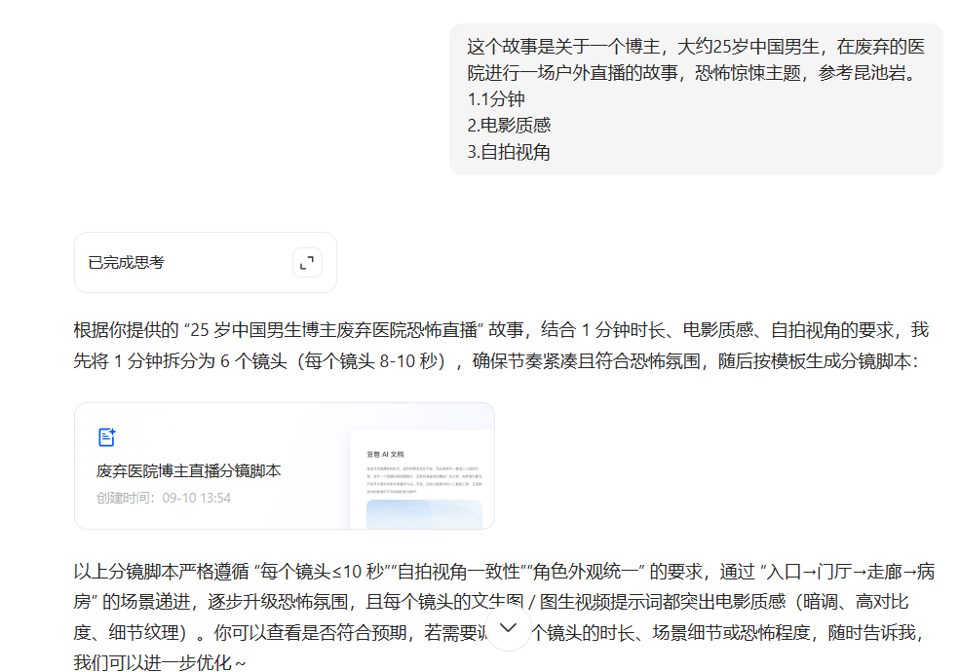
| 镜头 | 时长 | 场景描述 | 文生图提示词 | 图生视频提示词 | 备注 |
對我們的啟示:我們的分鏡表也該固定六欄:鏡次、時長(秒)、畫面描述、文生圖提示詞、圖生影片提示詞、備註,讓22格從一開始就是可以直接餵給生圖/生影片工具的結構化表格,不是散文式劇本。
固定人物外觀、角度、神情,建立角色一致性;同一角色・多角度。
角色一致性的解法分兩層:外觀交給圖像生成AI(三面圖/正面-側面-背面)固定形狀,設定(姓名、個性、背景故事)交給語言模型單獨管理。日本創作者的共識是「分開多次生成正面/側面/背面」容易讓臉與服裝逐漸走位,改成「單張圖裡一次生成三面圖」或先做出一張基準草圖(アタリ画像)再展開三面圖,一致性明顯提升。中國短劇工業化流程用 LoRA 把 10~30 張多角度多表情圖訓練成可重覆呼叫的角色資產,訓練資料要覆蓋需要的視角、表情與服裝變化,並記錄訓練與推論參數避免漂移。韓國技術文章補充,把特定人物的圖像資料當成參考圖輸入模型,是比純文字提示詞更能穩定生成一致結果的主要引導方式,人臉替換與PuLID是LoRA之外的另一種角色固定手段。
文智妍不訓練 LoRA,改用「基準圖+反推提示詞」兩層:REF-A 基準圖綁 md5,臉與髮的描述由模型反推後逐字保留,另加年齡校正段(反推會把人讀老)。每次生圖都把基準圖當參考圖餵進去。缺口:13 張多角度+表情參考圖還沒全齊。
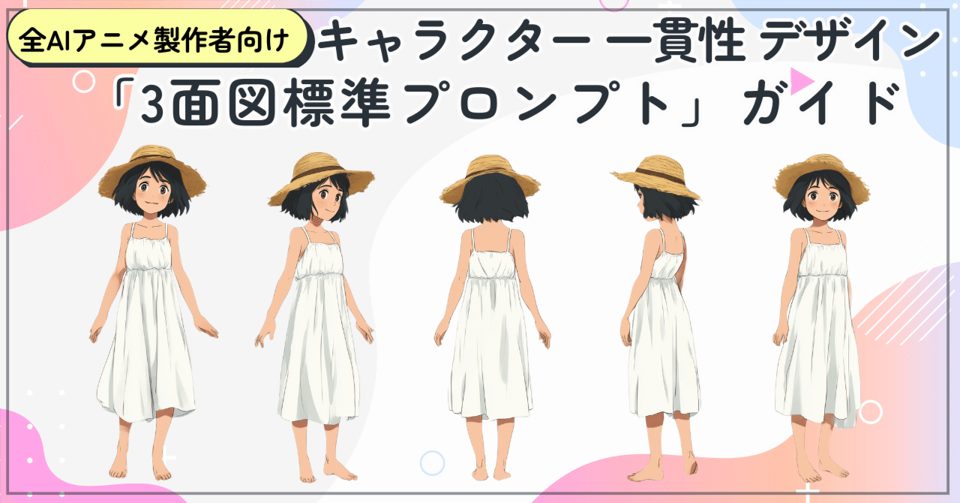
少しずつ顔や服装がズレてしまう
(用マルチショット方式分開生成正面/側面/背面時)臉部和服裝會一點一點跑掉
對我們的啟示:我們19歲銀灰鮑伯頭角色如果分開生成正面/側面/背面三張圖,容易像這篇警告的一樣臉型服裝慢慢跑掉;應該用同一張圖裡一次排出三個角度的三面圖當基準,22格分鏡再從這張基準圖延伸。
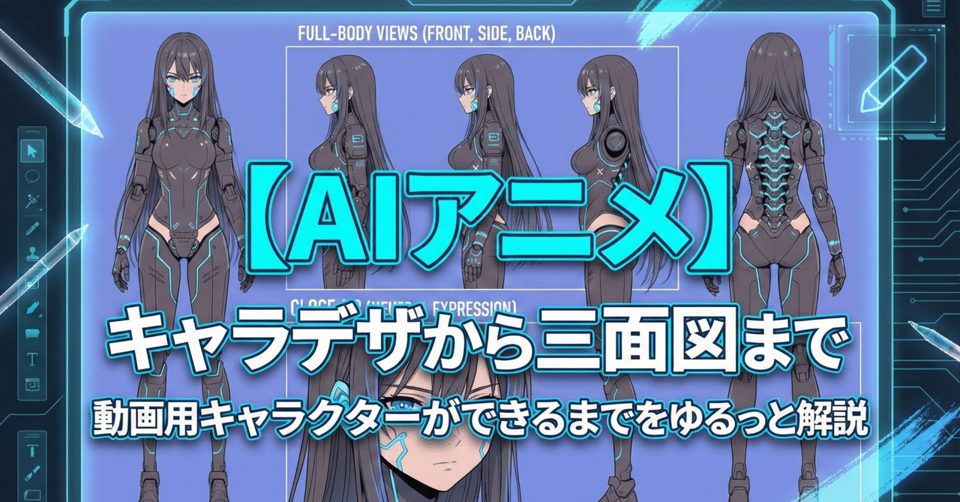
SeaArtで作った『アタリ画像』を読み込ませる。三面図生成用のプロンプトを入力する。生成ボタンを押す!これだけで、アタリ画像のキャラクター性を保ったまま、綺麗に展開された三面図が出来上がります。
把用SeaArt做出的『草稿參考圖(アタリ画像)』讀進去,輸入生成三面圖用的提示詞,按下生成鍵!只要這樣做,就能在保留草稿參考圖角色特徵的前提下,完成展開整齊的三面圖。
對我們的啟示:我們可以先用一張確定下來的角色正面草圖當基準,再用同一套流程展開側面/背面,而不是每個角度分別重新描述提示詞,降低跑版風險。
처음에 특정 인물의 이미지 데이터를 모델에 입력하거나 참조 이미지로 제공하면 이를 주요 가이드라인으로 활용해 더 일관성 있는 결과를 생성할 수 있다.
一開始把特定人物的影像資料輸入模型、或以參考圖提供給模型,把它當成主要引導依據,就能生成一致性更高的結果。
對我們的啟示:確認角色正面基準圖之後,之後每一格分鏡生圖都應該把這張基準圖當成必帶的參考圖輸入,而不是只靠文字提示詞描述『銀灰鮑伯頭 19歲』。
训练数据应保持身份正确,并覆盖需要的视角、表情和服装变化
對我們的啟示:如果之後要幫這個角色做LoRA,取材要涵蓋不只正臉,還要有多個視角、表情(開心/防衛/落寞)與服裝(毛衣大衣)變化,而不是只用同一張基準圖複製貼上。
建立室內外、白天夜晚常用場景模板;場景模板庫。
場景模板的核心問題是「同一個地方在不同鏡頭裡要看起來像同一個地方」。日本從業者的共識分兩層:傳統動畫制度先由『美術設定』決定線稿版的世界觀與場景方向,再由『美術監督』依時段/天氣上色成『美術ボード』;AI創作者則發現角度一變,光影、透視、小物擺放就會跟著跑掉,連續性靠參考圖也保不住,治本辦法要等3D場景生成技術成熟。韓國MV作者的實務解法是把場景「依地點分組」——同一段落集中用室內鏡頭、另一段落集中用戶外/海邊鏡頭,用敘事段落把場景切齊,而不是打散穿插。中國短劇工業化流程把這件事做成文件——『美術設定集』要固定一致性錨點、光照與狀態變體、尺度參照,搭配道具資產清單與敘事道具表,分鏡圖直接拿設定圖當參考圖出圖。
「星期一的房間」場景設定 v3=唯一真相源:格局、桌面物件由左到右、資產表 R01–R20、四個固定機位(正面 master、A、B、側面 C)。09-22 加上道具定裝圖(每件一張標準樣,出圖時一起餵)與連戲檢查表九項,出圖後由 AI 讀圖模型當場記逐格檢查,過了才給製作人看。
每件一張標準樣,從已定案的分鏡裁出。之後每格出圖把用到的定裝圖一起餵進去,AI 讀圖工兵審的時候也逐件比對。
①と②で、・人物が同じである だけでなく ・背景も同じである ことが視聴者に伝わらないと、1つの物語として破綻してしまいます。=一貫性の重要性
①和②(近景和遠景)兩個鏡頭裡,不只『人物是同一個人』,還要讓觀眾感受到『背景是同一個地方』,否則整個故事就會當成一貫的敘事崩壞掉。=一致性的重要性
對我們的啟示:我們的漢江河邊/房間兩個主場景,要先各自定下一組固定的地標元素(河邊的哪座橋、房間裡固定的家具位置),近景與遠景鏡頭都要看得到同一組地標,而不是每格各自生成背景。
カメラのアングルが大きく変わると、光の当たり方やパース、細かなオブジェクトの配置に矛盾が生じ、結果として『同じ場所』であるという連続性が失われてしまうのです。
只要攝影機角度變化夠大,光線角度、透視、細節物件的擺放就會出現矛盾,結果就是『同一個地方』這件事的連續性被破壞掉。
對我們的啟示:22格裡如果同一場景要換好幾個機位,寧可少換角度、固定幾個常用機位反覆用,也不要每格都換全新視角,降低背景對不起來的風險。
바다, 시내, 실외 등 특정 장소가 여러 번 등장한다면 장소를 중심으로 영상을 묶는 것도 좋습니다.
如果海邊、市區、戶外這類特定場景會重複出現好幾次,用地點為中心把片段分組整理也是不錯的做法。
對我們的啟示:我們可以把22格按『河邊(戶外)』與『房間(室內)』兩組場景分別集中排列在敘事段落裡(例如前段房間獨白、中段河邊回憶),而不是室內室外交錯亂跳。
给 AI 短剧出美术设定集(场景 + 叙事道具):一致性锚点、光照与状态变体、尺度参照、无人无手白底提示词。
對我們的啟示:場景模板不該只是一張氛圍圖,要附帶『一致性錨點』(如固定機位參考角度)與『光照/狀態變體』(白天/夜晚、有無人物版本),之後每格生圖才能對齊同一份場景設定,不是憑印象重畫。
建立每個鏡頭最重要的靜態畫面,決定構圖、光影、服裝、表情。
關鍵幀生成的通則是「先靜態、後動態」:用高品質生圖模型先把構圖、光影、表情定案成單張圖,再拿這張圖當『首幀參考』丟進影片生成模型讓畫面動起來,這比直接打字讓模型生成動態影片穩定得多。日本創作者的實務做法是先規劃出構圖草案,再把這張構圖圖當參考圖上傳到生圖工具做風格與細節收斂,構圖與最終畫風分兩階段各自迭代,而不是一次到位;構圖本身也被視為決定畫面印象與傳達訊息的關鍵變因,必須明確指定而非交給模型自由發揮。中國短劇工業化流程優先規劃3到5個承載情感重量的『錨點鏡頭』(揭示處特寫、變化全景、反應鏡頭),其餘中景全景鏡頭再填補進去,提示詞則結構化成景別、視角、人物動作、環境、風格、光影、畫質等要素。關鍵幀在AI影片生成術語裡的定義,就是標記動作起點、終點或重要姿態的那一幀,中間過程交由模型補完。
22 格分鏡本身就是關鍵幀:統一色鉛筆+粉彩畫風、春天四月初櫻花夜。局部問題(筆頭、牆上照片、書封面)用「裁切→只改那一塊→羽化貼回」修,框外像素不動;整格錯(機位、服裝)才整張重生。
構図だけをChatGPTで作るという方法。この画像をMidjourneyにアップロードし、リファレンス画像(参考画像)としてプロンプトと組み合わせて使うことで,完成度の高い作品に仕上げれます。
只用ChatGPT做出構圖的做法。把這張圖上傳到Midjourney,當成參考圖(reference image)跟提示詞組合使用,就能做出完成度很高的作品。
對我們的啟示:每一格關鍵幀可以先畫出構圖草案定案人物站位與視角,再把草案圖當參考圖丟進正式生圖流程做光影與畫風收斂,構圖和畫風分兩階段做,比一次到位更穩。
構図は画像の印象を左右する重要な要素です。適切な構図を指定することで、画像の見栄えや伝えたいメッセージが大きく変わります。
構圖是左右畫面印象的重要元素。指定適當的構圖,畫面的觀感與想傳達的訊息就會大不相同。
對我們的啟示:22格裡的關鍵鏡頭(如手寫日記特寫、河邊背影)要在提示詞裡明確寫出構圖術語(如特寫、過肩、三分法置中),不要只寫氛圍形容詞,才能穩定重現我們要的鏡頭語言。
키프레임은 애니메이션의 결정적 순간을 표시합니다. 즉 움직임의 시작, 끝, 또는 중요한 지점을 정의하는 포즈, 위치, 또는 시각 상태로, 그 사이의 모든 프레임이 채워져 부드러운 모션을 만들어 냅니다.
關鍵幀標記的是動畫裡的決定性瞬間,也就是定義動作起點、終點或重要節點的姿勢、位置或視覺狀態,兩個關鍵幀之間的所有畫格會被補完,做出流暢的動作。
對我們的啟示:我們22格的『關鍵幀生成』階段,產出的其實就是每個鏡頭的起點(或最重要)姿態圖;之後圖生影片模型負責補完中間過程,所以關鍵幀圖本身的構圖光影表情要一次到位,不能只當草稿看待。
先规划锚点镜头:承载场景情感重量的三到五个关键帧(揭示处的特写、展示发生了什么变化的全景、反应镜头)。
對我們的啟示:22格裡不需要每一格都平均施力,應該先挑出3到5個承載情感重量的『錨點鏡頭』(例如手寫日記特寫、離別背影、俯拍全景)優先做到位,其餘中景/轉場鏡頭再填補,而不是齊頭式對待每一格。
本課為《黃果》十三步的「第 02 層 生成與一致性控制」。三層架構共用前言與三層總圖請見第 6 課頂端。
把關鍵幀或文字描述變成 3–8 秒短片;文字/圖像 → 影片。
業界主流做法是先產出高品質關鍵幀靜態圖(角色基準圖或分鏡構圖),再用 I2V(圖生影片)模型如 Kling AI、Wan 2.2、Runway 把單張圖轉成 5-10 秒短片,普遍認為圖生影片比純文字生影片(T2V)穩定、可控性更高。提示詞寫法上,業界共識是拆成「主體動作+鏡頭運動+環境變化+節奏」四要素,避免籠統描述,一次只給一個清楚的動作指令。韓國業者則強調把多個 AI 功能依目的串成固定順序的工作流程(而非單點工具堆疊),才是量產短片的關鍵。實務上會一次生成多個版本再挑選,而非追求單次生成到位。
一律圖生影片(關鍵幀當起始幀),不用文字生影片。22 格裡 9 格靠生成,其餘靜態圖推拉或局部循環。預算:影片生成服務 每天 3 支、W2+W3 共 42 支;影片生成服務 抵免額只投兩三個最重要的鏡頭。每格生 3 支挑 1。
「『Image and Prompt』の項目にベースとなる画像と、動画に与えるプロンプト(指示文)を入力」
在『Image and Prompt』欄位,輸入作為基底的圖片,以及要賦予影片的提示詞(指示文字)。
對我們的啟示:確認我們的流程順序正確:先定角色基準圖,再逐鏡輸入具體提示詞生成,而不是丟一句籠統描述就期待模型自己補完動作。
Pairing one camera instruction with one subject action keeps the shot readable.
把一個鏡頭指令搭配一個主體動作,能讓這個鏡頭的意圖清楚易讀。
對我們的啟示:22 格分鏡的提示詞每格只給一個鏡頭運動+一個角色動作,避免同時塞多個指令讓 I2V 模型混淆而動作模糊。
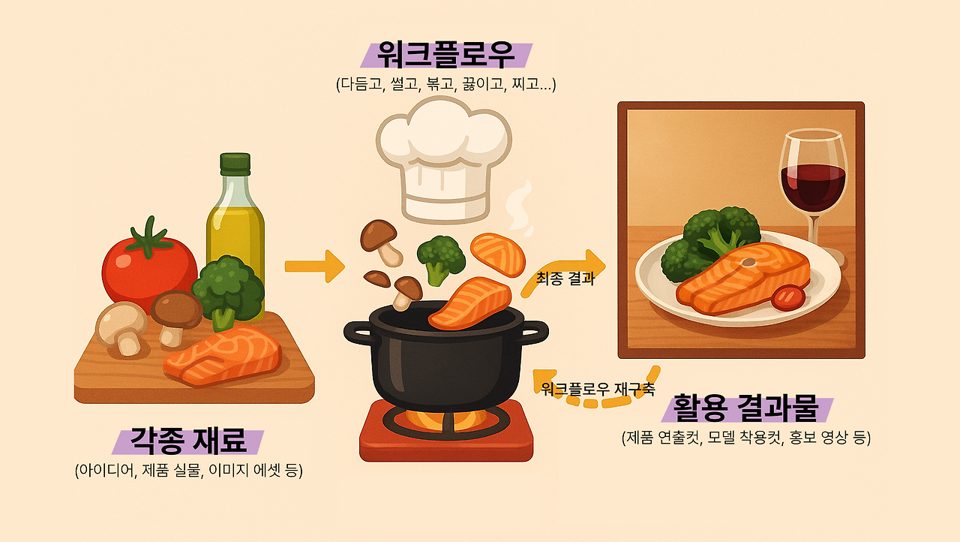
여러 AI 기능을 특정 순서대로 연결해 사용하는 방식을 말합니다.
指的是把多個 AI 功能依照特定順序串接起來使用的方式。
對我們的啟示:普通鏡頭生成不是單點丟給一個模型,而是「靜態關鍵幀 → I2V → 挑選 → 後製」固定順序的工作流程,22 格分鏡要照這個順序批次跑,不要每格臨時決定工具。
對嘴同步、微表情調整、說話穩定性;語音 → 對嘴影片。
業界共識是對嘴(S2V/Lip-sync)一定要餵「純人聲軌(vocal stem)」而不是混音,因為背景配樂會讓模型的聲音分析失準、導致嘴型對不上;有創作者實測整首歌全程對嘴後發現正確度與畫面動態感是取捨關係,太追求精準對嘴會犧牲鏡頭的動態表現。技術上 Wan 2.2 S2V 這類模型是用 Wav2Vec2 之類的語音編碼器把聲音特徵轉成可供模型追隨的訊號,畫面長度依音檔長度自動延伸。實務拍法建議用中近景到特寫捕捉嘴型,避免快速鏡頭運動、過大臉部角度轉動與重陰影,且不必每個鏡頭都對嘴——MV 通常混合演出鏡頭與敘事氛圍鏡頭。
MV 只有 #17 一格唱歌對嘴(嘴角極小的笑、唱鉤子那句)。韓文歌沒人能靠耳朵驗,驗收靠 ASR 聽回來逐句比對。
バッキングがあるとAIが正確に声を分析できませんからね。MVでリップシンク動画作る際には、ボーカルステムを使いましょう!
有伴奏的話 AI 就沒辦法正確分析人聲。在 MV 裡做對嘴動畫時,請務必使用人聲單軌(vocal stem)!
對我們的啟示:YuE2 出來的是混音,我們在對嘴前必須先做一步人聲分離,只餵乾淨的人聲軌給對嘴模型,否則嘴型會對不準。
Since ComfyUI core doesn't include voice separation nodes, we recommend using external tools to separate vocals from background music before processing.
由於 ComfyUI 核心本身沒有人聲分離節點,建議在處理前先用外部工具把人聲從背景音樂中分離出來。
對我們的啟示:跟日文出處互相印證:人聲分離不是選配步驟,是對嘴管線裡的必經工序,技術文件與實戰心得兩邊都獨立指向同一個結論。
모든 촬영 장면에 입모양 동기화를 하지 마세요. 뮤직비디오는 보통 퍼포먼스 장면과 줄거리 및 분위기를 결합합니다.
不要每個鏡頭都做口型同步。音樂錄影帶通常是把演出鏡頭跟劇情、氛圍鏡頭混合在一起。
對我們的啟示:文智妍的人設沉靜、防衛心重、動作幅度小,整首都對嘴風險最高;照這篇建議,22 格裡只挑兩三個特寫做對嘴,其餘用空景、手部、背影等氛圍鏡頭撐節奏。
(原圖此步為成人內容專用模型,與本專案無關,這裡改成「高難度鏡頭」。)
手部與臉部特寫是 AI 生成影片最常出包的部位,業界做法是把這類鏡頭獨立出來用「專用 LoRA/局部重繪(inpainting)/ControlNet 姿態導引(如 DWPose)」逐一補救,而不是靠同一套泛用流程硬生生跑過。日本創作者實測發現各家修手 LoRA 效果與副作用不一,需要準備好幾種輪替使用、依當下崩壞形式挑選;修正時常搭配局部重繪只重畫壞掉的區域,保留其餘畫面。角色一致性的另一組解法是固定 Seed 值、搭配同一張參考圖貫穿整個生成流程,並把同一角色的特寫鏡頭集中在同一批次生成,降低跨鏡頭臉型與髮型漂移。實務工作流建議是每個困難鏡頭只生 4-5 秒短片+一張參考圖,再進剪輯軟體把細微的不連貫用剪接遮住,而不是硬求一鏡到底完全一致。
手部特寫(#06 寫字、#19 日記、#20 闔本)與臉部特寫最容易崩:手指數、筆的握法、臉跑掉。做法是關鍵幀先修到對、影片生成只給小動作,生壞的格改成靜態推拉,不加預算。
LoRAごとに効き方もクセも違ってて、『相性ゲー感』は毎度のこと。何種類かあれば『今回はこっちで』って切り替えられる。この時点で選べる側になれるのがデカいです
每個 LoRA 生效的方式和特性都不一樣,每次都有種『合不合拍全看緣分』的感覺。手上有幾種可以選的話,就能『這次用這個』隨時切換,能站在『可以挑選』的那一邊是很重要的事。
對我們的啟示:手部特寫別指望一個 LoRA 打天下,先備好 2-3 種修手工具(LoRA/局部重繪),依當下崩壞的形式(多指、糊掉、姿勢怪)現場換著用。
Generate shorter 4-5 second clips with a reference image for each individual "shot," then stitch them together in post-production editing software to hide minor drifts between sequences.
針對每一個「鏡頭」各自搭配一張參考圖,生成 4-5 秒的短片段,再拿到後製剪輯軟體裡把段落之間的細微不連貫用剪接手法掩蓋掉。
對我們的啟示:臉部特寫鏡頭別追求靠模型一次到位完全一致,把它當成獨立鏡頭配一張定妝參考圖生成,剩下的落差交給剪輯的切點去藏。
관련 생성 전체에서 동일한 Seed 값을 사용하면 AI가 더 나은 특징 일관성을 유지합니다. 최고 크리에이터가 사용하는 획기적인 접근 방식은 Midjourney에서 일관된 캐릭터 이미지 생성 → 해당 이미지를 비디오 생성의 기본으로 사용 → 워크플로 전체에 일관된 Seed 값 적용
在相關的整組生成中使用同一個 Seed 值,能讓 AI 更好地維持角色特徵的一致性。頂尖創作者的做法是:先在圖像模型裡生出一致的角色圖 → 把這張圖當作影片生成的基底 → 整個工作流程沿用同一個 Seed 值。
對我們的啟示:高難度鏡頭(臉部特寫、手部特寫)生成時固定同一個 Seed 值+同一張角色基準圖,比每鏡重新隨機生成更容易保住臉型與髮色的一致性。
導入真人動作參考、骨架、姿勢,提升真實度與動態品質。
動作參考(Motion Transfer/Performance Capture)的核心機制是先用姿態推定 AI 從真人參考影片逐格抽出骨架與姿勢序列,再把這串姿勢當作引導訊號,套到另一個角色(由外觀參考圖或文字描述定義)身上生成新畫面,藉此把真人演出的細膩表情、時機、節奏帶進 AI 角色動畫,同時角色的外觀可以跟演出者完全不同。Runway Act-One 這類官方作法強調完全不需要額外的動作捕捉設備,單機拍攝演員表演即可驅動,重點在保留參考影片裡的情緒與細節,而非只是複製動作骨架。應用在舞蹈/MV 類生成時,業界建議畫面裡以單一主要表演者為主、全身輪廓清楚可讀,並且要先確認動作在鏡頭開始的最初一兩秒內就可以被看懂,且鏡頭切點要對準音樂的副歌、重拍或鉤子段落。
W1 計畫裡的「動作可行性篩選」:至少 3 個動作各生 1 支,分做得出來/勉強/做不出來三級,做不出來的動作從分鏡拿掉,不硬生。
AIは参照映像を解析し、動く被写体のスケルトンとポーズの系列をフレームごとに抽出します。次に、それらのポーズをガイドとして用い、別のキャラクター(外観の参照や記述で定義される)が同じ動きの系列を演じる新しい映像を生成します。
AI 會解析參考影片,逐格抽出畫面中主體的骨架與姿勢序列。接著把這些姿勢當作引導,讓另一個角色(由外觀參考圖或文字描述定義)演出同一組動作序列,生成新的影片。
對我們的啟示:如果角色的動態(走路、轉身、揮手)用純文字提示生不出想要的節奏感,可以先找一段真人參考影片抽骨架,再套到 19 歲韓國女生角色身上,動作會更自然。
Our approach uses a completely different pipeline, driven directly and only by a performance of an actor and requiring no extra equipment. The key challenge with traditional approaches lies in preserving emotion and nuance from the reference footage into the digital character.
我們的做法用的是完全不同的流程,只靠一段演員的表演直接驅動,不需要額外的動作捕捉設備。傳統做法的關鍵難題在於:如何把參考影片裡的情緒與細節保留到數位角色身上。
對我們的啟示:不必添購動捕設備,用手機拍一段自己或找人演出的表情與肢體動作當參考,就能把細膩的情緒節奏帶進角色的對嘴/抒情鏡頭,比純文字提示更容易演出「防衛心重但情緒在流動」的感覺。
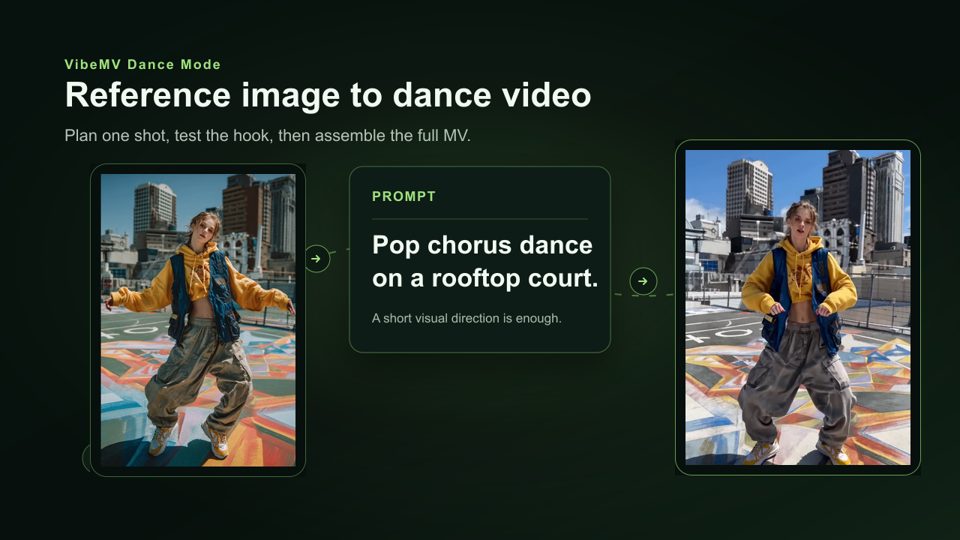
한 명의 주요 퍼포머 또는 캐릭터, 가능하면 몸 형태와 전신 맥락이 보임, 읽기 쉬운 의상과 실루엣… 첫 2초 안에 움직임이 읽히나요? 샷이 코러스, 드롭, 훅에 맞나요?
畫面裡要有一位主要表演者/角色,盡量看得到身形與全身脈絡,服裝與輪廓要清楚易讀……動作在最初兩秒內看得懂嗎?這個鏡頭有沒有對準副歌、重拍或鉤子段落?
對我們的啟示:22 格分鏡裡凡是用到動作參考的鏡頭,構圖要讓角色全身或至少上半身輪廓清楚可讀,並且對齊 YuE2 生成那首歌的副歌/重拍時間碼下刀,不要動作跟拍點各走各的。
本課為《黃果》十三步的「第 03 層 後期工業化包裝」。三層架構共用前言與三層總圖請見第 6 課頂端。
超解析度、去雜訊、補幀(24fps → 30fps)、色彩修整。
日韓中英四地的實務做法高度一致:素材先用 Topaz Video AI/RIFE/剪映 AI 補幀這類工具做超解析度放大與補幀(多半是 24fps→60fps 或更高,我們的需求是 24→30),再用 ffmpeg 的 minterpolate 濾鏡當免費替代方案;中國 AI 短劇圈已經把「补帧+超分」列為固定收尾步驟,並提醒補幀太強會出現殘影、超解析度太強會讓臉變形;色彩修整則靠統一的 LUT/色指定表把不同批次生成的畫面收斂成同一種質感。
生成片段解析度與幀率不一,統一放大到 1080p、補到同一條時間線的幀率,最後整片調一次色讓 22 格同一個夜色。
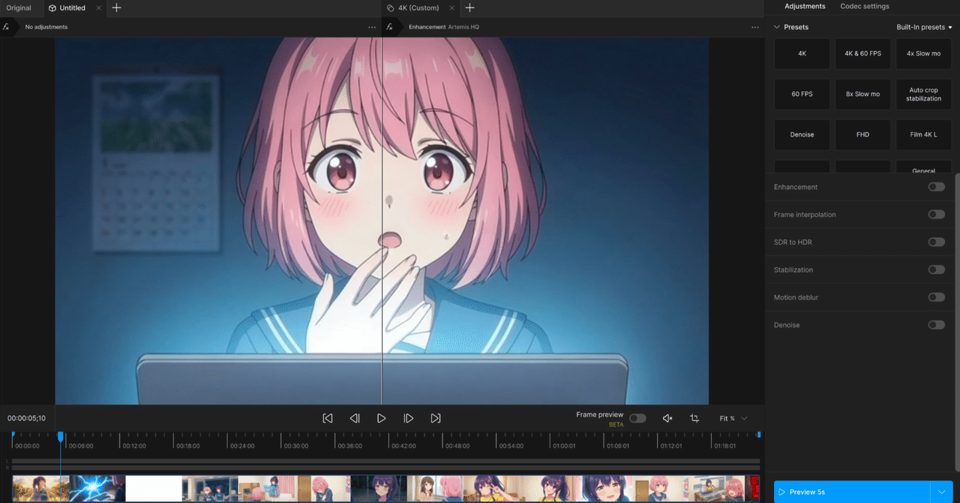
「Topaz Video」は、「Topaz Labs」が提供する、AI(人工知能)を使った高画質化・映像強化ソフトウェアです。AIを活用して動画の品質を大きく向上させることができるツールです。
「Topaz Video」是「Topaz Labs」提供的、使用 AI(人工智慧)的高畫質化.影像強化軟體,是能活用 AI 大幅提升影片品質的工具。
對我們的啟示:我們 22 格圖生影片素材解析度與雜訊量不一致,最後一道可以統一丟 Topaz Video AI 放大,把逐格畫質落差蓋掉。
CogVideoXはFPSが低いので、フレーム補間を利用して、FPSを向上させるために利用します。
CogVideoX 生成的影片 FPS 偏低,所以用影格補間(RIFE)來提升 FPS。
對我們的啟示:我們的圖生影片模型原生輸出多半也是低張數,用 RIFE/同類補間工具把 24fps 補到 30fps 的邏輯完全可以照抄。
本文介绍视频补帧及超分辨率技术的应用实践,对比了Dain-App、SVFI等补帧方法,并介绍了TopazVideoEnhanceAI在超分辨率方面的应用。
對我們的啟示:補幀與超解析度是兩件事、要分開跑:先補幀到 30fps 再統一放大解析度,順序顛倒容易讓補出來的中間格被放大演算法吃掉細節。
After having installed ffmpeg, I run the following command to create smooth videos at 60fps. The key part is the minterpolate filter: minterpolate=fps=60:mi_mode=mci:mc_mode=aobmc:me_mode=bidir:vsbmc=1
裝好 ffmpeg 之後,我跑下面這道指令把影片做成 60fps 的流暢版本,關鍵是 minterpolate 濾鏡:minterpolate=fps=60:mi_mode=mci:mc_mode=aobmc:me_mode=bidir:vsbmc=1。
對我們的啟示:不想另外裝 Topaz/RIFE 時,ffmpeg 內建的 minterpolate 濾鏡一行指令就能把 24fps 補到我們要的 30fps,免費且可腳本化批次跑 22 格。
TTS 配音、背景音樂、環境音、混音。
日韓的專業論述把音訊拆成對白/音樂/音效/環境音四層分開處理,各自給音量區間再合成,環境音的角色是「補足空間感的背景質地」而非主角;日本業界部落格特別把環境音(環境から聞こえる音)跟演出用效果音(SE)區分開來,這正對應我們只需要環境音、不需要對白軌的情況;韓國的說法把最終混音描述成把同期錄音、旁白、Foley、效果音、環境音、配樂全部匯流合成一軌,再統一調整各軌音量讓整體有生命感。對我們而言,重點是把 YuE2 生出的混音軌與後製加的環境音(風聲、街聲、房間迴響)分層對待,不要把兩者一起丟進同一條推子。
本機 本機歌曲生成模型 生韓文人聲歌(不花 API)。每首 85–95 秒,附歌詞跟隨率;韓文靠 ASR 驗。另補環境音(地鐵、河風、雨後街道)。
環境音とは「自分の周辺(環境)から聞こえてくる音」のことで、効果音(SE)は「舞台や映像などで『演出』の一環として付け加えられる音」のことです。
環境音是指「從自己周遭(環境)傳來的聲音」,效果音(SE)則是「在舞台或影像中作為『演出』的一環額外加上的聲音」。
對我們的啟示:我們這支 MV 要的是前者(環境音,如風聲、街道背景聲),不是戲劇化的效果音——選素材時要用這個區分來篩,別把音效庫裡誇張的 SE 誤當環境音用。
ダイアログ、音楽、効果音、環境音など、各音のレベルを適切にミックスすることが大切です。
對白、音樂、效果音、環境音等,把各軌的音量調到適當的比例混音,是最重要的一件事。
對我們的啟示:我們沒有對白軌,等於少一層要顧,但音樂(YuE2 混音)與環境音兩軌的比例還是要照這個「分軌各自定音量」的邏輯來抓,不要靠感覺一次调。
이제 만들어진 모든 소리인 현장녹음 대사, 후시녹음 대사, 폴리, 이팩트, 앰비언스, 그리고 영화음악을 모아 영상과 합쳐지는 파이널 믹싱과정을 거칩니다. 각각의 소리들의 레벨을 높이거나 낮추어 전체 영화 사운드의 크기를 조절하고 소리없는 밋밋한 영화 영상에 생명을 불어넣게 됩니다。
接下來會把已經做好的所有聲音——現場錄音對白、後製配音、Foley 擬音、音效、環境音(Ambience)、配樂——全部匯集,跟畫面合成進行最終混音。透過調高或調低各個聲音的音量來控制整部片的聲音大小,讓原本沒有聲音、平淡的影像有了生命。
對我們的啟示:把環境音跟音樂當成兩條各自要調的推子,而不是「加一點背景音」的附屬品,混音最後才會有空間感而不是糊成一團。
If the music's being used alongside dialogue, then you could lower the track's volume even more, to around -30dB and -35dB. This kind of balance will keep the music in the background while allowing the viewer to concentrate on what you're saying – if it's too high, the soundtrack will get distracting.
如果音樂要跟對白一起用,可以把音樂音量再壓低到約 -30dB 到 -35dB。這樣的平衡能讓音樂留在背景,觀眾才能專注在你想傳達的內容上——音樂太大聲會變成干擾。
對我們的啟示:我們沒有對白,但同樣的邏輯適用在「歌聲 vs 環境音」:環境音要壓到明顯低於人聲軌的位置,只做空間感的底層,不能搶過韓文歌詞的清晰度。
字幕、對話框、片頭片尾、介面元素、品牌包裝。
日本歌詞動画(Lyric Video)圈子的共識是「文字要服務音樂而非搶戲」:有創作者整理案例指出不少國外研究認為 MV 加字幕會分散對畫面與音樂的注意力,所以要先想清楚加字幕的目的;實務上字型與配色要配合歌曲氛圍、一次只顯示一兩行(像卡拉OK畫面),別把整段歌詞一次塞進畫面。片頭片尾的設計則可以是獨立於正片之外的「作品」,日本動畫界的 OP/ED Title 設計史上有把片尾當成另一種表現形式在做的先例。韓文(Adobe 韓文版教學)也給出同樣的「字要大、一兩行、字體配主題」原則。中國 AI 短劇圈把字幕定位成「流量密碼」:直式短劇字幕字級要大、顏色要醒目,是硬性規則不是美學選擇。綜合起來,我們的韓文歌詞+中文字幕雙語字幕要分主次、控制同屏行數,並讓字體風格跟畫面版畫雙色調性一致。
韓文歌詞+中文字幕雙行,時間軸用 ASR 帶韓文語言參數對(現有字幕對位工具只吃英文歌)。片頭片尾放星期一少女系列識別。
海外の研究ではMVに文字を入れると映像の印象が薄れるという理由で映像や音楽に集中してほしい場合はMVに歌詞を入れることを避けるクリエイターも多いものです。
根據海外的一些研究,MV 加上文字會讓影像的印象變淡,所以如果希望觀眾專注在畫面與音樂上,不少創作者會刻意避免在 MV 裡放歌詞。
對我們的啟示:我們是刻意要放中文字幕輔助理解韓文歌詞,等於主動接受這個「分散注意力」的取捨——所以字幕的存在感要收斂(小、簡、不搶主視覺),別讓它變成另一個主角。
バスが画期的だったのは、単にグラフィックデザインの発想をクレジットタイトルに導入した点のみに限らない。それよりもむしろ、クレジットタイトルを、単なる『名簿』の役割から解放し、本編とはすっかり異なる表現様式のもとに『作品』として成り立たせた点に注目すべきであろう。
Saul Bass 的劃時代之處,不只在於把平面設計的構想帶進片頭字幕。更值得注意的是,他把片頭字幕從單純的『名單』角色解放出來,讓它以一種和正片完全不同的表現形式,成立為獨立的『作品』。
對我們的啟示:我們的片頭片尾(22 格框架裡收尾的那幾格)也可以脫離敘事本身,用版畫雙色的獨立視覺語言處理,不必只是打字幕卡而已。
단어가 화면에 1~2초만 표시되므로 글자는 크고 읽기 쉬워야 합니다. 그리고 글꼴과 색상은 주제에 어울려야 합니다. 한 번에 전체 소절을 프레임에 넣어도 되지만 이렇게 하면 영상에 매력이 없습니다. 마치 노래방 화면처럼 노랫말이 한꺼번에 표시되지 않는 것이 좋습니다. 한두 줄 정도가 가장 자연스럽습니다.
字只會在畫面上停留一到兩秒,所以字要大、要好讀,字型與顏色也要配合主題。雖然可以一次把整句歌詞放進畫面,但這樣影片會沒有魅力;最好不要像卡拉OK畫面那樣把歌詞整段一次顯示,一到兩行是最自然的。
對我們的啟示:中文字幕的分行策略可以直接照抄這條:每次只上一到兩行韓文歌詞+對應中文翻譯,字級放大,不要把整段歌詞一次貼上畫面。
字幕是流量密码:竖屏短剧必须有字幕,字号要大,颜色要醒目
對我們的啟示:雖然我們不是直式短劇、也不是為了平台流量演算法,但「字大、色醒目」這個硬指標同樣適用——手機小螢幕上看 MV,字幕太秀氣等於沒放。
In the tutorial below from Jesse Rosten, he covers all of the basics you need to make a kinetic text music video. To create text like this you'll need a basic understanding of keyframing in After Effects.
下面 Jesse Rosten 的教學把製作動態文字(Kinetic Typography)MV 需要的基本功都講到了。要做出這種文字效果,你得先懂 After Effects 裡關鍵影格(keyframing)的基本概念。
對我們的啟示:如果之後想讓中文字幕不只是靜態疊字、而是跟著節拍有輕微動態,這套「先懂關鍵影格」的入門路徑是最低成本的下一步。
把片段剪成完整成片,輸出成品並發布。
日本的剪輯教學把「配合 BPM 卡點」講得很具體:先抓歌曲 BPM,在鼓點(Kick/Snare)落下的瞬間切鏡,並且刻意設計「切的拍」與「不切的拍」(例如四拍子只在第 1、3 拍切),全部拍拍都切反而顯得廉價,卡點誤差只要 0.1〜0.2 秒就會讓人覺得「怪怪的」。韓國一篇拆解 TWICE MV 剪輯設計的部落格文章指出,MV 必須從頭到尾抓住觀眾注意力,因此在很短時間內高密度壓縮大量分鏡與運鏡設計。中國剪映的卡點教學則把整套流程工具化:匯入音樂→自動踩點(踩節拍或踩旋律)→依標記點對齊素材,並建議新手用 BPM 120–150、節奏清楚的歌起步。英文教學補充了另一種做法:一邊聽歌一邊按快捷鍵打點(不只打在正拍,也打在切分拍與十六分音符上),再用素材自動分配到這些點位。
照歌的段落與拍點剪,平均每格約 4 秒。10/19 週一發布到 YouTube。
人間の脳は、外部からの刺激(音、映像、触覚など)を常に予測しながら処理しています。これを「予測的符号化(Predictive Coding)」と呼びます。
人腦在處理外部刺激(聲音、影像、觸覺等)時,會持續進行預測式的處理,這被稱為「預測編碼(Predictive Coding)」。
對我們的啟示:卡點會讓人覺得「舒服」不是美學問題而是腦科學問題:切點符合大腦對節奏的預測,落差 0.1〜0.2 秒就會被感知為不對勁,這解釋了為什麼我們對拍時要用 ASR/音軌波形精準對齊,不能靠肉眼抓大概。
뮤직비디오는 노래 시작부터 끝까지 시청자를 집중시켜야 한다. 이러한 특징 때문에 아주 빠르게, 동시에 수많은 컷과 샷 디자인을 압축해 배치한다.
音樂錄影帶必須從歌曲開始到結束都抓住觀眾的注意力。因為這個特性,會用非常快的速度,同時把大量的分鏡與運鏡設計壓縮排列在一起。
對我們的啟示:我們 90 秒、22 格的長度其實偏短促,等於每一格平均分到的時間更少——剪輯時要有意識地做「高密度壓縮」,不能每格都給太長的呼吸時間,否則整支 MV 會顯得拖。
大家好,我是胡椒粉!今天我们继续学习如何用剪映制作节奏感十足的卡点视频,帮助你的视频更具冲击力和吸引力!
對我們的啟示:剪映的自動踩點(踩節拍/踩旋律二選一)可以當我們對拍的第一輪快篩,抓出候選卡點後再用日文那篇提到的「不是每拍都切」原則手動篩掉一部分。
Press play and add markers (by pressing 'm' on the keyboard) to the beats, off-beats, and 16th notes of the song to your liking – while you hear the song.
播放音樂,一邊聽歌一邊按鍵盤的 'm' 鍵,在正拍、切分拍、十六分音符上依自己喜好加上標記點。
對我們的啟示:打點時不要只鎖死拍點,切分拍與十六分音符也可以放標記——韓文歌詞的重音位置未必落在正拍上,用這套方法可以讓卡點跟著歌詞的實際重音走,而不是硬套節拍器。
這一頁把第 1〜5 課用到的 16 個來源,以及第 6〜8 課十三步裡的每一篇引用,集中在一起。每張卡標語言、類型、發表者、日期、它提供了什麼、用在哪一課。縮圖是文章的公開預覽圖,點了回原文。引用文字的版權屬原作者;示意圖為本站依來源重繪。
類型圖示:維基百科/平台官方文件/業界部落格/新聞媒體/工具商手冊/公家機構/技術社群。
傳統影視的五大階段(Development / Pre-production / Production / Post-production / Distribution)以及各階段典型時程,是 §1 流程總覽表的骨架。
微短劇(duanju)的定義、單集長度(1〜3 分鐘)、製作團隊性質(非 UGC、職業劇組)、中國/海外(美/歐/日)產業現況、國家廣電總局監管沿革;支撐 §2.1、§2.3、§2.4。
海外微短劇代表平台 ReelShort 的商業模式(虛擬幣付費解鎖)、產製內容特性(快速反轉、低成本、未知演員)、規模數據;支撐 §2.4 商業模式與 §2.3 內容題材。
傳統攝影通告單的內容欄位(call time、場景、地址、聯絡、安全、特殊設備、餐飲);用於 §4.4 素材命名與 §4.3 前製流程的對照。
分鏡的歷史(Walt Disney 1930 年代起源)、定義(graphic organizer 預視畫面);用於 §4.3 分鏡卡的理論依據。
show bible / pitch bible 的定義、用途(銷售文件、編劇一致性參考)、WGA 規定;用於 §4.1 故事聖經的欄位設計依據。
YouTube Shorts 官方規格(長度上限、計數規則、營利政策);用於 §2.5 平台交付規格表。
60+ 免費分鏡模板(PDF / PSD / Word / PPT),業界常用的分鏡製作起點;用於 §4.3 分鏡工具建議。
劇本拆解(script breakdown)的標準流程、欄位分類(角色、場景、道具、特效、音效)、用於排程與預算;用於 §4.3 鏡頭清單欄位設計。
業界 pre-production 軟體的功能地圖(screenwriting、script sides、breakdowns、stripboards、shot lists、storyboards、contacts、calendars、task boards);用於 §1 流程總覽與 §4 各階段產物對照。
中國微短劇的敘事結構(1〜3 分鐘閉環、3 秒 hook、衝突設計、節奏範例);用於 §2.2 結構說明。
AI 短劇的具體工作流(劇本 → 角色資產庫 → 場景拆解 → 鏡頭清單 → 配音 → 剪輯 → 審核),對應到本專案 AI 管線的關卡設計;用於 §3 AI 管線對應與 §4 鏡頭卡範本。
台灣本土的文化內容產業資源平台,含「**前期開發支持計畫**」「**出版轉影視 Taiwan Beats**」「**TDAL 數位模型庫**」「**TCCF 創意內容大會**」等;可作為本專案未來申請補助、找資源的入口。
海外業界對 ReelShort 的定位描述,比較它與 Quibi 的差異,強調「**短、平、快 + 情緒綁架**」的內容屬性;用於 §2.2、§2.3 補充產業觀察。
海外短劇產業垂直媒體,報導 duanju 與歐美平台(Stardust TV、Studio Phocéen 等)的最新動態,包括 2025/2026 微劇競賽(Sundance + Studio Phocéen 合辦,獎金 5,000 USD + Sundance 課程)等;用於補充 §2.1 集數/§2.4 商業模式。
BBC Future 對全球微劇熱潮的專題(頁面 JS 渲染,純 HTML 抓取無文本,列為潛在來源待確認內容)。
我們22格分鏡也可以先按「導入(河邊獨白)→本篇(回憶/情緒推進)→收尾(離別/釋然)」三段大結構分組,再往下拆每一格,而不是一格一格硬想。
22格分鏡的構圖提示詞裡,可以明確寫入三分法(rule of thirds)這類具體構圖術語,而不是只描述「好看的構圖」,讓生圖模型更容易對齊我們要的鏡頭語言。
我們可以把22格分鏡先寫成一份『每格一個小衝突/情緒轉折』的敘事清單,再逐格轉成鏡頭卡(景別、動作、情緒),跟平台自動拆鏡的邏輯一致,方便之後交給生圖/生影片工具逐格執行。
我們的分鏡表也該固定六欄:鏡次、時長(秒)、畫面描述、文生圖提示詞、圖生影片提示詞、備註,讓22格從一開始就是可以直接餵給生圖/生影片工具的結構化表格,不是散文式劇本。
我們19歲銀灰鮑伯頭角色如果分開生成正面/側面/背面三張圖,容易像這篇警告的一樣臉型服裝慢慢跑掉;應該用同一張圖裡一次排出三個角度的三面圖當基準,22格分鏡再從這張基準圖延伸。
我們可以先用一張確定下來的角色正面草圖當基準,再用同一套流程展開側面/背面,而不是每個角度分別重新描述提示詞,降低跑版風險。
確認角色正面基準圖之後,之後每一格分鏡生圖都應該把這張基準圖當成必帶的參考圖輸入,而不是只靠文字提示詞描述『銀灰鮑伯頭 19歲』。
如果之後要幫這個角色做LoRA,取材要涵蓋不只正臉,還要有多個視角、表情(開心/防衛/落寞)與服裝(毛衣大衣)變化,而不是只用同一張基準圖複製貼上。
我們的漢江河邊/房間兩個主場景,要先各自定下一組固定的地標元素(河邊的哪座橋、房間裡固定的家具位置),近景與遠景鏡頭都要看得到同一組地標,而不是每格各自生成背景。
22格裡如果同一場景要換好幾個機位,寧可少換角度、固定幾個常用機位反覆用,也不要每格都換全新視角,降低背景對不起來的風險。
我們可以把22格按『河邊(戶外)』與『房間(室內)』兩組場景分別集中排列在敘事段落裡(例如前段房間獨白、中段河邊回憶),而不是室內室外交錯亂跳。
場景模板不該只是一張氛圍圖,要附帶『一致性錨點』(如固定機位參考角度)與『光照/狀態變體』(白天/夜晚、有無人物版本),之後每格生圖才能對齊同一份場景設定,不是憑印象重畫。
每一格關鍵幀可以先畫出構圖草案定案人物站位與視角,再把草案圖當參考圖丟進正式生圖流程做光影與畫風收斂,構圖和畫風分兩階段做,比一次到位更穩。
22格裡的關鍵鏡頭(如手寫日記特寫、河邊背影)要在提示詞裡明確寫出構圖術語(如特寫、過肩、三分法置中),不要只寫氛圍形容詞,才能穩定重現我們要的鏡頭語言。
我們22格的『關鍵幀生成』階段,產出的其實就是每個鏡頭的起點(或最重要)姿態圖;之後圖生影片模型負責補完中間過程,所以關鍵幀圖本身的構圖光影表情要一次到位,不能只當草稿看待。
22格裡不需要每一格都平均施力,應該先挑出3到5個承載情感重量的『錨點鏡頭』(例如手寫日記特寫、離別背影、俯拍全景)優先做到位,其餘中景/轉場鏡頭再填補,而不是齊頭式對待每一格。
確認我們的流程順序正確:先定角色基準圖,再逐鏡輸入具體提示詞生成,而不是丟一句籠統描述就期待模型自己補完動作。
22 格分鏡的提示詞每格只給一個鏡頭運動+一個角色動作,避免同時塞多個指令讓 I2V 模型混淆而動作模糊。
普通鏡頭生成不是單點丟給一個模型,而是「靜態關鍵幀 → I2V → 挑選 → 後製」固定順序的工作流程,22 格分鏡要照這個順序批次跑,不要每格臨時決定工具。
YuE2 出來的是混音,我們在對嘴前必須先做一步人聲分離,只餵乾淨的人聲軌給對嘴模型,否則嘴型會對不準。
跟日文出處互相印證:人聲分離不是選配步驟,是對嘴管線裡的必經工序,技術文件與實戰心得兩邊都獨立指向同一個結論。
文智妍的人設沉靜、防衛心重、動作幅度小,整首都對嘴風險最高;照這篇建議,22 格裡只挑兩三個特寫做對嘴,其餘用空景、手部、背影等氛圍鏡頭撐節奏。
手部特寫別指望一個 LoRA 打天下,先備好 2-3 種修手工具(LoRA/局部重繪),依當下崩壞的形式(多指、糊掉、姿勢怪)現場換著用。
臉部特寫鏡頭別追求靠模型一次到位完全一致,把它當成獨立鏡頭配一張定妝參考圖生成,剩下的落差交給剪輯的切點去藏。
高難度鏡頭(臉部特寫、手部特寫)生成時固定同一個 Seed 值+同一張角色基準圖,比每鏡重新隨機生成更容易保住臉型與髮色的一致性。
如果角色的動態(走路、轉身、揮手)用純文字提示生不出想要的節奏感,可以先找一段真人參考影片抽骨架,再套到 19 歲韓國女生角色身上,動作會更自然。
不必添購動捕設備,用手機拍一段自己或找人演出的表情與肢體動作當參考,就能把細膩的情緒節奏帶進角色的對嘴/抒情鏡頭,比純文字提示更容易演出「防衛心重但情緒在流動」的感覺。
22 格分鏡裡凡是用到動作參考的鏡頭,構圖要讓角色全身或至少上半身輪廓清楚可讀,並且對齊 YuE2 生成那首歌的副歌/重拍時間碼下刀,不要動作跟拍點各走各的。
我們 22 格圖生影片素材解析度與雜訊量不一致,最後一道可以統一丟 Topaz Video AI 放大,把逐格畫質落差蓋掉。
我們的圖生影片模型原生輸出多半也是低張數,用 RIFE/同類補間工具把 24fps 補到 30fps 的邏輯完全可以照抄。
補幀與超解析度是兩件事、要分開跑:先補幀到 30fps 再統一放大解析度,順序顛倒容易讓補出來的中間格被放大演算法吃掉細節。
不想另外裝 Topaz/RIFE 時,ffmpeg 內建的 minterpolate 濾鏡一行指令就能把 24fps 補到我們要的 30fps,免費且可腳本化批次跑 22 格。
我們這支 MV 要的是前者(環境音,如風聲、街道背景聲),不是戲劇化的效果音——選素材時要用這個區分來篩,別把音效庫裡誇張的 SE 誤當環境音用。
我們沒有對白軌,等於少一層要顧,但音樂(YuE2 混音)與環境音兩軌的比例還是要照這個「分軌各自定音量」的邏輯來抓,不要靠感覺一次调。
把環境音跟音樂當成兩條各自要調的推子,而不是「加一點背景音」的附屬品,混音最後才會有空間感而不是糊成一團。
我們沒有對白,但同樣的邏輯適用在「歌聲 vs 環境音」:環境音要壓到明顯低於人聲軌的位置,只做空間感的底層,不能搶過韓文歌詞的清晰度。
我們是刻意要放中文字幕輔助理解韓文歌詞,等於主動接受這個「分散注意力」的取捨——所以字幕的存在感要收斂(小、簡、不搶主視覺),別讓它變成另一個主角。
我們的片頭片尾(22 格框架裡收尾的那幾格)也可以脫離敘事本身,用版畫雙色的獨立視覺語言處理,不必只是打字幕卡而已。
雖然我們不是直式短劇、也不是為了平台流量演算法,但「字大、色醒目」這個硬指標同樣適用——手機小螢幕上看 MV,字幕太秀氣等於沒放。
如果之後想讓中文字幕不只是靜態疊字、而是跟著節拍有輕微動態,這套「先懂關鍵影格」的入門路徑是最低成本的下一步。
卡點會讓人覺得「舒服」不是美學問題而是腦科學問題:切點符合大腦對節奏的預測,落差 0.1〜0.2 秒就會被感知為不對勁,這解釋了為什麼我們對拍時要用 ASR/音軌波形精準對齊,不能靠肉眼抓大概。
我們 90 秒、22 格的長度其實偏短促,等於每一格平均分到的時間更少——剪輯時要有意識地做「高密度壓縮」,不能每格都給太長的呼吸時間,否則整支 MV 會顯得拖。
剪映的自動踩點(踩節拍/踩旋律二選一)可以當我們對拍的第一輪快篩,抓出候選卡點後再用日文那篇提到的「不是每拍都切」原則手動篩掉一部分。
打點時不要只鎖死拍點,切分拍與十六分音符也可以放標記——韓文歌詞的重音位置未必落在正拍上,用這套方法可以讓卡點跟著歌詞的實際重音走,而不是硬套節拍器。
| 位置 | 待查內容 | 建議查詢管道 |
|---|---|---|
| 第 2 課 2.3 | 台灣受眾對微短劇爽文題材的接受度 | 文策院產業調查、串流平台台灣觀影報告 |
| 第 2 課 2.5 | IG Reels、TikTok 2025/2026 最新長度政策 | Meta Business Help、TikTok Newsroom |
| 第 2 課 2.5 | ReelShort/DramaBox 官方創作者交付規格 | 平台創作者頁(需註冊) |
| 第 4 課 4.5 | 短劇平台音訊規格(LUFS、取樣率) | 各平台創作者中心 |
| 第 5 課 | 短劇付費卡點通常在第幾集(業界共識) | 平台公開分析資料;目前只找到訪談與零星文章 |
| 第 3 課 | 本專案每支 MV 平均花多少算力與時間 | 第一支 MV 做完後自填 |
| 詞 | 意思 |
|---|---|
| 故事聖經(show bible) | 給編劇與所有人看的設定總集:角色、世界觀、規則、風格 |
| 分鏡(storyboard、絵コンテ) | 把每個鏡頭畫成一格,標景別、動作、對白,用來預視畫面 |
| 鏡頭清單(shot list) | 每個鏡頭一列的表格:編號、秒數、類型、描述、角色、場景 |
| 通告單(call sheet) | 拍攝日前一天發的當日工作單;AI 管線裡對應「今晚生哪幾格」 |
| 畫面鎖定(picture lock) | 剪接定稿、不再動畫面,之後只做調色、聲音、字幕 |
| 粗剪/精剪(rough cut/fine cut) | 先用未完成素材剪出節奏,再換上定稿素材精修 |
| I2V/T2V/S2V | 圖生影片/文生影片/聲音驅動影片(對嘴) |
| LoRA | 用少量圖片微調模型,讓它記住一個角色或風格 |
| 靜幀稽核 | 分鏡圖過審才准生影片的關卡 |
| 鉤子(hook)/卡點 | 讓觀眾停下來的懸念;付費卡點是第一道付費牆所在的那一集 |
| freemium | 前幾集免費、之後付費解鎖的商業模式 |
| 完播率 | 看完整支的人數比例,短影音平台推薦演算法最看重的指標之一 |
引用文章與截圖版權屬原作者,本站只節錄必要句子並連回原文;示意圖依來源重繪;《星期少女》角色、設定與圖片為本專案原創。
