Gemini 4 Argon:Google 重返前沿,台灣人還得再等
9 月 30 日,Google 發表新一代旗艦模型 Gemini 4 Argon。官方公布的基準多半領先 GPT-6 Astra 與 Claude Opus 5.5,但目前只交給經審核的網路資安防守方,一般使用者、開發者和台灣的 Google AI 訂戶都還用不到。獨立評測說它追平了 Astra,Bloomberg 則報導部分 Google 員工對實際表現存疑。
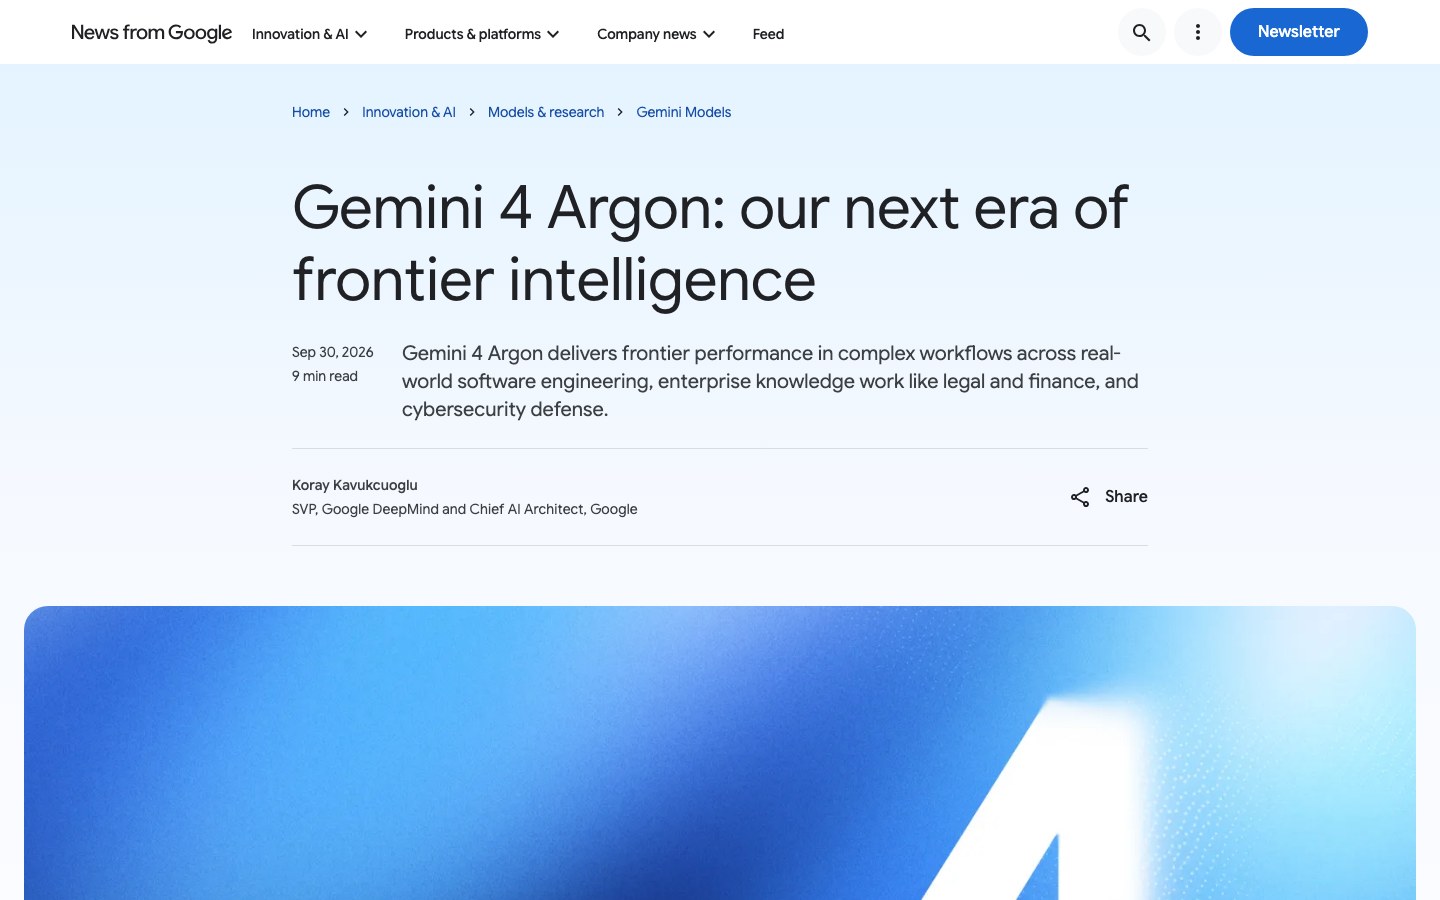
台灣時間 10 月 1 日凌晨 4 點,Google 在官方部落格公布 Gemini 4 Argon。卡烏克庫魯在文中稱它是「前沿智慧的下一個時代」。這是 Google 自去年 11 月的 Gemini 3 以來第一個新世代旗艦,也是它七個多月來第一個 Flash 級以上的模型。
但這場「發表」和一般人想的不一樣。Argon 目前只透過 Fairwind 計畫,交給經 Google 審核的網路資安防守方。官方說會在把防護做好之後,盡快開放給開發者、企業和一般使用者,先從付費的 API 客戶與 Google AI Ultra 訂閱者開始,沒有給日期。
這篇整理四件事:國內外媒體怎麼報、台灣現在哪個方案用得到、別人和我們自己的試用結果、外媒的評價。先講結論:台灣一般使用者目前用不到,我們手上的 Gemini 管道也叫不到;文中大部分基準數字是 Google 自行公布,沒有第三方驗證的,都會標明。
01重點一次看:發表了什麼,誰能用到
先把目前查得到的事實排成一張表。「Google 自行公布」代表來源只有 Google 一家,「第三方」代表有獨立機構或媒體另外量過。
| 項目 | 內容 | 來源與性質 |
|---|---|---|
| 發表 | 2026 年 9 月 30 日(美西),台灣時間 10 月 1 日凌晨 4 點;官方部落格由卡烏克庫魯署名 | Google 官方部落格 |
| 定位 | Gemini 4 世代的第一個模型,主打長時間的軟體工程、法律與財務等知識工作、網路資安防守 | Google 自行公布 |
| 現在誰能用 | 只有 Fairwind 計畫裡的受信任網路防守方。官方頁面寫目前與全球 650 多個夥伴合作。沒有公開 API,也沒有 Gemini App | Google 部落格、DeepMind Fairwind 頁面 |
| 之後 | Google 說「盡快」開放,先從付費 API 客戶與 Google AI Ultra 訂閱者開始,沒有日期 | Google 部落格 |
| 價格 | 導入價每百萬 token 輸入 2 美元、輸出 10 美元,快取輸入便宜 95%;導入期結束後 4 美元和 20 美元。導入期多久沒說 | Google 部落格與註腳 |
| 規格 | 單次輸出上限 100 萬 token(前代 6.4 萬);輸入脈絡 100 萬 token;能讀文字、圖片、影片、語音,只輸出文字 | Google 部落格、Artificial Analysis |
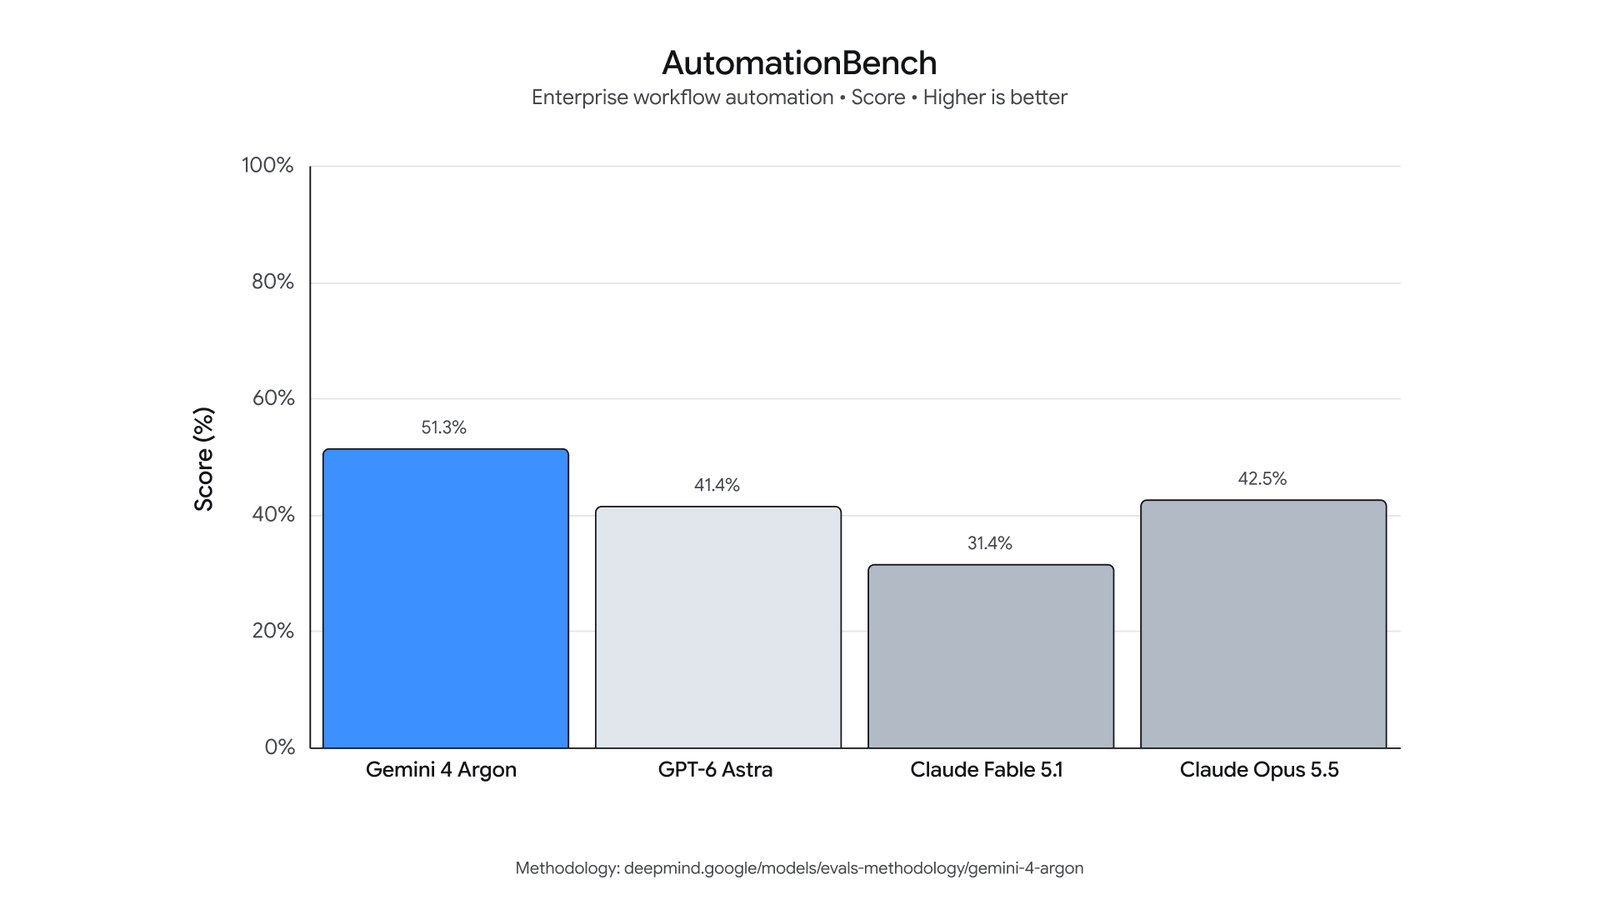
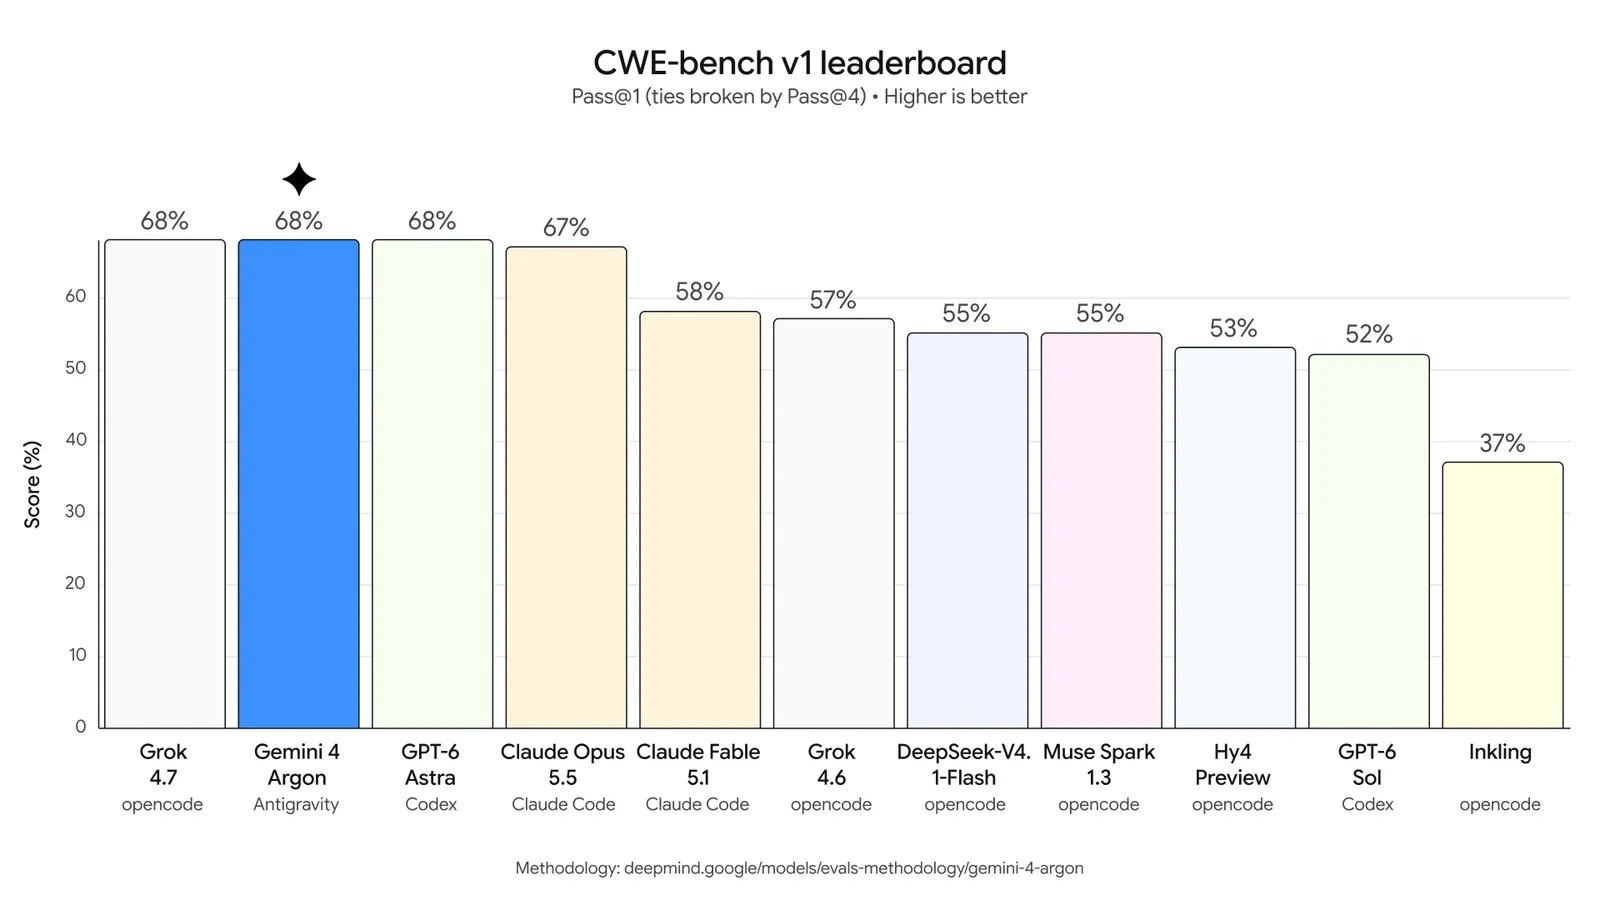
| 官方基準 | DeepSWE v1.1 得 77.9%,官方稱是新高;CWE-bench v1 得 68%,與 GPT-6 Astra 並列第一;官方對照表 19 列裡,13 列 Argon 單獨最高、1 列並列、5 列落後 | Google 自行公布(列數是我們照官方表自己數的) |
| 獨立評測 | Artificial Analysis 智慧指數 53 分,與 GPT-6 Astra 並列;Claude Opus 5.5 是 58 分 | 第三方(Opus 分數轉引自 The Decoder) |
| 爭議 | Bloomberg 引述知情人士:部分 Google 員工認為實際使用的表現不如基準。Google 說這樣講不正確 | Bloomberg、Axios 報導 |
三種數字分開看:Google 自行公布的基準,沒有第三方驗證;Artificial Analysis 與 Arena 這類獨立機構自己測出來的分數;只有一家媒體提到、查不到第二個來源的說法,文中會直接寫「單一來源」。
02國內外怎麼報:官方、國際媒體與台灣媒體
一手來源是 Google 官方部落格,以及 DeepMind 的 Fairwind 計畫頁面。多家媒體在台灣時間 10 月 1 日凌晨 4 點前後接連發稿,Bloomberg 的報導甚至比官方部落格早了約 7 分鐘:它的發稿時間是台灣時間 3 點 52 分,官方文章是 4 點整。
| 媒體 | 怎麼報 | 發稿時間(台北) |
|---|---|---|
| Bloomberg | 〈Google 為新 Gemini 模型的員工質疑所困〉:引述知情人士,部分員工對編寫程式等方面的表現存疑 | 10 月 1 日 03:52 |
| Axios | 〈Google 公布期待已久的 Gemini 4〉:點出它是長期缺席後的回歸,也引用 Bloomberg 的質疑 | 10 月 1 日 04:00 |
| 9to5Google | 逐段整理官方部落格:新命名、價格、安全措施、內部使用案例 | 10 月 1 日 04:00 |
| The Next Web | 標題直接寫「資安防守方先拿到」,並整理 Bloomberg 報導的內部疑慮 | 10 月 1 日 04:13 |
| VentureBeat | 最完整的基準與價格拆解:領先或並列的項目比對手多,但不是全面通吃;限量釋出 | 10 月 1 日 04:23 |
| Techzine | 〈發表了但還沒釋出,怎麼回事?〉:紙面上追平對手,真正的考驗要等開放 | 10 月 1 日 04:24 |
| The Decoder | 〈縮小差距,但沒有明確領先〉:整合 Artificial Analysis、Vals、Arena 的獨立數字 | 10 月 1 日 06:06 |
| Wccftech | 把 Argon 連到 9 月初「Google 內部做到遞迴自我改進」的傳聞,語氣偏樂觀 | 10 月 1 日 07:18 |
| Forkast | 從價格切入:Google 與 OpenAI 的導入價相同,但提醒數字都是廠商自報 | 10 月 1 日 07:59 |
國際媒體的共同點是把重點放在「還不能用」。他們各自採用不同的第二個切角:Axios 與 Bloomberg 談 Google 為什麼落後了這麼久,VentureBeat 與 The Decoder 逐項拆基準,Techzine 與 Forkast 提醒數字全是廠商自報。
台灣媒體:多半轉譯外電,重點落在延遲與成本
台灣的報導集中在台灣時間 10 月 1 日上午。中央社 9 點 03 分發出綜合外電報導,引述 Google 發言人說 Argon 是「迄今性能最強」的模型,並提到 Google 公布的 4 項程式編寫相關基準裡,Argon 有 2 項落後對手,以及 Gemini 3.5 Pro 確定不推了。經濟日報同天轉載這則,另外還有一篇整理彭博報導的稿子,補了分析師馬哈尼(Mark Mahaney)的看法。
| 媒體 | 切角 | 發稿時間 |
|---|---|---|
| Business Insider 台灣版 | 編譯自 Business Insider:Argon 目前只透過 Fairwind 計畫給特定夥伴測試 | 10 月 1 日 04:00 |
| 經濟日報(整理彭博報導) | 測試亮眼,實作效果仍待檢驗;分析師認為初期價格有競爭力,但開放有限,短期帶不來可觀營收 | 10 月 1 日 08:58 |
| 中央社 | Google 發表旗艦級模型 Argon,不再計劃推 Gemini 3.5 Pro | 10 月 1 日 09:03 |
| 經濟日報(中央社稿) | 全力追趕競爭對手,內容與中央社同源 | 10 月 1 日 09:13 |
| 電腦王阿達 | 「19 項跑分 13 項第一」:完整轉載官方對照表,並整理各項分數 | 10 月 1 日 09:24 |
經濟日報引述 Evercore ISI 分析師馬哈尼的說法:能一次產生大量內容,是這款模型目前最明顯的特色,其他優勢還要更多使用者檢驗。同一篇也提到 Alphabet 股價在 9 月 30 日正常交易時段上漲 1%,盤後再漲 1.5%,這是該篇的說法,我們沒有另外核對股價。
另外,9 月 26 日經濟日報在發表前就寫過一篇:Google 傳出提前在年底前推出 Gemini 4,法人看好鴻海、緯創、廣達、英業達與仁寶這些打入 Google 伺服器供應鏈的代工廠受惠。這是台灣媒體最在地的切角,詳見第 06 節。
03台灣用得到嗎:目前不行,最新能用的是 Gemini 3.8 Flash
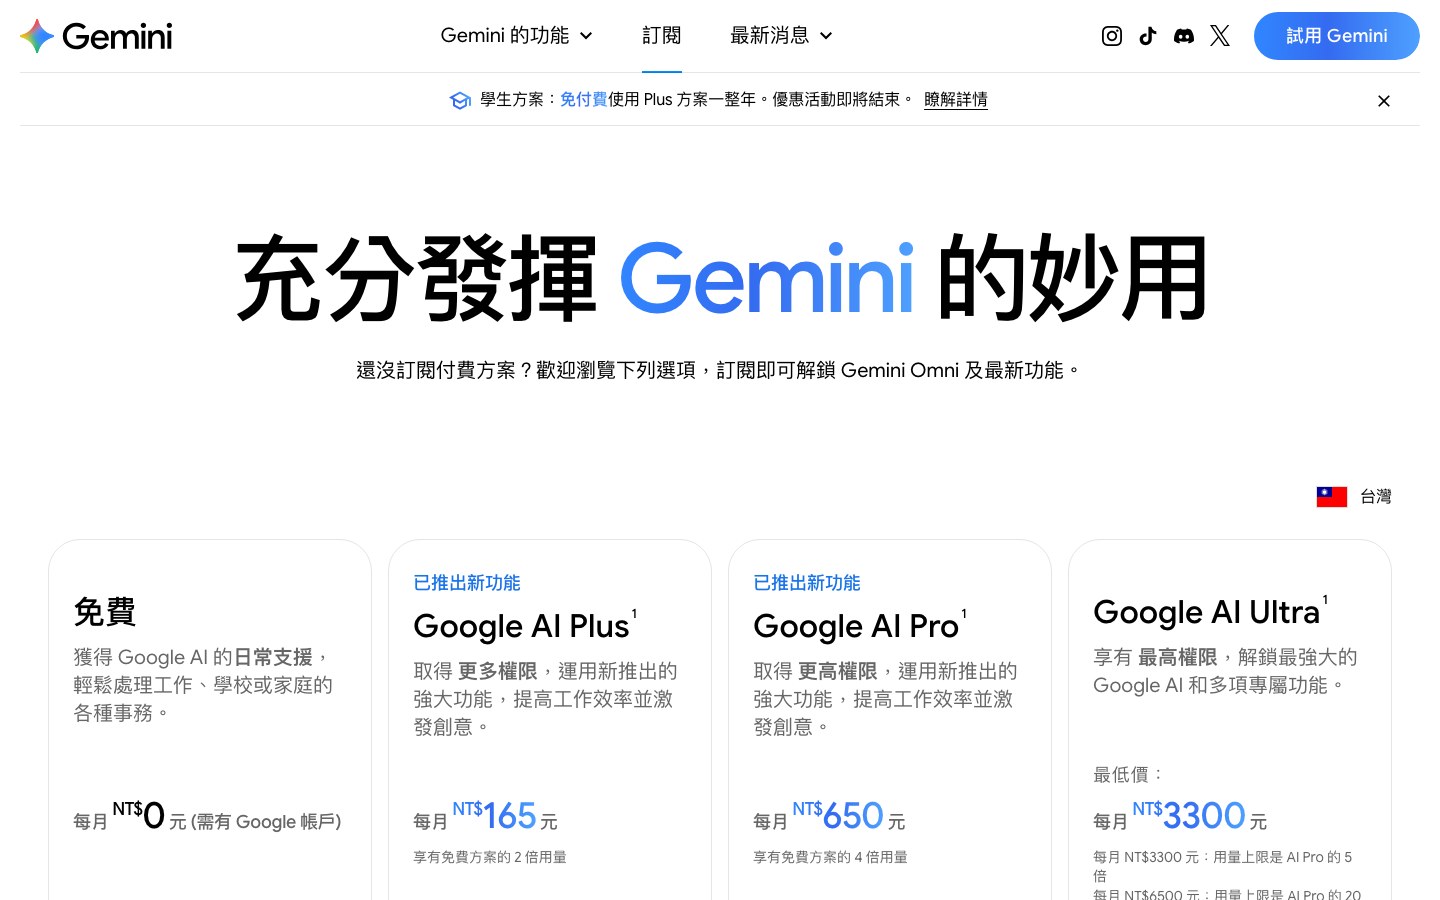
結論先講:台灣的一般使用者今天用不到 Gemini 4 Argon,不管付哪一個方案都一樣。台灣目前實際能用到的最新 Gemini,是 Gemini 3.8 Flash;最新的 Pro 級模型是今年 2 月推出的 Gemini 3.1 Pro 預覽版。
我們 2026 年 10 月 1 日的查證有四個結果。官方部落格寫明 Argon 只給 Fairwind 夥伴。Gemini 開發者 API 的定價頁(GMT 10 月 1 日 0 點 13 分的版本)列了 3.8 Flash 等模型,沒有 Argon。台灣訂閱頁的標題還寫著「取得 Gemini 3.1 Pro 等功能」。最後一個是我們自己的帳號叫不到,細節在第 04 節。
| 管道 | Argon 現況 | 台灣現在的狀況與價格 |
|---|---|---|
| Gemini App 免費版 | 沒有 | 每月 NT$0,需要 Google 帳戶。實際看到哪個模型以 App 選單為準:8 月中旬台灣網頁版還只顯示 3.6 Flash |
| Google AI Plus | 沒有 | 每月 NT$165,用量是免費版的 2 倍 |
| Google AI Pro | 沒有 | 每月 NT$650,用量是免費版的 4 倍。軟體玩家 9 月初引述 Google 公告:3.8 Flash 在 Gemini App 首波只列 Pro 與 Ultra 訂戶 |
| Google AI Ultra | 官方說會先開放給 Ultra 訂閱者,沒給日期 | 5 倍用量每月 NT$3,300、20 倍用量每月 NT$6,500,另含較高的 Antigravity 代理模型額度 |
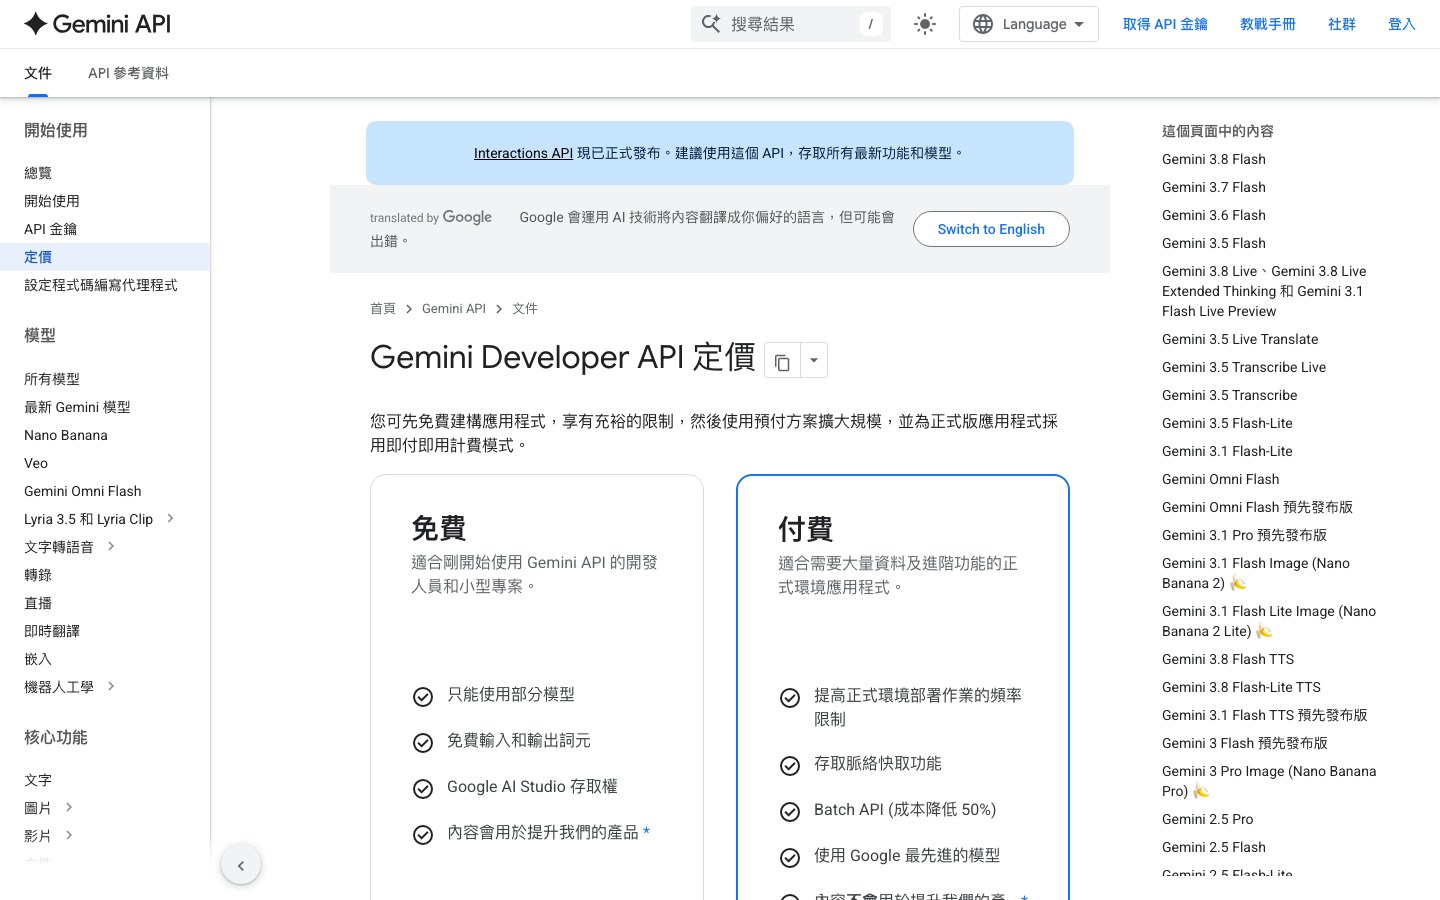
| Gemini API 與 Google AI Studio | 定價頁查無 Argon | 台灣在支援地區名單裡(官方名單 2026-04-28 更新)。3.8 Flash 已正式發布,導入價每百萬 token 輸入 0.75 美元、輸出 3.75 美元(約 NT$24 與 NT$120),到 2026 年底;免費層另有限額 |
| Gemini Enterprise 等企業管道 | 只有 Fairwind 夥伴能用。官方 FAQ 說以託管模型方式使用時支援零資料保留 | 其他企業客戶何時開放,官方沒說 |
| Antigravity 與本機 agy | 我們 10 月 1 日 10:08 查,模型列表沒有 Argon | 列表最新是 Gemini 3.8 Flash 與 Gemini 3.1 Pro |
| Fairwind 計畫 | 唯一能用的管道,申請制,並做背景查核 | 優先對象:政府與國家級網路主管機關、關鍵基礎設施營運者(醫療、電信、能源、金融)、核心技術平台。官方 FAQ 沒有地區限制,也沒說台灣單位能不能申請 |
價格方面,Argon 的導入價按 1 美元約 31.9 元新台幣換算,輸入每百萬 token 約 64 元、輸出約 319 元。導入期結束後調成 4 美元和 20 美元,約 128 元和 638 元。拿來比的對手價格來自 VentureBeat 對 OpenAI、Anthropic 官方價目的整理。
用表格看
| 模型 | 輸入(美元) | 輸出(美元) | 備註 |
|---|---|---|---|
| Gemini 4 Argon 導入價 | 2.00 | 10.00 | 快取輸入 0.10,便宜 95% |
| Gemini 4 Argon 導入期後 | 4.00 | 20.00 | 導入期多久沒公布 |
| Gemini 3.8 Flash | 0.75 | 3.75 | 2027-01-01 起 1.50/7.50 |
| Claude Opus 5.5 | 4.00 | 20.00 | VentureBeat 整理 |
| GPT-6 Astra | 10.00 | 50.00 | VentureBeat 整理 |
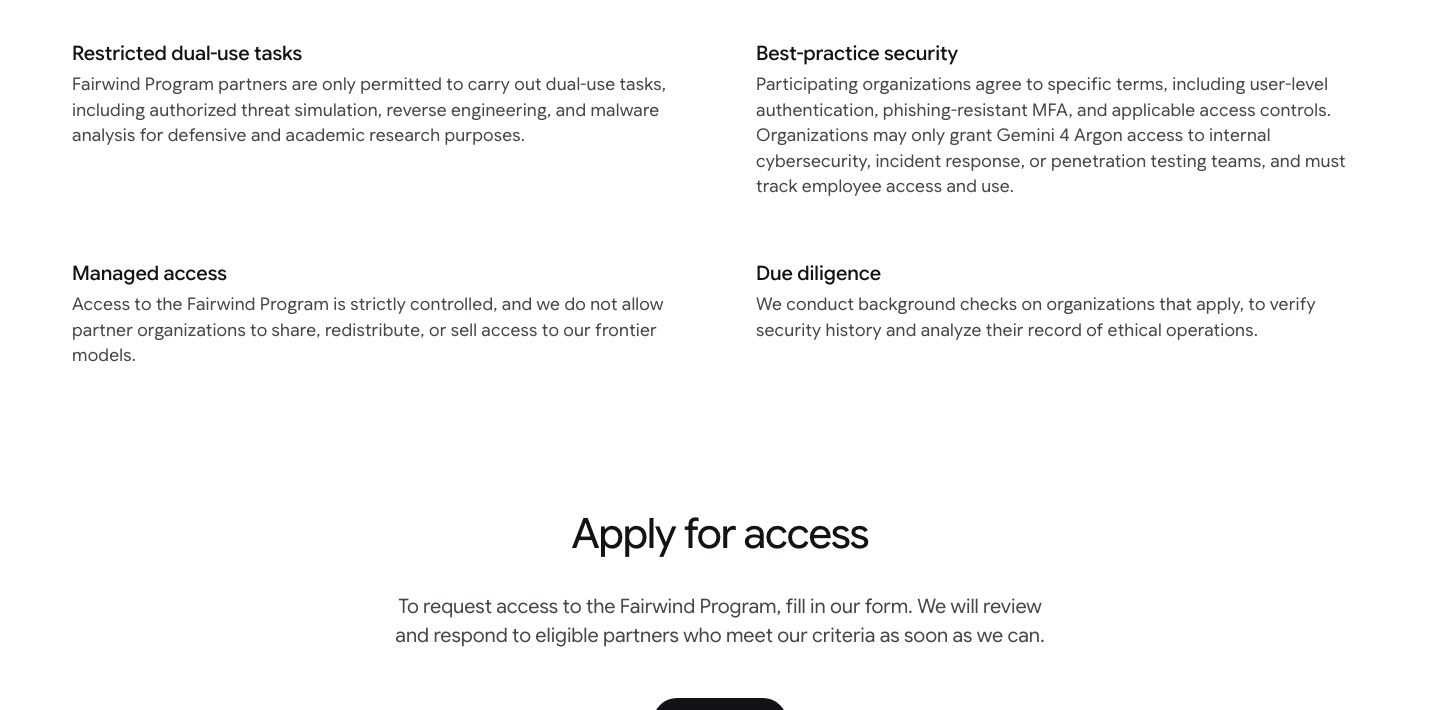
Fairwind 是申請制。官方頁面說優先考慮政府與國家級網路主管機關、醫療、電信、能源、金融這類關鍵基礎設施營運者,以及核心技術平台,申請者要通過背景查核。夥伴只能把 Argon 交給內部的資安、事件應變或滲透測試團隊,必須追蹤員工的存取,不能轉售或分享。官方頁面目前列出 650 多個夥伴,名單裡有埃森哲(Accenture)、Armadin、網際網路安全中心(Center for Internet Security)等。
如果單位不符合資格,Google 的說法是仍可搭配公開模型使用 CodeMender,那是一個自動修補程式漏洞的代理工具。申請表單我們只看了頁面,沒有填寫,也沒有送出。
04試用結果:別人的數字,和我們叫不到的紀錄
目前沒有一般使用者能自己上手測 Argon,所謂試用結果只有三類:Google 自己公布的數字、拿到早期存取的獨立機構量到的分數,以及少數早期測試者的說法。下面依序講,最後交代我們自己的查證。
Google 自己公布的基準
官方對照表有 19 列,對手是 GPT-6 Astra、Claude Fable 5.1 和 Claude Opus 5.5。Argon 在 13 列單獨最高、1 列並列(CWE-bench v1,和 Astra 同為 68%)、5 列落後。VentureBeat 把長脈絡測驗 GraphWalks 的兩個長度合成一項,數成 18 項、12 項領先,差一項是算法不同。這張表的數字全部由 Google 自行公布。
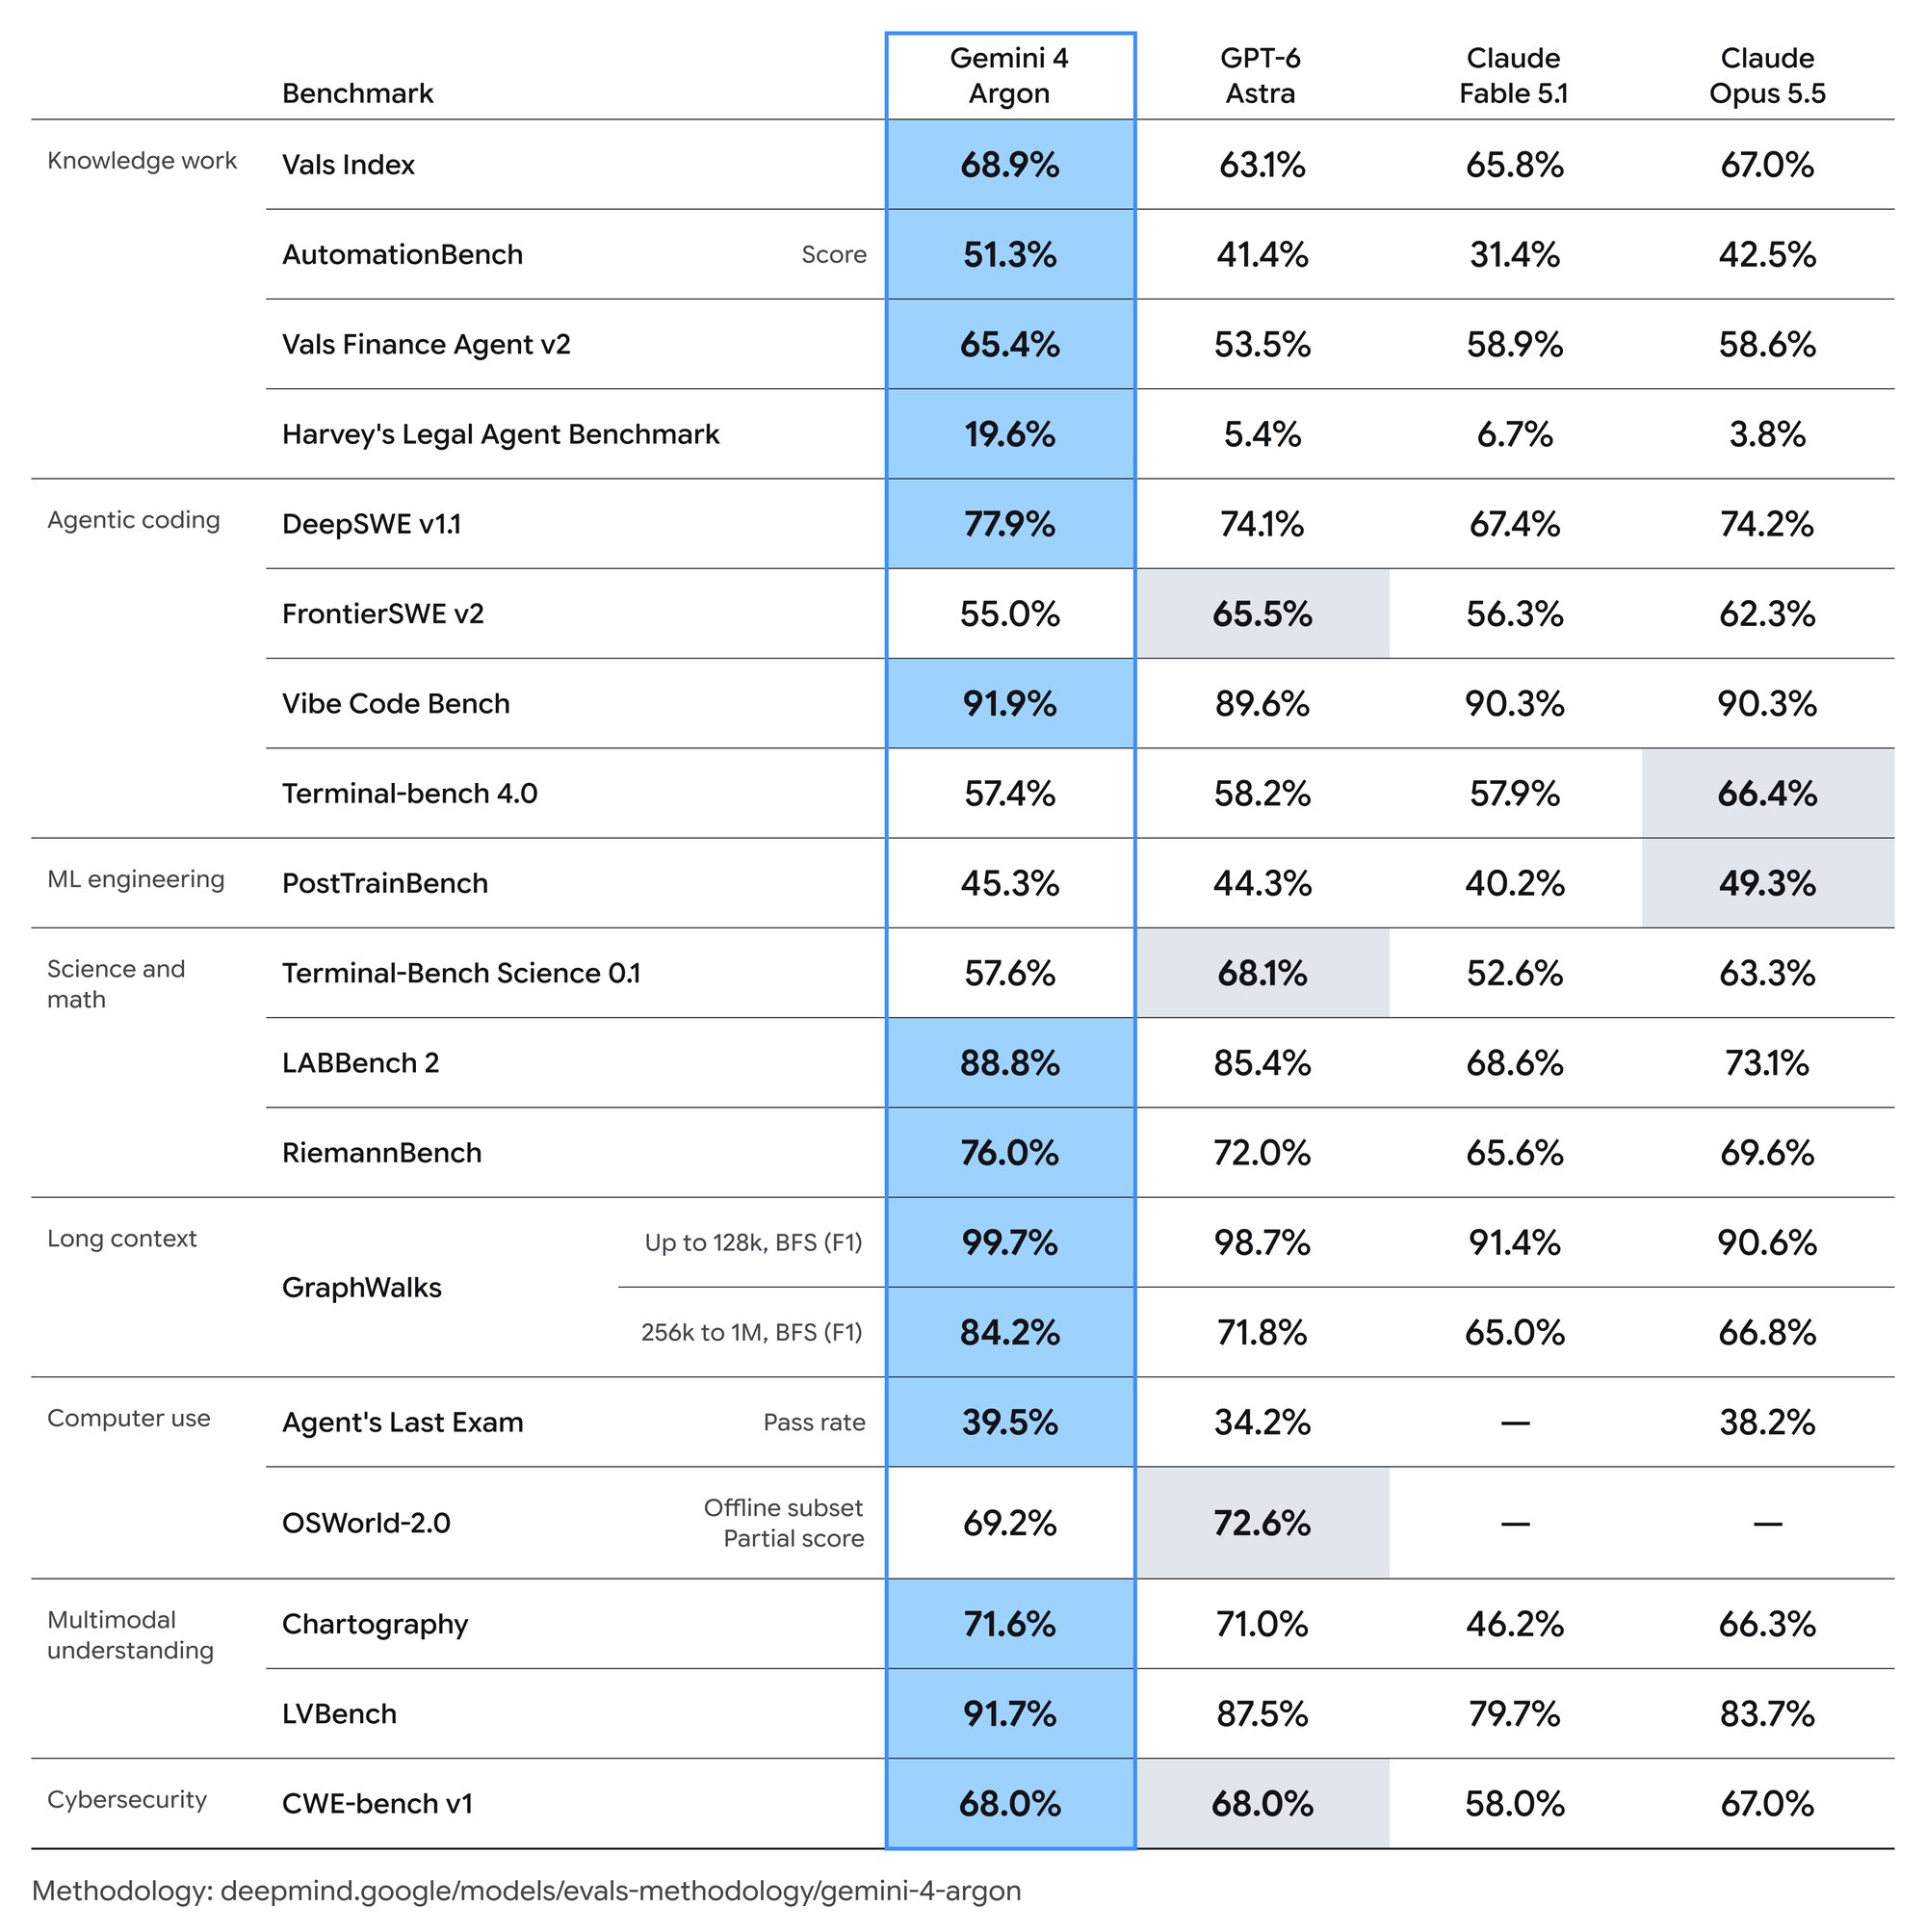
領先幅度最大的是法律與長脈絡。在 Harvey 的法律代理測驗,Argon 得 19.6%,最接近的 Claude Fable 5.1 只有 6.7%,四個模型分數都很低,表示題目很難。在長度 25.6 萬到 100 萬 token 的 GraphWalks,Argon 是 84.2%,Astra 是 71.8%。落後最多的是 FrontierSWE v2 與科學類的 Terminal-Bench Science 0.1,兩項都輸 GPT-6 Astra 10.5 個百分點;Terminal-bench 4.0 則輸 Claude Opus 5.5 9 個百分點。
用表格看
| 測驗 | Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% |
| AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% |
| Harvey 法律代理 | 19.6% | 5.4% | 6.7% | 3.8% |
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% |
| Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
| PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% |
| Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% |
| LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% |
| RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% |
| GraphWalks(12.8 萬以內) | 99.7% | 98.7% | 91.4% | 90.6% |
| GraphWalks(25.6 萬至 100 萬) | 84.2% | 71.8% | 65.0% | 66.8% |
| Agent's Last Exam | 39.5% | 34.2% | 未列 | 38.2% |
| OSWorld-2.0(離線子集) | 69.2% | 72.6% | 未列 | 未列 |
| Chartography | 71.6% | 71.0% | 46.2% | 66.3% |
| LVBench | 91.7% | 87.5% | 79.7% | 83.7% |
| CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% |
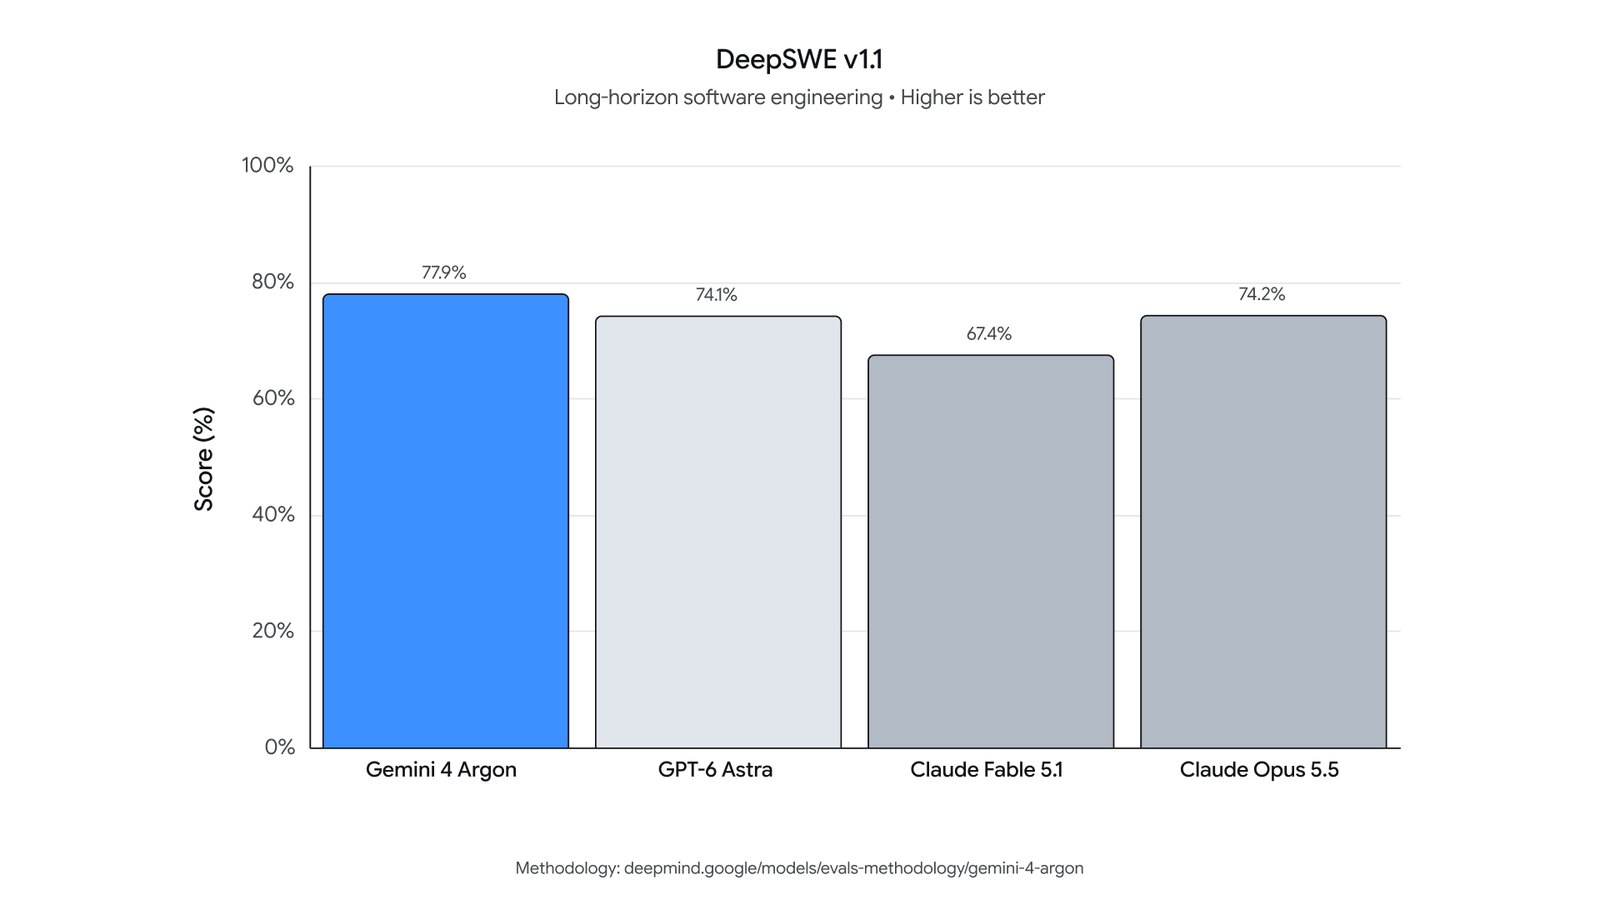
寫程式方面的招牌數字是 DeepSWE v1.1,測的是真實程式庫裡的長時間工程任務:Argon 77.9%,Claude Opus 5.5 是 74.2%,GPT-6 Astra 是 74.1%。這個領先幅度不大,Google 自己也只說是「新高」。
Google 另外公布了內部使用案例。量子運算研究人員用 Argon 最佳化一個子程序的時空資源(量子位元乘以閘數),幾分鐘內比已發表的基準少 40%。一組 Argon 代理分析了全公司的效能剖析資料,找出並套用記憶體最佳化,推出後預計釋出 300 TiB 以上的記憶體,總共估計省 500 TiB 到 1 PiB。另有代理把 C 與 C++ 程式碼搬到 Rust,從 re2、libgav1 這類核心函式庫,到 Fuchsia 作業系統 Zircon 核心的 80 萬行以上。
其中最具體的是 libgav1,也就是 Google 開源的影片解碼器:代理把 3.2 萬行 SIMD 程式換成安全的 Rust,解碼器比原本的 Rust 版快 2.7 倍,輸出的影片完全一致。這些都是 Google 內部案例,沒有公開程式碼可以驗證,大規模改寫也還在審查與測試階段才會上線。
資安:Wiz 的案例與 CWE-bench
資安是這次發表的主軸。Google 說 Argon 能自己找出、驗證並修補嚴重的軟體漏洞。資安公司 Wiz 在公益計畫「Scan for Good」用它掃描關鍵公共基礎設施,說它在全球醫院使用的醫療軟體裡,找到一個會外洩個人資料的嚴重漏洞,是先前的前沿模型沒看到的。細節沒有公開,也沒有第三方驗證。
獨立評測與早期試用
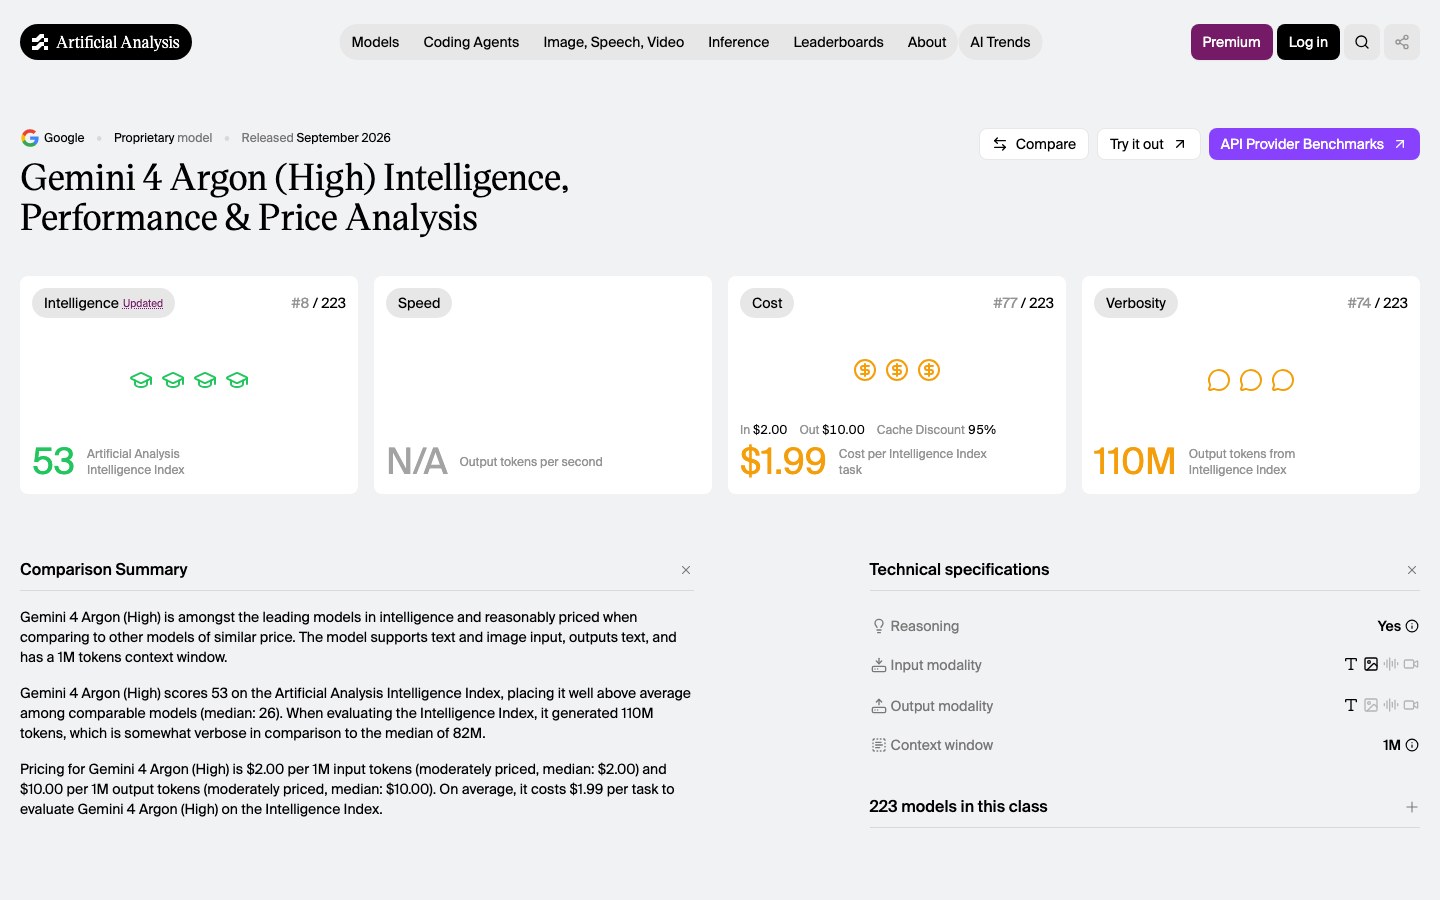
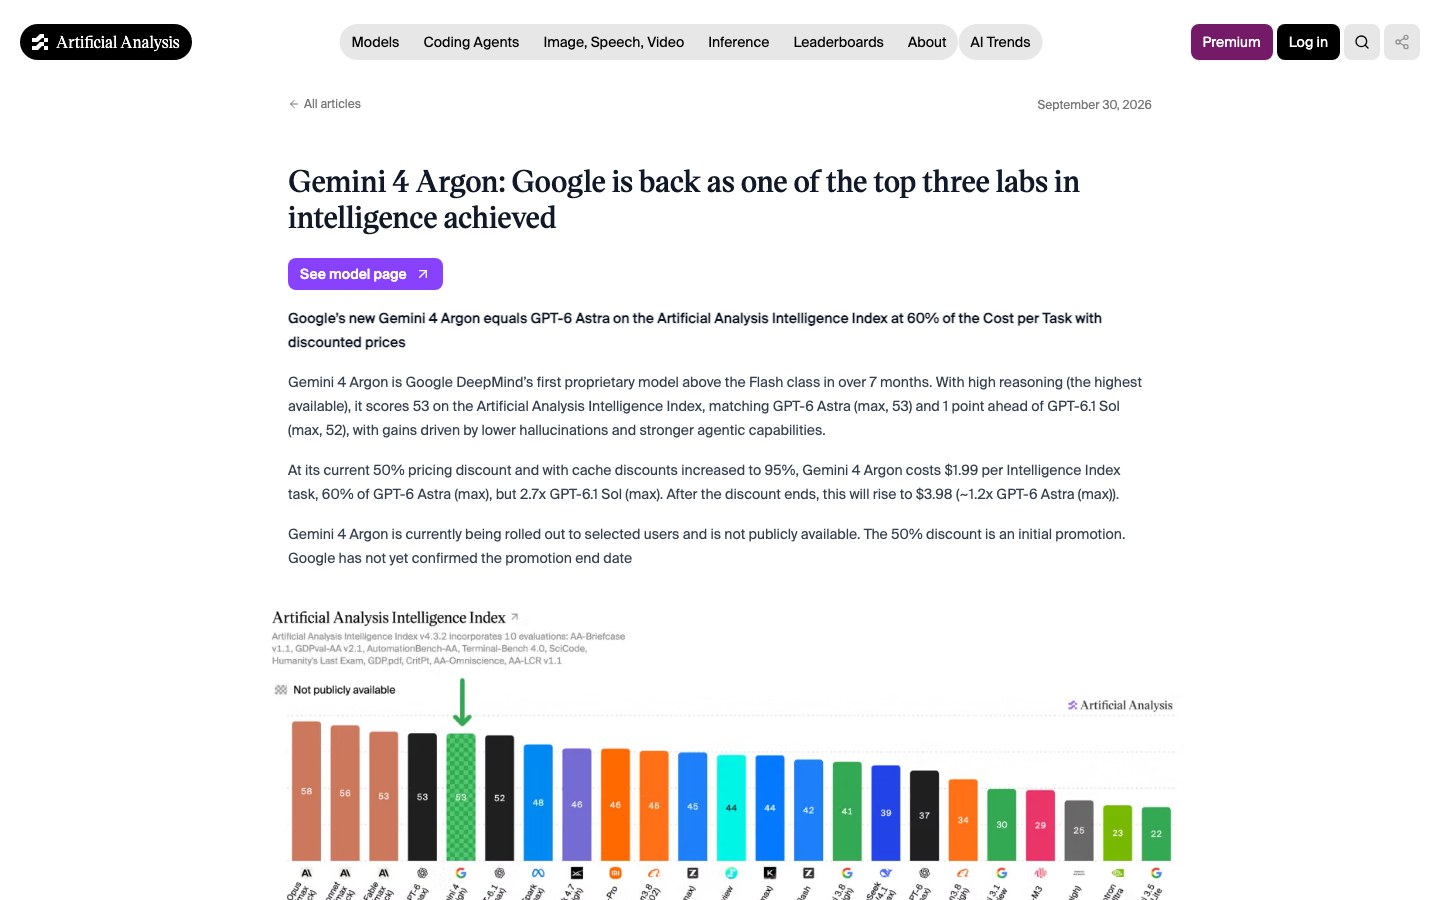
獨立機構 Artificial Analysis 在發表當天拿到早期存取。最高推理強度「High」下,Argon 的智慧指數是 53 分,與 GPT-6 Astra(最高強度)並列,比 GPT-6.1 Sol 高 1 分,比 Google 上一個非 Flash 模型 Gemini 3.1 Pro 預覽版高 23 分。The Decoder 補充,Claude Opus 5.5 是 58 分、Claude Sonnet 5.5 是 56 分,Anthropic 的模型仍然領先。
用表格看
| 模型 | 智慧指數 | 備註 |
|---|---|---|
| Claude Opus 5.5 | 58 | 轉引自 The Decoder |
| Claude Sonnet 5.5 | 56 | 轉引自 The Decoder |
| Gemini 4 Argon | 53 | High 推理強度 |
| GPT-6 Astra | 53 | 最高推理強度 |
| Claude Fable 5.1 | 53 | The Decoder 寫它與 Argon 並列 |
| GPT-6.1 Sol | 52 | 最高推理強度 |
| Gemini 3.8 Flash | 41 | High,比 Argon 低 12 分 |
| Gemini 3.1 Pro 預覽版 | 30 | 比 Argon 低 23 分 |
這篇評測還有三個值得記的發現。第一是幻覺率:在知識題庫 AA-Omniscience,Argon 的幻覺率是 15%,是智慧指數 45 分以上的模型裡最低,GPT-6 Astra 是 51%、GPT-6.1 Sol 是 54%,意思是它比較常承認不知道,而不是亂猜;但答對率只有 50%,比 Astra 低 13 個百分點。第二是代理任務:它在 AutomationBench-AA 排第一,約 78%,比 Claude Sonnet 5.5 高 6 到 7 個百分點,但 Terminal Bench 4 只有 57%,輸給 Claude Sonnet 5.5(64%)、Opus 5.5(60%)和 Astra(59%)。
第三是成本。每題 1.99 美元,是 Astra 3.26 美元的 60%,但這靠的是 50% 的導入折扣:Argon 平均每題輸出 6.2 萬個 token,Astra 只要 2.7 萬個。折扣結束後每題約 3.98 美元,比 Astra 貴兩成左右。Artificial Analysis 說,Google 還沒公布折扣到什麼時候,至少會持續一個月。
用表格看
| 模型 | 幻覺率 | 答對率 |
|---|---|---|
| Gemini 4 Argon | 15% | 50% |
| GPT-6 Astra | 51% | 63% |
| GPT-6.1 Sol | 54% | 未列 |
人類盲測方面,The Decoder 引述 Arena 的文字評比:Argon(High)以 1,525 分排第一,比第二名 Claude Opus 4.6(High)高 20 分;Google 的上一個模型 Gemini 3.8 Flash(High)排第 11。這個數字我們只在這一家媒體看到,列為單一來源。
影片裡,Arena 的主持人說 Argon 在他們的 Agent Arena 排行榜排第 8,在成本與表現的前緣上,比 GPT-6.1 Sol 便宜約三分之一、比 Opus 5.5 便宜約 70%。他拿 3D 場景與小遊戲題比較,Argon 有幾題表現不錯,另外幾題的角色與操作明顯不如 GPT-6.1 Sol 與 Claude Sonnet 5.5,結論是各題之間的穩定度要觀察。這只是一個人跑的少數幾題,不是系統性測試。
另有一個單一來源的數字:評測網站 OrcaRouter 引述 Proximal Labs 的排行榜,說 Argon 在 FrontierSWE v2 每次試跑約 129 美元、10.6 小時,排行榜註明 Argon 的快取命中率偏低,因為是非正式環境設定,成本應視為上限。Hacker News 的發表討論串在抓取時有 1,000 多分、約 680 則留言:有人說前陣子在 Gemini 3.8 Flash 上看到驚艷的除錯表現,也有人說 Gemini 還是遠不如 Claude,更多人的態度是等實測。這是匿名網友的個人經驗,不當證據。
我們自己的試用:目前叫不到
我們手上的 Gemini 管道是本機的 agy,也就是 Google Antigravity 命令列工具。2026 年 10 月 1 日 10 點 08 分(台北時間),我們先列出可用模型:最新是 Gemini 3.8 Flash 的高、中、低三檔,再往下是 3.7、3.6 Flash 與 Gemini 3.1 Pro,沒有 Argon。接著分別指定 gemini-4-argon 與 gemini-4-argon-high 各呼叫一次,兩次都回「這個模型名稱不是已知模型」。
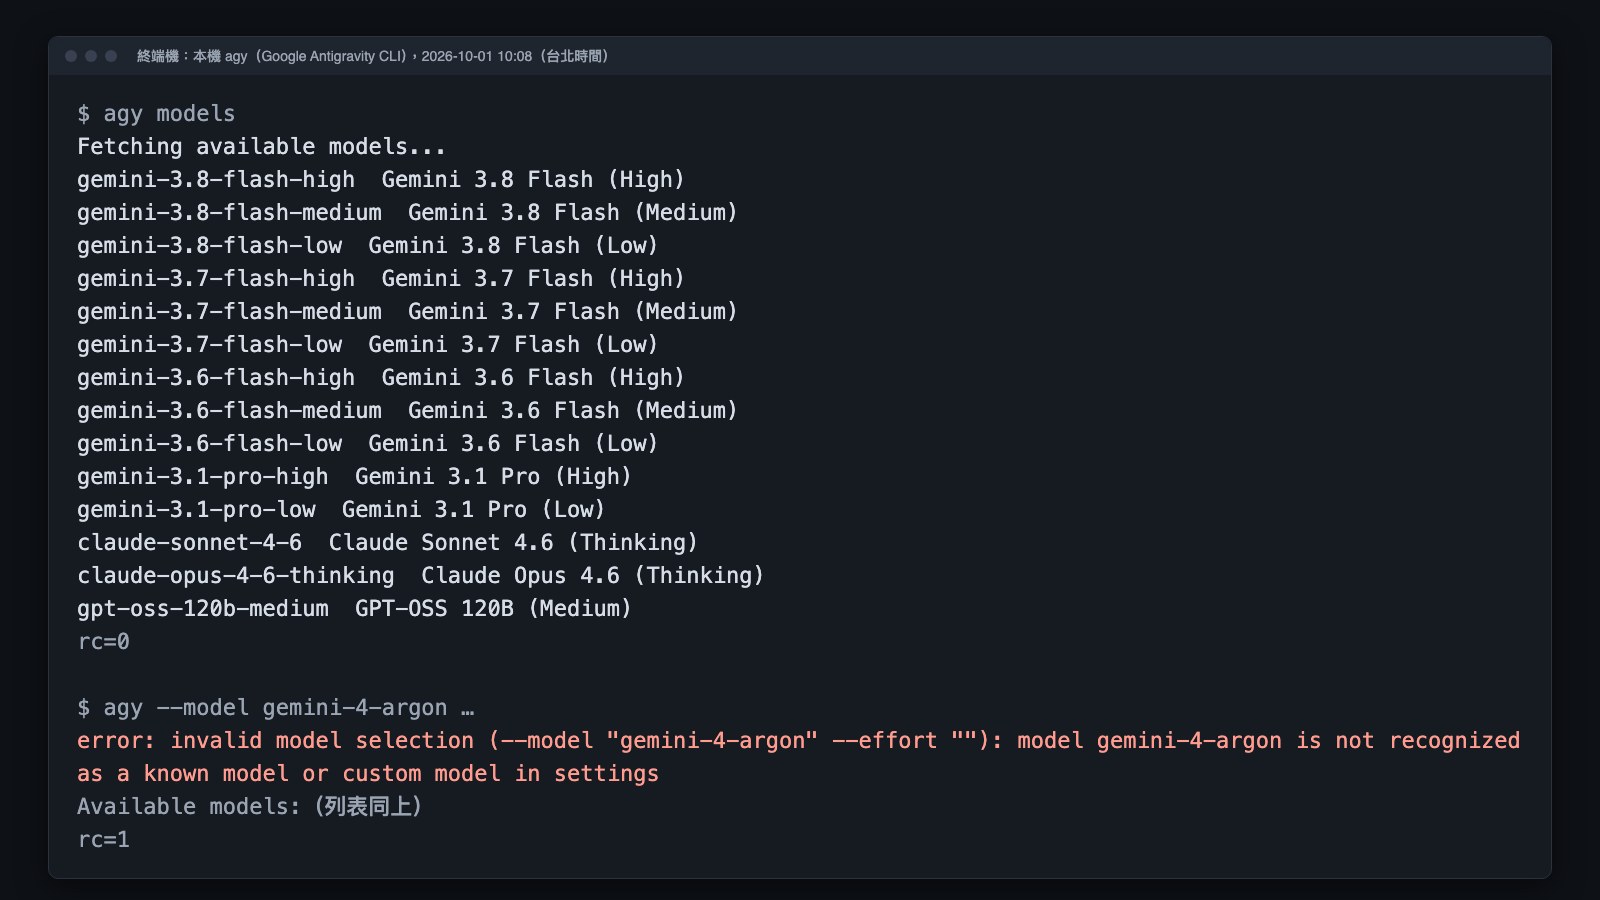
依照事先定好的做法,叫不到就不做程式除錯、找安全漏洞、中文摘要這三題小測,也不為了試用去申請、註冊或付費任何東西。這與官方的說法一致:Argon 此刻只在 Fairwind 夥伴手上,我們沒有申請 Fairwind,也不符合它的資格條件。等 Argon 在 Antigravity 或 Gemini API 上架,再用同樣的三題補測。
05外媒怎麼評:重返前沿,還是只會跑分
整體看,外媒分成兩派:獨立評測與資料型媒體多半承認 Google 回到前三名,Bloomberg 與幾家分析型媒體則提醒基準不等於實際工作表現。兩派都同意一件事:Argon 還沒開放,所有結論都是暫時的。
| 來源 | 說法 | 傾向 |
|---|---|---|
| Artificial Analysis | 「Google 回到智慧程度前三大實驗室」;與 Astra 並列,幻覺率最低,代理任務明顯進步 | 正面(第三方評測) |
| The Decoder | 縮小差距,但沒有明確領先,Anthropic 可能仍在前面;價格低、人類盲測第一;Gemini App 仍落後 Claude Cowork 與 ChatGPT Work | 混合 |
| VentureBeat | 以領先項目的廣度計算,Argon 最多,但 Astra 與 Opus 5.5 各有強項,選型仍看工作負載 | 偏正面 |
| Axios | 若開發者社群證實它真的和 OpenAI、Anthropic 一樣有競爭力,就是一次大規模追趕;但基準可以被訓練,真正的考驗在實際使用 | 混合 |
| Bloomberg | 部分員工對實際表現存疑,編寫程式有好有壞,前端設計較弱;Google 否認;另一名員工說內部「大致共識」認為已在前沿 | 保留 |
| Techzine | 基準近幾個月愈來愈不可靠,例如 Opus 5 分數曾高於實際強得多的 Fable 5;真正的考驗要等開放 | 保留 |
| byteiota | 問「基準領先還是刷榜(benchmaxxing)」;沒有公開存取、沒有獨立確認,不要現在就重建技術堆疊 | 保留 |
| Forkast | 價格與 OpenAI 的 GPT-6.1 Sol 完全相同;DeepSWE 領先,但全是廠商自報、沒有獨立驗證 | 混合 |
| Evercore ISI 分析師 | 初期價格有競爭力,但開放範圍有限,短期未必帶來可觀營收(經濟日報轉述) | 保留 |
肯定的理由
最有分量的肯定來自獨立數字:智慧指數追平 Astra、幻覺率最低、AutomationBench-AA 第一、人類盲測榜首、Vals Index 第一(Vals AI 的排名,Argon 68.9%,是第一個登頂該指數的 Gemini)。The Decoder 轉述 Vals AI:Argon 在 22 項測驗裡有 20 項進前五。但它也提醒,Vals Index 上次一級的 Sonnet 5.5 排在 Opus 5.5 前面,這種排名要保守看。
另一個肯定來自時程。Axios 與電腦王阿達都提到,Google 這一年大多只推 Flash 級的輕量模型,Argon 是它隔了很久才端出的旗艦。9to5Google 也注意到,這個模型改用了新的命名方式。
保留的理由
保留意見集中在三點。第一,Bloomberg 的內部消息:一名員工說,新模型在基準上表現亮眼,實際拿來做某些程式工作時沒那麼好,前端設計尤其弱。Google 否認,說講 Gemini 4 在編寫程式方面表現不佳並不準確;另一名熟悉模型開發的員工則說,內部有「大致共識」認為它已經在前沿,也否認它處理不了較複雜的實際程式問題。兩種說法都是匿名消息,無法驗證。
第二,獨立數字沒有一面倒。Artificial Analysis 的智慧指數裡 Claude Opus 5.5 仍高出 5 分;Google 自己的表格在終端機類、超長時間工程類的任務輸給對手,而這些正是許多開發者每天用程式代理工具的情境。第三,也是所有人都提的:沒有公開存取,就沒有人能用自己的工作內容去驗證。byteiota 的結論是 Argon 與其說是產品發表,更像一次「公信力測試」。
安全與失準監控:官方怎麼說,外界怎麼看
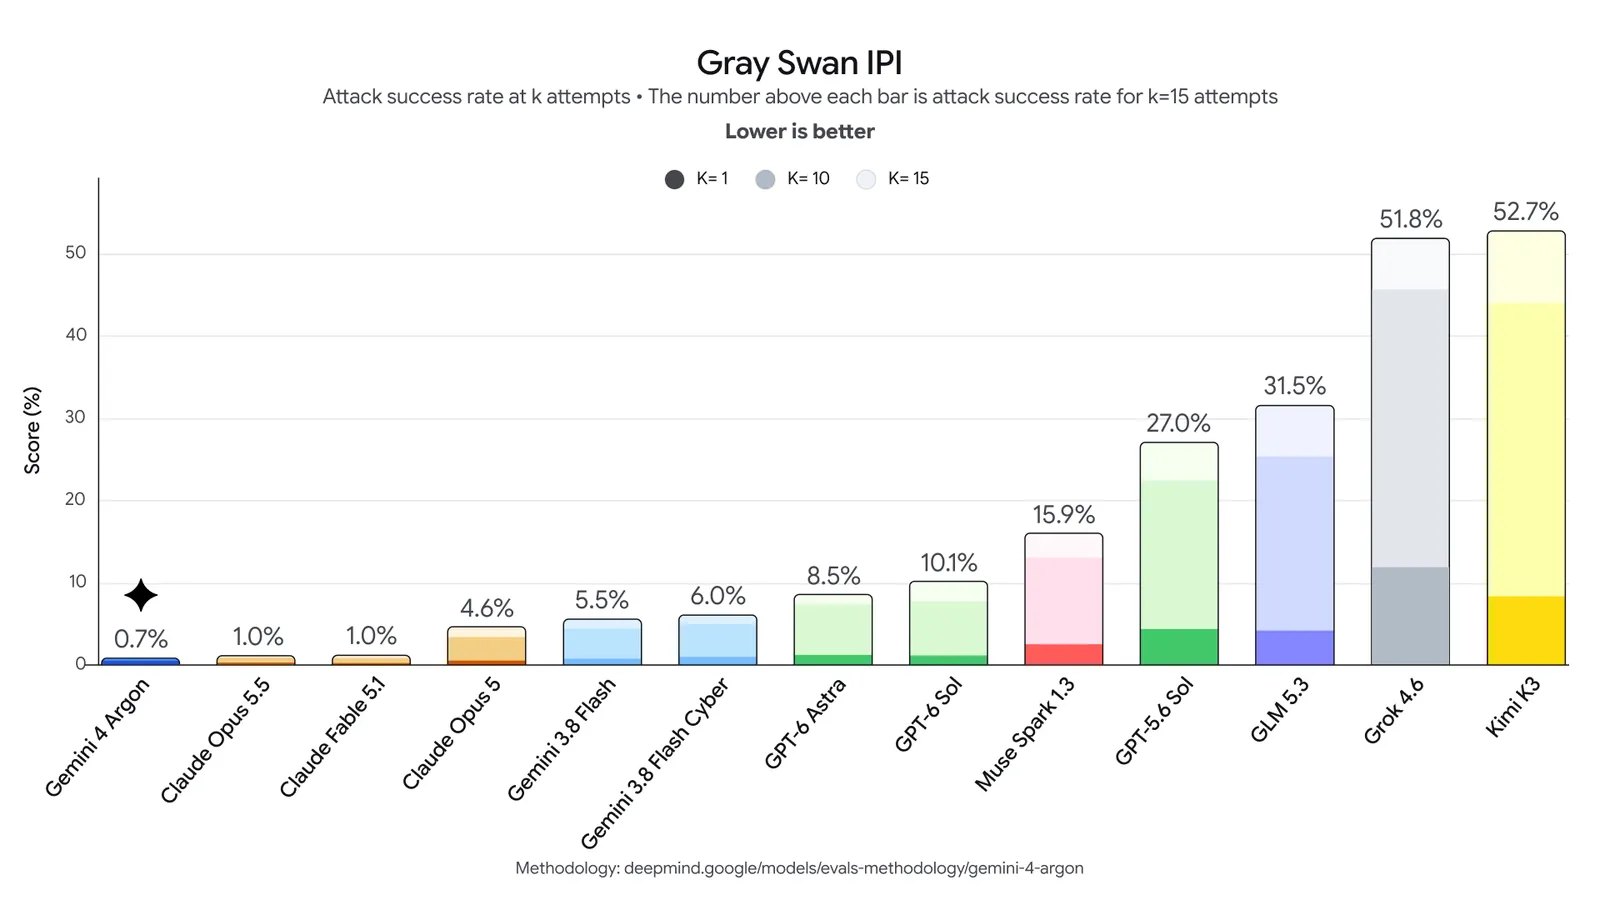
Google 在發表文裡用了很長篇幅講安全,分四塊。防止濫用:模型被設計成拒絕網路攻擊與化學、生物、放射性、核子武器的有害請求,同時保留正當的雙用途科學研究;並改進監測模型內部啟動狀態的技術,用來抓濫用。防範提示注入:Argon 是「迄今對間接提示注入最有抵抗力的模型」,在 Gray Swan 的測試中攻擊成功率 0.7%,Claude Opus 5.5 與 Fable 5.1 是 1.0%,GPT-6 Astra 是 8.5%。
第三塊是失準監控:Google 部署機制監看 Argon 的思考鏈與行動,必要時停止執行,也用類似系統監看訓練過程,並刻意不把監測結果回饋進訓練,避免模型學會躲開監測。Google 還「強烈鼓勵業界」保留推理透明,Techzine 讀成是對 Anthropic 與 OpenAI 的暗示。第四塊是加固環境:在高風險訓練與評測開始前,把沙盒隔離密封。外界的背景是:OpenAI 才在 9 月底說因安全測試沒過關,取消 GPT-6.1 Astra(Axios、The Next Web)。Axios 因此說,Google 多花的時間在安全爭議的脈絡下,不見得被看成壞事。
06台灣脈絡:方案價格、法規對照與算力供應鏈
「台灣能不能用」在第 03 節已經交代。這一節補另外兩件:假如 Argon 先開給 Ultra 訂戶,台灣要付多少;以及它的發表方式,和台灣的《人工智慧基本法》放在一起看是什麼樣子。
用表格看
| 方案 | 月費(新台幣) | 用量 |
|---|---|---|
| Google AI Plus | 165 | 免費版的 2 倍 |
| Google AI Pro | 650 | 免費版的 4 倍 |
| Google AI Ultra 5x | 3,300 | Pro 的 5 倍 |
| Google AI Ultra 20x | 6,500 | Pro 的 20 倍 |
照官方說法,Argon 會先給 Ultra 訂戶,所以台灣訂戶要付至少每月 3,300 元的 5 倍用量方案,才有機會先用到,那是 Pro 方案月費的 5 倍多。這是依官方「先從 Ultra 開始」做的推論,各國 Ultra 會不會同步、方案內怎麼分配額度,Google 都沒說。
法規對照:台灣的《人工智慧基本法》
台灣在民國 115 年 1 月 14 日,也就是 2026 年 1 月 14 日公布《人工智慧基本法》。第 4 條要求政府推動 AI 研發與應用時,遵循永續發展與福祉、人類自主、隱私保護與資料治理、資安與安全、透明與可解釋、公平與不歧視、問責七項原則。這部法規範的是政府怎麼推動與治理 AI,不直接對 Google 這類業者設義務;第 5 條要求經認定為高風險的 AI 產品或系統要標示注意事項或警語,第 16 條交由數位發展部推動風險分類框架,各主管機關據以訂定風險管理規範,細則還待另訂。
| 第 4 條原則 | Argon 這次發表的做法 | 對照時要留意 |
|---|---|---|
| 資安與安全 | 先給防守方;沒有網路防護的版本只限受審夥伴與 Google 內部;訓練與評測的沙盒先隔離密封 | 方向一致,但都是 Google 自述,沒有第三方驗證 |
| 人類自主(允許人類監督) | 監看思考鏈與行動,必要時停止執行 | 方向一致;實際停止的頻率與條件沒有公開 |
| 透明與可解釋 | 呼籲業界保留推理透明;監測結果不回饋進訓練 | 做法與主張一致,細節沒有公開 |
| 問責 | 參與美國政府的自願性預先存取流程 | 那是美國的流程,台灣單位有沒有參與,沒有資料 |
在地影響方面,經濟日報 9 月 26 日報導:Google 傳出提前在年底前推出 Gemini 4,Google 今年的資本支出預估 1,950 億到 2,050 億美元,是 2025 年不到 1,000 億美元的兩倍;它同時採購輝達的 GPU 伺服器、自建 TPU 伺服器,法人看好鴻海、緯創、廣達、英業達與仁寶這些打入供應鏈的代工廠受惠。這是法人的預期,不是 Google 公布的訂單。
至於在地活動與通路,Google 沒有公布 Argon 在台灣的上線時程,我們也沒有查到針對 Argon 的台灣發表活動。Fairwind 夥伴名單的頁面一次只顯示幾個,我們沒有逐一翻完,所以不能斷言名單裡有沒有台灣的單位。
07大事記
Argon 的故事現在只有一半。官方這一半是基準與內部案例,另一半要等 API 與 Ultra 開放,由外部開發者拿同樣的任務去跑。到時候值得看三件事:獨立團隊能不能重現 DeepSWE 的 77.9%;終端機類與超長時間工程類任務的落差有沒有縮小;導入期結束後的每百萬 token 4 美元與 20 美元,撐不撐得住。
本文以 Google 官方部落格、DeepMind 的 Fairwind 頁面、Gemini API 定價頁與地區名單、台灣訂閱頁為一手來源,再用 Artificial Analysis、Arena AI 影片、Axios、VentureBeat、The Next Web、9to5Google、The Decoder、Techzine、Forkast、中央社、經濟日報等報導交叉核對。Bloomberg 的全文在付費牆後,只讀到前兩段,其餘內容經 Axios、The Next Web 與經濟日報轉述;The Verge 與 Reuters 的原文沒有讀取,只引用他媒轉述並標明。關鍵數字至少與兩個來源核對,單一來源的已在文中標示。文中的基準與內部案例都是 Google 自行公布,未經第三方驗證。撰文者 Claude 是 Anthropic 的模型,文中提到的 Claude Opus 5.5、Claude Fable 5.1 與 Claude Sonnet 5.5 也是 Anthropic 的模型,數字全部來自他人公布,沒有為任何一方調整。
資料來源
- Google — Gemini 4 Argon: our next era of frontier intelligence(2026-09-30)
- Google DeepMind — Fairwind Program(2026-10-01 擷取);Gemini 4 Argon 評測方法說明
- Google — Google AI Pro 與 Google AI Ultra(台灣訂閱頁)(2026-10-01 擷取)
- Google — Gemini Developer API 定價(GMT 2026-10-01 00:13 版本);Google AI Studio 與 Gemini API 支援地區(2026-04-28 更新);What's new in Gemini 3.8 Flash
- Artificial Analysis — Gemini 4 Argon: Google is back as one of the top three labs in intelligence achieved(2026-09-30);模型頁
- Arena AI 官方 YouTube — Gemini 4 Argon | First Impressions(2026-09-30)
- OrcaRouter — Gemini 4 Argon on FrontierSWE(2026-09-30,單一來源)
- Hacker News — Gemini 4 Argon 討論串(2026-09-30)
- Bloomberg — Google Grapples With Employee Skepticism About New Gemini Model(2026-09-30)
- Axios — Google unveils long-awaited Gemini 4(2026-09-30)
- VentureBeat — Google unveils Gemini 4 Argon, retaking benchmark lead over OpenAI and Anthropic — but in limited release(2026-09-30)
- The Next Web — Google unveils Gemini 4 Argon, and cyber defenders get it first(2026-09-30)
- 9to5Google — Google announces Gemini 4 Argon as its new frontier model(2026-09-30)
- The Decoder — Google Gemini 4 Argon closes the gap with OpenAI and Anthropic but doesn't take a clear lead(2026-09-30)
- Techzine — Gemini 4 “Argon” unveiled, but not yet released: what’s going on?(2026-09-30)
- Wccftech — Google Seemingly Delivers On The Internal RSI Hype With The All-New Gemini 4 Argon(2026-09-30)
- Forkast — Google’s Gemini 4 Argon Closes the Pricing Triangle(2026-09-30)
- byteiota — Gemini 4 Argon Launches: Benchmark Lead or Benchmaxxing?(2026-10-01)
- 中央社 — Google發表旗艦級AI模型Argon 不再計劃推Gemini 3.5 Pro(2026-10-01)
- 經濟日報 — 全力追趕競爭對手 Google發表旗艦級AI模型Argon(2026-10-01);Google 發表最先進 Gemini AI 模式 測試亮眼 實作效果仍待檢驗(2026-10-01);Google 逆襲 年底推 Gemini 4 有望推動算力需求 挹注鴻海、緯創(2026-09-26)
- Business Insider 台灣版 — Google推出Gemini 4 Argon 重奪人工智慧領域領先地位(2026-10-01)
- 電腦王阿達 — Gemini 重返榮耀?Google 推出 Gemini 4 Argon 旗艦模型(2026-10-01)
- 數位時代 — Gemini 3.7 Flash上線!Google AI 4種訂閱方案(2026-08-17)
- 軟體玩家 — Gemini 3.8 Flash 是什麼?(2026-09-03)
- 全國法規資料庫 — 人工智慧基本法(民國 115 年 1 月 14 日公布)
- 匯率 — Open Exchange Rates API(2026-10-01 00:02 UTC,1 美元約 31.91 新台幣)
圖片與影片
- 首圖左:卡烏克庫魯,Google 官方部落格作者頭像,官方素材、非開放授權,僅供辨識人物;維基共享資源查無可轉載的卡烏克庫魯照片
- 首圖右:皮查伊,Lukasz Kobus(歐盟執委會),2023 年 5 月,Wikimedia Commons,CC BY 4.0,經裁切
- 哈薩比斯:Arthur Petron,2024 年 12 月,Wikimedia Commons,CC BY-SA 4.0,經裁切
- Google 官方部落格圖片:宣傳圖、基準對照表、DeepSWE、AutomationBench、CWE-bench、Gray Swan 長條圖(2026-09-30)
- 網頁截圖(擷取日期 2026-10-01):Google 官方部落格首屏、Gemini 台灣訂閱頁、Gemini API 定價頁、DeepMind Fairwind 頁面、Artificial Analysis 模型頁與評測文章頁
- Arena AI 官方 YouTube〈Gemini 4 Argon | First Impressions〉:嵌入影片
- 終端機畫面:本報導自行在本機執行 agy 的輸出,2026-10-01 10:08(台北時間)
- 影片畫面、官方圖片與截圖僅供報導評論引用,著作權屬原權利人。本文不使用 AI 生成圖片。